1.Введение
«Математическая обработка» — общий вычислительный раздел комплекса «ElectroChemLab». В отличие от остальных разделов он не решает никакой конкретной электрохимической задачи: он готовит данные для них и разбирает то, что они выдали.
Зачем обрабатывать данные
Экспериментальная кривая никогда не является тем, что описывает физико-химическая модель. Между измерением и расчётом всегда стоят четыре обстоятельства, и каждое из них требует отдельной обработки.
- Случайная ошибка измерения. Показание прибора содержит шум; при подстановке в модель он уходит в оцениваемые параметры и раздувает их доверительные интервалы. Отсюда — сглаживание.
- Грубые промахи. Пузырёк газа на электроде, наводка в сети, сбой АЦП дают одиночные точки, не имеющие отношения к сигналу. Метод наименьших квадратов к ним крайне чувствителен: один промах способен увести всю подгонку. Отсюда — устойчивые к выбросам методы обработки.
- Форма представления. Данные из журнала приходят неупорядоченными, в чужой сетке, с неудобным числом знаков. Модель же требует возрастающего аргумента, а иногда — значений в точках, которых в эксперименте не было. Отсюда — сортировка, интерполяция и сплайны.
- Производные и интегралы кривой. Точка эквивалентности титрования, количество электричества, площадь пика — всё это производные или интегралы экспериментальной зависимости. Численное дифференцирование резко усиливает шум ($\sigma\sqrt{2}/h$ у первой производной, $\sigma\sqrt{6}/h^{2}$ у второй), поэтому без предварительного сглаживания оно бессмысленно — настолько, что задача там некорректна по существу, а не по неудачному выбору формулы (8). Интегрирование — операция обратная и по существу: шум входит в сумму со знаками и гасится, так что неопределённость результата падает как $1/\sqrt{n}$, и сглаживать перед ним обычно не нужно (9.3). Отсюда — дифференцирование и интегрирование как отдельные подпункты, опирающиеся на предыдущие.
Структура раздела
Раздел объявлен из восьми подпунктов. Они выстроены по возрастанию требований к данным: каждый следующий обычно опирается на результат предыдущих.
| Подпункт | Что делает | Состояние |
|---|---|---|
| Сортировка | упорядочивает вектор или таблицу по выбранной колонке с переносом строк целиком | реализован — раздел 2 |
| Сглаживание | подавляет шум и грубые промахи, сохраняя форму кривой | реализован — раздел 3 |
| Интерполяция | значения в точках, которых не было в эксперименте: три формы одного многочлена (Лагранж, Ньютон, Эйткен) и его барицентрическая запись, локальные кубики Акимы и монотонный PCHIP, рациональные Тиле и Флотер — Хорманн; производные и обратная задача | реализован — раздел 4 |
| Сплайны | кусочно-полиномиальное описание кривой целиком: восемь видов — от классического кубического до сплайна с натяжением и монотонного, с пятью краевыми условиями | реализован — раздел 5 |
| Аппроксимация | кривая мимо точек: полиномы (в том числе ортогональные), произвольный набор функций, Безье и три сплайновых метода; веса, устойчивость к выбросам, нормы $L^1$ и $L^\infty$, критерии выбора модели | реализован — раздел 6 |
| 2D аппроксимация | то же для поверхности $z(x,y)$ — например, зависимость от состава и температуры сразу: билинейная и бикубическая по сетке, тензорный сплайн со сглаживанием, множественная регрессия со статистикой и двумерный полином | реализован — раздел 7 |
| Дифференцирование | производные экспериментальной кривой — наклон, скорость, теплоёмкость $C_p=-T\,\partial^2G/\partial T^2$, энтальпия по Вант-Гоффу: разностные формулы на любой сетке, локальный многочлен, регуляризованные постановки (в том числе сохраняющая излом) и производные построенных кривых, с оценкой шума данных и неопределённости самой производной | реализован — раздел 8 |
| Интегрирование | определённый интеграл экспериментальной кривой — площадь пика, заряд $Q=\int I\,dt$, тепловой эффект $\Delta H=\int C_p\,dT$: пять правил по таблице, четыре квадратуры по функции и точный интеграл построенной кривой, с неопределённостью результата | реализован — раздел 9 |
Настоящая справка описывает готовые подпункты; по мере появления остальных она будет дополняться разделами той же структуры (изложение метода — как выбирать — работа с программой — литература).
Что общего у всех подпунктов
Все подпункты пользуются одной и той же таблицей, поэтому её поведение одинаково везде:
- строки нумерованы — служебная колонка «№» принадлежит самой таблице;
- вставка (Ctrl+V) наращивает таблицу под размер вставляемого блока: число точек заранее выставлять не нужно;
- копирование (Ctrl+C) отдаёт выделенный блок, а если выделения нет — всю таблицу с заголовками, в формате, который понимает любой табличный редактор;
- отмена (Ctrl+Z) возвращает таблицу к состоянию до последнего изменения: ввода в ячейку, вставки, очистки или перестроения;
- пять форматов показа чисел: четыре фиксированных
(
0.0,0.000,0.0000,0.000000) и плавающий0.000000E+00; - колонки прижаты влево и имеют поля шириной в четыре знака слева и справа.
0.0000, но при возврате к плавающему формату снова показывается
полностью. Если бы формат применялся к тексту ячейки, такое число исчезло бы
навсегда от одного щелчка.
Понимаются все привычные записи числа: десятичная запятая (0,25),
научная запись (1.2E-3) и запись со степенью
(10^-14, 1.2*10^-14).
2.Сортировка
Подпункт упорядочивает данные и работает в двух режимах, переключаемых радиокнопкой вверху окна.
Вектор
Таблица из двух колонок: слева исходная последовательность, справа сортированная. Исходный порядок сохраняется намеренно — по нему потом сверяются с лабораторным журналом, и он же нужен, если сортировка была промежуточным шагом.
Массив
Таблица произвольной ширины, сортировка по выбранной колонке, причём переставляются строки целиком. Это принципиально: если переставлять только колонку-ключ, связь между колонками одной строки теряется и таблица рассыпается. Технически сортируется не сам массив, а перестановка номеров строк, которая затем применяется ко всем колонкам сразу. Таблицу можно переключать между исходной и сортированной — обе существуют одновременно, ничего не теряется.
Правила сравнения
Они общие для обоих режимов и для всего раздела:
| Случай | Как сравниваются |
|---|---|
| Обе ячейки числовые | как числа (а не как строки: «2» меньше «10») |
| Обе нечисловые | по алфавиту, без учёта регистра — это и есть «А → Я» |
| Смешанная пара | число считается меньше текста |
| Пустая ячейка | всегда в конец, независимо от направления |
Пустые ячейки уходят вниз и при сортировке по убыванию тоже: отсутствие данных не должно возглавлять таблицу.
Работа с окном
Файл подпункта — *.srt.xml (по общему правилу комплекса тип
задачи стоит в имени файла).
Литература к разделу
- [1] Knuth D. E. The Art of Computer Programming. Vol. 3: Sorting and Searching. 2nd ed. — Reading, MA: Addison-Wesley, 1998. — §5.2. Понятие устойчивости сортировки и её значение при упорядочении записей по одному полю.
3.Сглаживание
Измеренная величина складывается из полезного сигнала и случайной ошибки:
Задача сглаживания — восстановить $f$, то есть подавить $\varepsilon$, не исказив сигнал. Обе части этого требования существенны, и они противоречат друг другу: любой фильтр, гасящий шум, в той или иной мере срезает и сигнал. Поэтому единственно правильного метода не существует, и подпункт даёт тринадцать — с разными предположениями о том, что именно считать «гладким».
Зачем это нужно именно в электрохимии
- Перед расчётом. Шум в исходных точках проходит через всю цепочку «спесиация → модель → оптимизация» и попадает в доверительные интервалы параметров. Разумное сглаживание сужает их, чрезмерное — систематически смещает.
- Перед дифференцированием. Численная производная усиливает шум: у разностной производной СКО равно $\sigma\sqrt{2}/h$, у второй — $\sigma\sqrt{6}/h^{2}$. При $\sigma = 0{,}2$ мВ и $h = 0{,}1$ мл это $2{,}8$ и $49$ мВ/мл — на кривой титрования вне скачка такой «пик» ничем не отличается от настоящего. Сглаживание здесь не удобство, а необходимость.
- После расчёта. Сглаживание рассчитанных кривых помогает увидеть форму зависимости, не отвлекаясь на численный шум решателя.
Два класса методов по отношению к сетке
Часть методов пользуется реальными абсциссами $x_i$, часть работает по номерам точек. На равномерной сетке разницы нет, на сгущённой — есть, и она не косметическая: сеточный фильтр в области сгущения сглаживает физически более узкий участок, чем в разреженной.
| Пользуются $x$ | Работают по номерам точек |
|---|---|
| по 3 и по 5 точкам, Савицкий — Голей, LOWESS, гауссово ядро, Чайкин, сглаживающий сплайн | скользящее среднее, биномиальное, медиана, Тьюки 4253H, Уиттакер — Хендерсон, TVD |
Обработка краёв
Края — место, где фильтры чаще всего врут. Принято одно правило для скользящих окон: окно у краёв симметрично сужается, вплоть до одной точки в первой и последней. Крайние значения при этом остаются на месте. Две распространённые альтернативы отвергнуты сознательно: «повторить крайнее значение» (обрезка индекса) заваливает концы кривой и особенно портит производную, а «не считать края вовсе» рвёт таблицу. У Савицкого — Голея край устроен точнее — там окно сдвигается, а полином вычисляется в нецентральной позиции.
3.1.Методы сглаживания— щёлкните заголовок, чтобы свернуть
Тринадцать методов сгруппированы по назначению. Параметры каждого появляются в окне только после выбора метода; у трёх методов параметров нет вовсе.
| Группа | Методы | Что даёт |
|---|---|---|
| Линейные фильтры | скользящее среднее, по 3 и 5 точкам, биномиальное, Савицкий — Голей, гауссово ядро, Уиттакер — Хендерсон, сплайн | предсказуемы, для них определён GCV — численный критерий силы сглаживания |
| Устойчивые к выбросам | медиана, Тьюки 4253H, LOWESS | единственные, кто одиночный промах убирает, а не размазывает |
| Сохраняющий скачок | TVD | гасит шум, не размазывая ступеньку |
| Геометрический | Чайкин | сглаживает ломаную как кривую, а не как функцию |
3.1.1. Скользящее усреднение линейный
Среднее по симметричному окну шириной $w = 2m+1$:
Простейший и самый прозрачный фильтр: подавляет шум в $\sqrt{w}$ раз и точно воспроизводит прямую. Его недостаток — «прямоугольная» весовая функция, спектр которой имеет боковые лепестки: на резких участках кривая приобретает характерное «звенение». Биномиальное сглаживание (3.1.3) свободно от этого при той же простоте[5].
Параметр: ширина окна (нечётная).
3.1.2. Сглаживание по 3 и по 5 точкам линейный
Классические формулы, приводимые во всех руководствах по обработке наблюдений[1]. По три точки:
По пять точек:
В программе обе формулы реализованы не таблицей коэффициентов, а локальной подгонкой полинома по реальным абсциссам: на равномерной сетке результат тождественно совпадает с приведёнными формулами (это проверяется тестами до десяти знаков), а на неравномерной остаётся правильным, тогда как табличные коэффициенты там уже неверны.
Параметров нет.
3.1.3. Биномиальное сглаживание линейный
$k$-кратное применение простейшей свёртки
После $k$ проходов веса образуют биномиальный набор ширины $2k+1$, а по центральной предельной теореме ядро стремится к гауссову с $\sigma \approx \sqrt{k/2}$ шага сетки. Отсюда его достоинство: спектр монотонно спадает, боковых лепестков нет, и «звенения» скользящего среднего не возникает[5]. Края обрабатываются отражением ряда.
Параметр: число проходов.
3.1.4. Скользящая медиана устойчивый
$\hat y_i$ — медиана значений в окне[6]. Метод нелинеен, и в этом весь смысл: одиночный выброс он убирает полностью, не задев соседей, тогда как любой линейный фильтр распределяет выброс по всему окну, то есть портит вместе с одной точкой ещё $w-1$.
Параметр: ширина окна. Окно 3 убирает одиночный выброс, окно 5 — два подряд.
3.1.5. Композиция Тьюки «4253H, twice» устойчивый
Последовательность медиан по 4, 2, 5 и 3 точкам, затем ханнинг $(1,2,1)/4$, затем то же самое, применённое к остатку, с возвратом его в результат[6][7].
Пара «4» и «2» стоит в названии рядом не случайно: медиана по чётному числу точек относится к полуцелой позиции $i-\tfrac12$, и следующая за ней медиана по двум точкам возвращает результат на узлы сетки. Концы ряда обрабатываются по правилу Тьюки (значение переносится без изменения)[8], поэтому первая и последняя точки кривой остаются ровно там, где были.
Приставка «twice» означает повторную обработку остатка $r = y - \hat y$: то, что медианы срезали как «шум», но что на самом деле было сигналом, в остатке окажется гладким, переживёт второе сглаживание и вернётся в кривую. Приём восстанавливает пики, которые чистая медиана срезает.
Параметров нет — этим композиция и ценна: устойчивость получается без выбора окна и без подбора $\lambda$.
3.1.6. Фильтр Савицкого — Голея линейный
В скользящем окне методом наименьших квадратов подгоняется полином степени $d$, и значением в точке считается значение этого полинома[2]:
Главное достоинство перед скользящим средним — сохранение формы: полином второй и третьей степени воспроизводит максимум, минимум и перегиб, тогда как среднее их занижает и уширяет. Из того же полинома аналитически берутся производные (используется в аналитическом разделе титрования).
Реализация здесь — общая, по Горри[4]: полином любой степени, производная любого порядка и вычисление в любой точке окна, а не только в центральной. Отсюда три отличия от табличной формы:
- сетка не обязана быть равномерной — подгонка идёт по реальным $x_i$;
- края считаются собственной несимметричной строкой (окно прижимается к краю, полином вычисляется в нецентральной позиции), а не обрезкой индекса;
- производная берётся с факториалом: $d^{m}/dx^{m}\sum a_j u^{j}$ даёт $j!/(j-m)!$, поэтому вторая производная содержит множитель $2!$. Если взять за неё сам коэффициент $a_2$, величина выйдет ровно вдвое меньше истинной.
Параметры: ширина окна и степень полинома (степень должна быть меньше окна). Печатные таблицы исходной статьи содержали опечатки, исправленные позднее[3]; здесь коэффициенты не берутся из таблиц, а вычисляются, поэтому вопрос не возникает.
3.1.7. LOWESS — робастная локальная регрессия устойчивый
В каждой точке строится прямая по $q$ ближайшим соседям с трикубическим весом[9]:
Затем несколько раз пересчитываются бивеса по остаткам: точка, отстоящая от локальной прямой более чем на шесть медианных модулей остатка, полностью теряет вес.
Так метод сам гасит выбросы, не требуя искать их вручную. Расстояния берутся по реальным $x$, поэтому окно физически одинаково по обе стороны от точки, а не «столько же номеров». Развитие метода на полиномы высших степеней и на несколько переменных известно как LOESS[10].
Параметры: доля точек в окне $f$ и число робастных итераций (0 — обычная локальная регрессия без защиты от выбросов).
3.1.8. Гауссово ядро (Надарая — Ватсон) линейный
Взвешенное среднее с гауссовым весом[11][12]:
Ширина $\sigma$ задаётся в единицах $x$, а не в точках, поэтому метод одинаково ведёт себя на равномерной и сгущённой сетке — это его главное отличие от оконных фильтров. Значение $\sigma = 0$ означает автоматический подбор: полтора медианных шага сетки.
Параметр: $\sigma$ в единицах X (0 — подобрать).
3.1.9. Алгоритм Чайкина геометрический
Каждая итерация заменяет звено ломаной двумя точками на четверти и трёх четвертях его длины[13]:
Предел этой последовательности — равномерный квадратичный B-сплайн[14]; после трёх-четырёх итераций кривая от него уже неотличима. Концы ломаной сохраняются.
Параметр: число срезаний углов.
3.1.10. Уиттакер — Хендерсон линейный
Вместо локального окна ищется вся кривая сразу как компромисс между близостью к данным и гладкостью[15][16]:
Задача линейна, и решение находится из системы
где $\mathbf{D}$ — матрица разностей порядка $d$. Матрица симметрична и ленточна (полуширина $d$), поэтому система решается ленточным разложением Холецкого за $O(n d^{2})$ — линейно по числу точек. Современная матричная формулировка и практические рекомендации — у Эйлерса[17].
Смысл предельных случаев (они же служат проверкой реализации):
| Значение | Результат |
|---|---|
| $\lambda = 0$ | исходные данные без изменений |
| $\lambda \to \infty$ | полином степени $d-1$ по МНК (при $d=2$ — прямая) |
Порядок $d$ задаёт, что считать «гладким»: $d=1$ тянет к горизонтали, $d=2$ (обычный выбор) — к прямой, $d=3$ — к параболе.
Метод сеточный: разности берутся по номерам точек. На сильно неравномерной сетке физически правильнее сглаживающий сплайн — его непрерывный аналог.
3.1.11. Сглаживающий кубический сплайн линейный
Непрерывный аналог предыдущего метода: штрафуется не разность, а интеграл от квадрата второй производной[18]:
Решением является естественный кубический сплайн. В реализации использован алгоритм Райнша[19]: с трёхдиагональной матрицей $\mathbf{R}$ и почти трёхдиагональной $\mathbf{Q}$ решается
система пятидиагональная и решается тем же ленточным Холецким. Поскольку штраф берётся по $x$, а не по номерам точек, метод корректен на неравномерной сетке — в этом его практическое преимущество перед Уиттакером — Хендерсоном.
| Значение | Результат |
|---|---|
| $\lambda \to 0$ | интерполяция: кривая проходит через все точки |
| $\lambda \to \infty$ | прямая по МНК (вторая производная зануляется) |
Параметр: $\lambda$.
3.1.12. Сглаживание по полной вариации (TVD) сохраняет скачок
Единственный метод подпункта, штрафующий модуль разности, а не её квадрат[20]:
Задача негладкая, поэтому решается мажорантной минимизацией: модуль заменяется на $\Delta^2/|\Delta_{\text{пред}}|$, что даёт последовательность трёхдиагональных систем[21]
Нижняя отсечка $\epsilon$ делает задачу гладкой (штраф Хубера): при $\epsilon\to0$ это классическая TV со ступенчатым решением, при большем $\epsilon$ ступеньки скругляются. Отсечка взята долей размаха данных, поэтому метод не зависит от единиц измерения. Существует и точный одномерный алгоритм за $O(n)$[22]; здесь он не применён сознательно — его решение строго кусочно-постоянное, что для гладких физико-химических зависимостей выглядит как искусственная лестница, тогда как мажорантная схема с $\epsilon$ даёт «сглаженную TV».
Параметры: $\lambda$ и число итераций минимизации (обычно 40–80).
3.2.Как выбирать метод
Различают варианты величины, которые платят за израсходованную гибкость. Все они считаются программой и сведены на вкладке «Характеристики».
Эффективное число степеней свободы и GCV
Всякий линейный фильтр можно записать как $\hat{\vec y} = \mathbf{H}\vec y$. След этой матрицы — сколько параметров фильтр фактически потратил: у скользящего среднего по 5 точкам $\operatorname{tr}\mathbf{H}\approx n/5$, у интерполяции $\operatorname{tr}\mathbf{H} = n$. Обобщённая кросс-проверка штрафует за них[23][24]:
В отличие от СКО, GCV имеет минимум по силе сглаживания: при слабом сглаживании велик знаменатель штрафа, при сильном — числитель. Этот минимум и есть ответ на вопрос «сколько сглаживать». Практически: примените метод с несколькими значениями параметра, каждый раз получая свою колонку, и выберите наименьший GCV.
След вычисляется численно — прогоном самого фильтра по единичным векторам. Это честно (учитываются и краевые строки, где вес точки в самой себе больше) и не требует знать внутренности метода, но стоит $n$ прогонов; при большом числе точек вместо точного следа берётся стохастическая оценка[25] с фиксированным зерном, поэтому результат воспроизводим от запуска к запуску.
Автокорреляция остатков и число смен знака
Признак, работающий и для нелинейных методов. Если фильтр снял только шум, остаток $r_i = y_i-\hat y_i$ похож на белый шум: автокорреляция со сдвигом 1 около нуля, а число смен знака около $(n-1)/2$.
Заметная положительная автокорреляция и число смен знака существенно меньше половины означают, что в остатке лежит гладкий сигнал, то есть кривая пересглажена. Это классическая проверка серийной корреляции остатков[26].
Сравнение с паспортным шумом прибора
Если в поле «Паспортный шум прибора $\sigma$» введена величина из документации (например 0,2 мВ для потенциометра), программа сравнивает с ней СКО остатка:
- СКО много больше паспортного шума — срезан сигнал, а не шум;
- СКО много меньше — сглаживание почти ничего не сняло.
Максимум отклонения и его положение
Программа печатает $\max|\Delta|$ и абсциссу, на которой он достигнут. На кривой со скачком максимум почти всегда садится на скачок. Если он приблизился к высоте самого скачка — окно слишком широкое, и скачок разрушен.
3.3.Работа с программой
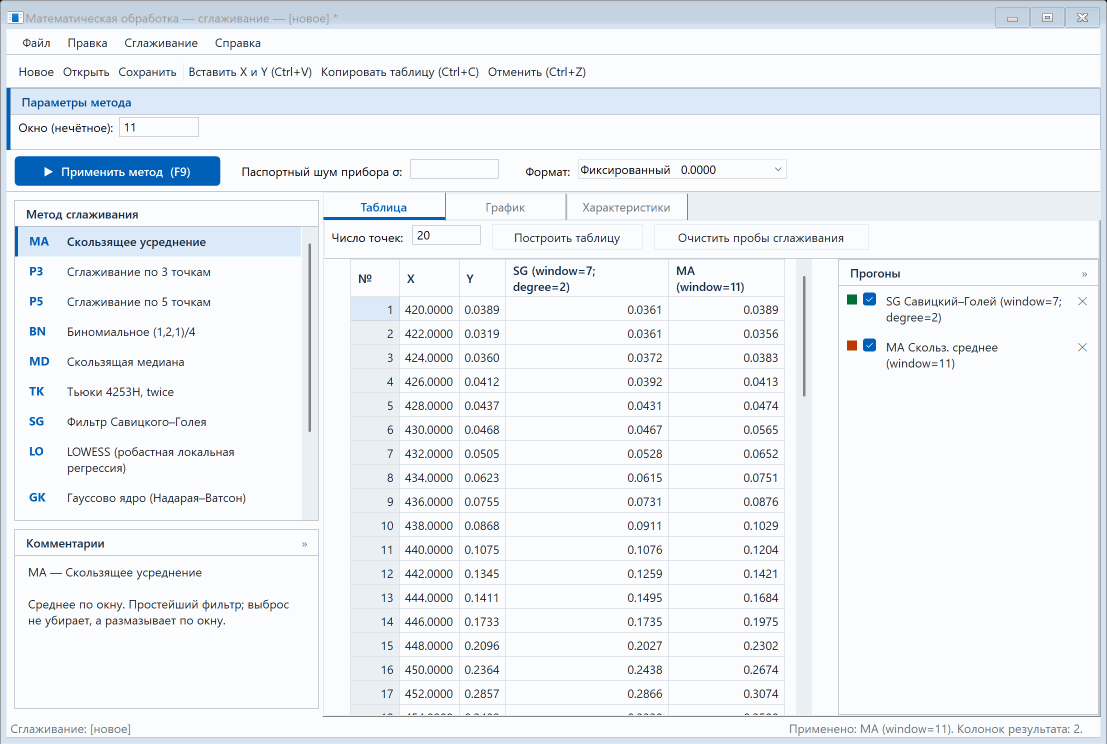
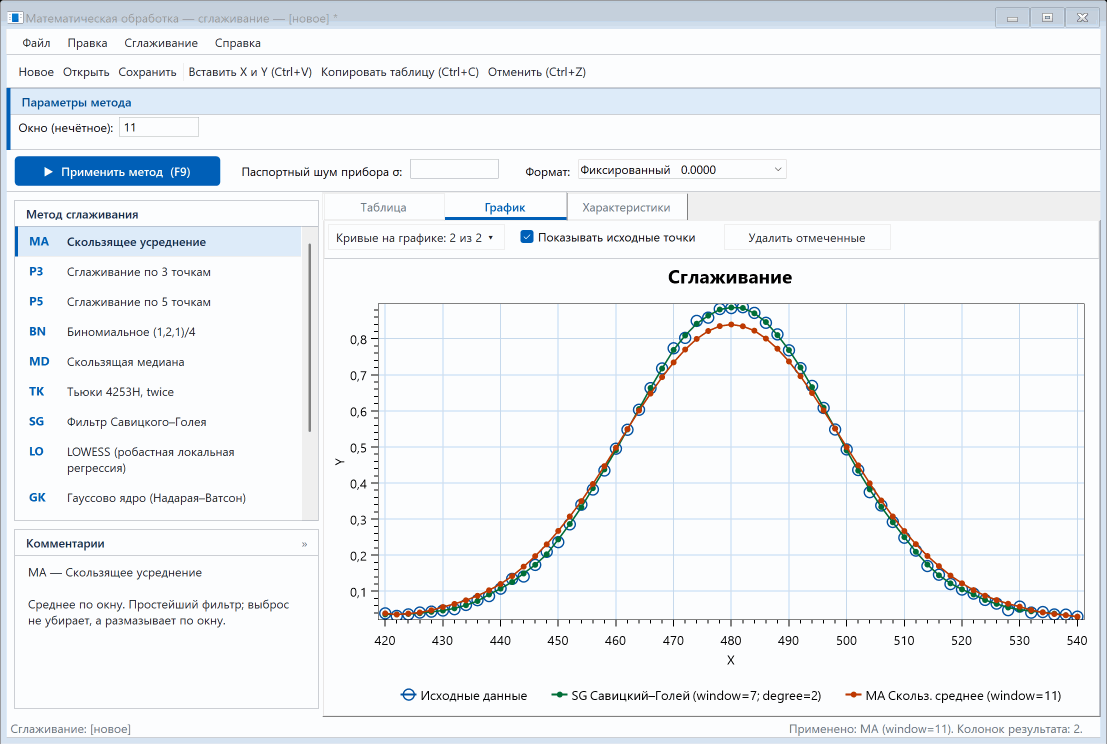
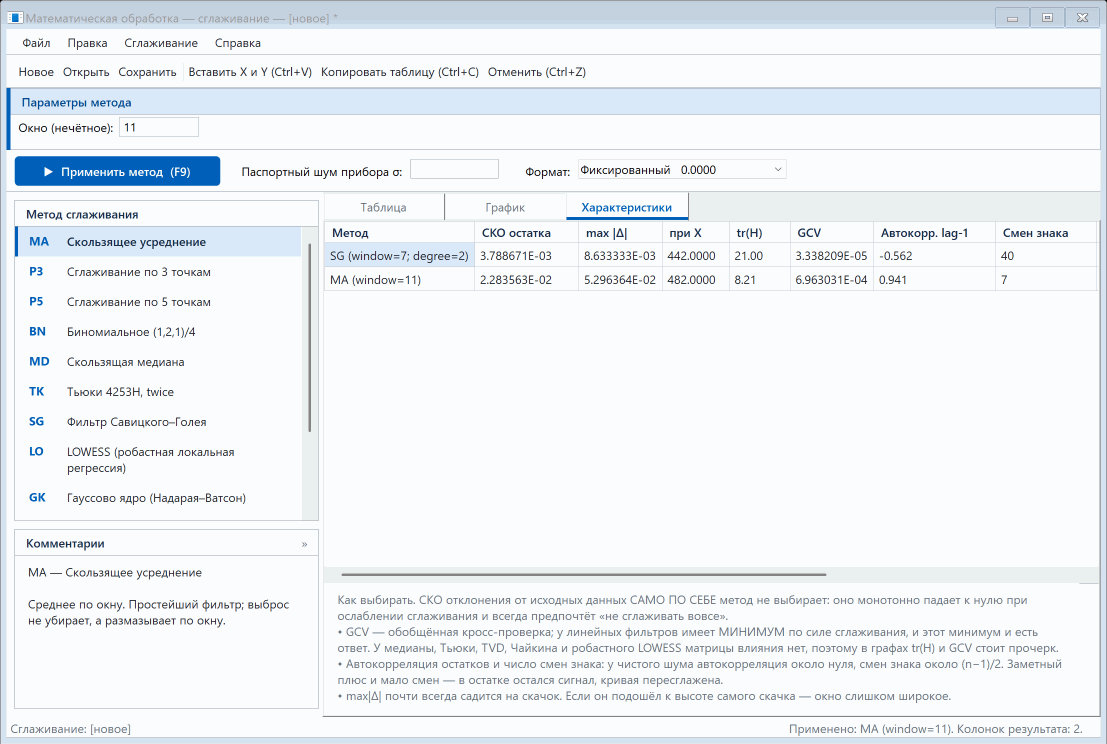
*.smt.xml — хранит рецепт, а не числа.
В него записываются метод и его параметры, а сглаженные колонки восстанавливаются
пересчётом при открытии. Так файл не может разойтись с алгоритмом: открыв старый
проект, вы увидите ровно ту кривую, которую программа строит сегодня.
3.4.Литература
Ссылки в тексте подраздела даны номерами в квадратных скобках. Порядок — тематический: классические формулы, устойчивые методы, локальная регрессия и ядра, геометрия, регуляризация, критерии выбора.
Классические формулы и Савицкий — Голей
- [1] Whittaker E. T., Robinson G. The Calculus of Observations: A Treatise on Numerical Mathematics. — London: Blackie & Son, 1924. — 415 p. Классические «сглаживания по 3, 5, 7 точкам» и общая постановка задачи graduation. Источник формул 3.1.2. Постранично доступна: archive.org.
- [2] Savitzky A., Golay M. J. E. Smoothing and Differentiation of Data by Simplified Least Squares Procedures. — Anal. Chem., 1964, vol. 36, no. 8, p. 1627–1639. Оригинальная статья: сглаживание и производные из одного локального полинома, таблицы коэффициентов для равномерной сетки.
- [3] Steinier J., Termonia Y., Deltour J. Comments on Smoothing and Differentiation of Data by Simplified Least Squares Procedure. — Anal. Chem., 1972, vol. 44, no. 11, p. 1906–1909. Исправление опечаток в печатных таблицах [2].
- [4] Gorry P. A. General Least-Squares Smoothing and Differentiation by the Convolution (Savitzky–Golay) Method. — Anal. Chem., 1990, vol. 62, no. 6, p. 570–573. Общий вывод для любой степени, любого порядка производной и любой точки окна — именно эта форма реализована в программе и она обосновывает собственные краевые строки.
- [5] Marchand P., Marmet L. Binomial smoothing filter: A way to avoid some pitfalls of least-squares polynomial smoothing. — Rev. Sci. Instrum., 1983, vol. 54, no. 8, p. 1034–1041. Биномиальный фильтр 3.1.3 и разбор спектральных недостатков скользящего среднего.
Устойчивые к выбросам методы
- [6] Tukey J. W. Exploratory Data Analysis. — Reading, MA: Addison-Wesley, 1977. — 688 p. Скользящие медианы, композиции вида 3R и 4253H, приём «twice» (повторная обработка остатка). Основа 3.1.4 и 3.1.5. Постранично доступна: archive.org.
- [7] Velleman P. F. Definition and Comparison of Robust Nonlinear Data Smoothing Algorithms. — J. Amer. Statist. Assoc., 1980, vol. 75, no. 371, p. 609–615. Строгие определения композиций медиан и их сравнение.
- [8] Velleman P. F., Hoaglin D. C. Applications, Basics and Computing of Exploratory Data Analysis. — Boston: Duxbury Press, 1981. — 354 p. Рабочие алгоритмы 4253H и правила обработки концов ряда.
- [9] Cleveland W. S. Robust Locally Weighted Regression and Smoothing Scatterplots. — J. Amer. Statist. Assoc., 1979, vol. 74, no. 368, p. 829–836. Оригинальный LOWESS: трикубический вес, бивеса Тьюки, итерации по остаткам. Основа 3.1.7.
- [10] Cleveland W. S., Devlin S. J. Locally Weighted Regression: An Approach to Regression Analysis by Local Fitting. — J. Amer. Statist. Assoc., 1988, vol. 83, no. 403, p. 596–610. Развитие (LOESS): полиномы высших степеней, несколько переменных, эффективное число степеней свободы.
Ядерное сглаживание
- [11] Надарая Э. А. Об оценке регрессии. — Теория вероятностей и её применения, 1964, т. 9, вып. 1, с. 157–159. (англ. изд.: Nadaraya E. A. On Estimating Regression. — Theory Probab. Appl., 1964, vol. 9, no. 1, p. 141–142.)
- [12] Watson G. S. Smooth Regression Analysis. — Sankhyā, Series A, 1964, vol. 26, no. 4, p. 359–372. Вторая, независимая работа с той же оценкой; отсюда название «оценка Надарая — Ватсона». Основа 3.1.8.
Геометрическое сглаживание
- [13] Chaikin G. M. An algorithm for high-speed curve generation. — Computer Graphics and Image Processing, 1974, vol. 3, no. 4, p. 346–349. Оригинальный алгоритм срезания углов. Основа 3.1.9.
- [14] Riesenfeld R. F. On Chaikin's algorithm. — Computer Graphics and Image Processing, 1975, vol. 4, no. 3, p. 304–310. Доказательство, что предел последовательности — равномерный квадратичный B-сплайн.
Регуляризация: разности, сплайны, полная вариация
- [15] Whittaker E. T. On a New Method of Graduation. — Proceedings of the Edinburgh Mathematical Society, 1922, vol. 41, p. 63–75. Постановка «близость к данным + штраф на разности».
- [16] Henderson R. A New Method of Graduation. — Transactions of the Actuarial Society of America, 1924, vol. 25, p. 29–40. Актуарная форма того же метода; отсюда двойное название. Основа 3.1.10.
- [17] Eilers P. H. C. A Perfect Smoother. — Anal. Chem., 2003, vol. 75, no. 14, p. 3631–3636. Современная матричная запись Уиттакера — Хендерсона, ленточное решение и выбор $\lambda$ по кросс-проверке.
- [18] Schoenberg I. J. Spline Functions and the Problem of Graduation. — Proc. Natl. Acad. Sci. USA, 1964, vol. 52, no. 4, p. 947–950. Сглаживающий сплайн как решение вариационной задачи.
- [19] Reinsch C. H. Smoothing by Spline Functions. — Numerische Mathematik, 1967, vol. 10, no. 3, p. 177–183; продолжение — 1971, vol. 16, no. 5, p. 451–454. Алгоритм, реализованный в 3.1.11 (матрицы $\mathbf{Q}$ и $\mathbf{R}$, ленточная система).
- [20] Rudin L. I., Osher S., Fatemi E. Nonlinear total variation based noise removal algorithms. — Physica D, 1992, vol. 60, no. 1–4, p. 259–268. Оригинальная постановка TV-регуляризации. Основа 3.1.12.
- [21] Geman D., Reynolds G. Constrained Restoration and the Recovery of Discontinuities. — IEEE Trans. Pattern Anal. Mach. Intell., 1992, vol. 14, no. 3, p. 367–383. Полуквадратичная (мажорантная) минимизация — именно та схема, по которой TVD решается в программе.
- [22] Condat L. A Direct Algorithm for 1-D Total Variation Denoising. — IEEE Signal Processing Letters, 2013, vol. 20, no. 11, p. 1054–1057. Точный алгоритм за $O(n)$. В программе не используется: его решение строго кусочно-постоянно (см. 3.1.12).
Критерии выбора силы сглаживания
- [23] Craven P., Wahba G. Smoothing noisy data with spline functions: estimating the correct degree of smoothing by the method of generalized cross-validation. — Numerische Mathematik, 1979, vol. 31, no. 4, p. 377–403. Обобщённая кросс-проверка для сглаживающих сплайнов.
- [24] Golub G. H., Heath M., Wahba G. Generalized Cross-Validation as a Method for Choosing a Good Ridge Parameter. — Technometrics, 1979, vol. 21, no. 2, p. 215–223. Формула GCV в том виде, в каком она печатается программой.
- [25] Hutchinson M. F. A stochastic estimator of the trace of the influence matrix for Laplacian smoothing splines. — Communications in Statistics — Simulation and Computation, 1989, vol. 18, no. 3, p. 1059–1076. Оценка следа матрицы влияния случайными знаками $\pm1$ — применяется при большом числе точек вместо точного вычисления.
- [26] Durbin J., Watson G. S. Testing for Serial Correlation in Least Squares Regression. I, II. — Biometrika, 1950, vol. 37, p. 409–428; 1951, vol. 38, p. 159–178. Проверка серийной корреляции остатков — обоснование графы «автокорреляция lag-1».
4.Интерполяция
Даны $n+1$ узлов — пар $(x_j;\,y_j)$ с различными и упорядоченными абсциссами. Требуется значение в точке $x$, которой в эксперименте не было. Кривая, решающая эту задачу, обязана пройти через все узлы:
Задача эта древняя: её решали ещё в античной астрономии, и единая история — от вавилонских таблиц до современной обработки сигналов — собрана в обзоре Мейеринга[21].
Интерполяционный многочлен единствен
Через $n+1$ узлов с различными абсциссами проходит ровно один многочлен степени не выше $n$. Отсюда следует то, что при первом знакомстве выглядит неожиданно: формула Лагранжа, разделённые разности Ньютона, схема Эйткена и барицентрическая запись дают одно и то же число. Это не совпадение и не погрешность реализации — это одна функция, записанная четырьмя способами. Различаются они ценой, устойчивостью и тем, что каждая форма даёт «в придачу»:
| Форма | Цена на одну точку | Что даёт сверх значения |
|---|---|---|
| Лагранж | $O(n^2)$ | ничего; зато формула видна целиком |
| Ньютон | $O(n^2)$ на таблицу, $O(n)$ на точку | явные коэффициенты; добавление узла — один столбец |
| Эйткен | $O(n^2)$ | таблицу приближений растущей степени и оценку погрешности |
| Барицентрическая | $O(n^2)$ на веса, $O(n)$ на точку | численную устойчивость |
Проверить это можно прямо в окне: примените LG со степенью $M = n-1$, затем NW с той же степенью и BL — три колонки совпадут во всех печатаемых знаках.
Девять методов подпункта
Методы разделены на три семейства, и различие между ними определяет поведение на реальных данных, а не только вид формулы.
| Код | Метод | Семейство | Параметры | Производные |
|---|---|---|---|---|
| LG | многочлен Лагранжа | многочлен, окно $M+1$ узлов | степень $M$ | аналитически |
| NW | Ньютон, разделённые разности | многочлен, окно $M+1$ узлов | степень $M$ | аналитически |
| AT | схема Эйткена | многочлен, останов по точности | точность останова | аналитически |
| BL | барицентрическая форма Лагранжа | многочлен по всем узлам | нет | аналитически |
| AK | Акима, 1970 | локальная кубика | нет | аналитически |
| AM | Акима, 1991 (makima) | локальная кубика | нет | аналитически |
| PC | PCHIP, монотонная кубическая | локальная кубика | нет | аналитически |
| TH | рациональная Тиле (Булирш — Штёр) | цепная дробь | узлов в окне | численно |
| FH | Флотер — Хорманн, без полюсов | барицентрическая рациональная | параметр $d$ | аналитически |
4.1.Методы интерполяции— щёлкните заголовок, чтобы свернуть
4.1.1. Многочлен Лагранжа многочлен
Классическая запись через базисные многочлены:
Формула появилась у Уоринга в 1779 году[1], за шестнадцать лет до лекций Лагранжа[2], чьим именем её называют; разбор приоритета — у Гаучи[3]. Она прозрачна, но имеет два известных недостатка: требует заметного объёма вычислений ($O(n^2)$ на каждую точку, и добавление одного узла заставляет считать всё заново) и непредсказуемо ведёт себя между узлами при большой степени — см. 4.2.
Поэтому здесь многочлен строится не по всей таблице, а по $M+1$ ближайшим к $x$ узлам: окно центрируется на точке и прижимается к краям таблицы. При $M = 1$ это обычная ломаная по соседним узлам, при $M = 3$ — кубика, при $M = n-1$ — глобальный многочлен со всеми его бедами.
Параметр: степень $M$ (по умолчанию 3). При $M \ge 8$ окно предупреждает о явлении Рунге.
4.1.2. Ньютон: разделённые разности многочлен
Тот же многочлен, записанный по возрастающим степеням «расстояний до узлов»:
Преимущество формы — явные коэффициенты и дешёвое добавление узла: новый узел даёт один новый столбец таблицы разностей и одно новое слагаемое, всё прежнее остаётся. Именно этой формой в программе берутся производные: вложенная схема Горнера даёт значение и обе производные за один проход, точно, без разностной аппроксимации.
Параметр: степень $M$ — как у LG, и результат совпадает с LG.
4.1.3. Схема Эйткена многочлен
Итерационное построение того же многочлена без вычисления разностей: значения в столбце последовательно пересчитываются по двум[4]
После шага $j$ величина $Y_{j+1}$ есть значение интерполяционного многочлена степени $j$, построенного по первым $j+1$ узлам. То есть таблица даёт последовательность приближений растущей степени, а разность соседних — бесплатную оценку достигнутой погрешности. Это и есть настоящее преимущество схемы: степень не надо задавать заранее, вычисление останавливается по точности. Близкий родственник — схема Невилла[5], отличающаяся лишь порядком выбора опорного узла; в литературе алгоритм часто зовут «Эйткена — Невилла».
Чтобы приближения действительно улучшались, узлы здесь упорядочены по удалённости от точки $x$: ближний узел входит первым. Цена схемы — $O(n^2)$ на каждую точку и отсутствие коэффициентов многочлена.
Параметр: точность останова. 0 — использовать все узлы; тогда результат совпадает с BL и подпадает под предупреждение о явлении Рунге.
4.1.4. Барицентрическая форма Лагранжа многочлен
Тот же многочлен во «второй барицентрической» записи:
Веса $w_j$ зависят только от узлов и считаются один раз; после этого каждая новая точка стоит $O(n)$ вместо $O(n^2)$. Форма Берро — Трефетена[10] вдобавок обратно устойчива[11] — этим она и заменяет прямую формулу Лагранжа. Предшественник — замкнутые веса Зальцера на чебышёвских узлах[12].
В самой точке $x = x_j$ формула вырождается ($0/0$); значение там равно $y_j$ по определению, а производные берутся по строкам матриц дифференцирования, справедливым для любого барицентрического интерполянта:
Параметров нет: строится по всем узлам таблицы.
4.1.5. Акима, 1970 локальная кубика
На каждом отрезке $[x_i;\,x_{i+1}]$ строится кубика Эрмита — она определяется значениями и наклонами в двух концах. Весь метод состоит в том, как выбрать наклон в узле. Обозначим разности $\Delta_i = (y_{i+1}-y_i)/(x_{i+1}-x_i)$; тогда[6]
Смысл весов виден сразу: там, где кривая ведёт себя спокойно, соответствующая разность разностей мала, и резкое изменение по одну сторону узла не проникает по другую. Отсюда главное свойство метода: одна выбившаяся точка не «раскачивает» кривую на весь диапазон, как это делает обычный кубический сплайн с непрерывной второй производной. Наклон в узле зависит только от четырёх соседних разностей, поэтому метод локален и явлению Рунге не подвержен ни при каком числе точек. По краям недостающие разности экстраполируются самим Акимой: $\Delta_{-1} = 2\Delta_0 - \Delta_1$ и так далее.
Параметров нет. Плата за локальность — вторая производная разрывна в узлах: «на глаз» кривая гладкая, но для задач, где нужна непрерывная кривизна, предназначены сплайны (подпункт 5).
4.1.6. Акима, 1991 — makima локальная кубика
Авторская модификация тех же весов[7]:
Добавка чинит поведение исходного метода на почти линейных участках:
там обе разности разностей близки к нулю, исходные веса вырождаются, и наклон
определяется случайной разницей в последних значащих цифрах — на кривой это
видно как неестественный излом. В MATLAB эта модификация называется
makima.
Параметров нет. Если на ровном участке AK и AM заметно расходятся — верить следует AM.
4.1.7. PCHIP — монотонная кубическая локальная кубика
Та же кубика Эрмита, но наклоны выбираются так, чтобы сохранить монотонность данных. Фрич и Карлсон доказали необходимое и достаточное условие: на отрезке кубика монотонна, если наклоны на его концах лежат в «круге» радиуса $3\Delta_i$[8]. Практическая формула наклонов — взвешенное гармоническое среднее соседних разностей (Фрич и Батленд[9]):
причём при смене знака разностей ($\Delta_{i-1}\Delta_i \le 0$, то есть в локальном экстремуме данных) наклон обнуляется: $m_i = 0$. Гармоническое среднее обращается в нуль, как только один из аргументов близок к нулю, — именно поэтому оно, а не арифметическое.
Параметров нет. Плата за монотонность — порядок точности ниже, чем у кубики общего вида: кубический многочлен PCHIP воспроизводит лишь приближённо, а прямую — точно. Практическая сторона кусочно-полиномиального аппарата, из которого выросли библиотечные реализации PCHIP, изложена у де Бура[23].
4.1.8. Рациональная: Тиле, Булирш — Штёр цепная дробь
Интерполянт — отношение двух многочленов. Классическая запись Тиле — цепная дробь на обратных разностях[14]; вычисляется она таблицей типа Невилла, в которой звенья рациональные, а не полиномиальные (алгоритм Булирша — Штёра[15]):
Рациональная функция умеет то, чего многочлен не умеет в принципе: насыщение и асимптоту. Кривая, выходящая на полку, описывается дробью малого порядка точно, а многочлен вынужден изображать полку колебаниями и тем хуже, чем длиннее участок.
Параметр: число узлов в окне (0 — все). Чем шире окно, тем выше порядок дроби — и тем вероятнее полюс. Это единственный метод подпункта, у которого производные берутся численно (см. 4.3).
4.1.9. Флотер — Хорманн: рациональная без полюсов барицентрическая рациональная
Та же барицентрическая формула, что в 4.1.4, но с другими весами: интерполянт составляется как смесь локальных многочленов степени $d$[16]
Ключевое свойство доказано авторами: при таких весах знаменатель не обращается в нуль ни при каком вещественном $x$, то есть полюсов на вещественной оси нет по построению — при любом $d$ и любом расположении узлов. При этом порядок приближения растёт с $d$, а стоимость точки остаётся $O(n)$. При $d = 0$ получается классическая формула Берро[13] на кусочно-линейной базе.
Параметр: $d$ (по умолчанию 3). Практическое правило: $d$ порядка 3–4 при гладких данных; большие $d$ приближают поведение глобального многочлена и смысла в них немного.
4.2.Явление Рунге
Рунге в 1901 году разобрал функцию, ставшую с тех пор стандартным примером[17]:
и показал, что интерполяционный многочлен по равноотстоящим узлам с ростом их числа не приближается к $f$, а расходится у краёв отрезка: колебания растут неограниченно, тогда как в середине приближение улучшается. Точная граница сходимости $|x| \approx 0{,}7266$ разобрана Эппeрсоном[18].
- если узлы выбираем мы (планируем эксперимент) — сгущать их к краям (узлы Чебышёва[19]), и тогда эффекта нет;
- если узлы даны экспериментом и они равномерны — не поднимать степень, а пользоваться кусочными методами (AK, AM, PC) или FH.
Окно предупреждает об этом прямо при выборе метода: у LG и NW — когда степень достигает 8, у AT — когда точность останова не задана и узлов десять и более, у BL — когда узлов десять и более. Предупреждение появляется полосой над строкой действия и исчезает, как только опасность снята.
Убедиться в эффекте можно за минуту: введите $1/(1+25x^2)$ на 21 равноотстоящем узле от $-1$ до $1$, постройте сетку аргументов и примените BL и PC. У края (около $x = \pm0{,}95$) BL ошибётся более чем на единицу — то есть больше, чем сам размах функции, — а PC останется в пределах нескольких сотых.
Это не только учебный пример. В разборе примера то же самое случается на семнадцати точках справочника: многочлен по всем узлам проходит через каждый из них точно и между ними ошибается на 25 мВ при размахе таблицы 71 мВ. Там же измерено, чем это вызвано, — усилением погрешности узлов в $2{,}8{\cdot}10^{4}$ раз.
4.3.Производные интерполянта
Переключатель «Выводить» задаёт, что считается: функция, первая или вторая производная. Считается производная самого интерполянта — той кривой, которая построена по узлам, — а не разностная производная исходной таблицы. Разница существенна: разностная производная определена только в узлах и усиливает шум (у первой СКО равно $\sigma\sqrt{2}/h$, у второй — $\sigma\sqrt{6}/h^{2}$), а производная интерполянта определена в любой точке отрезка.
| Методы | Как берётся производная |
|---|---|
| LG, NW, AT | точно: вложенная схема Горнера для формы Ньютона даёт значение и обе производные за один проход |
| BL, FH | точно: правило частного для $N/D$, а в самих узлах — строки матриц дифференцирования |
| AK, AM, PC | точно: кубика на отрезке дифференцируется явно |
| TH | численно: центральная разность по интерполянту с шагом $h = 10^{-3}$ размаха данных (у края отрезка — односторонняя трёхточечная) |
Порядок производной меняет и таблицу, и график целиком. Исходные узлы на график в этом режиме не выводятся: ординаты узлов и значения производной — величины разной размерности, и одна шкала для них была бы обманом; галочка «Показывать исходные узлы» при этом гаснет.
4.4.Обратная интерполяция
Обратная задача — найти $x$ по заданному $y$. Решается она тем же аппаратом: роли столбцов меняются местами, узлами становятся пары $(y_j;\,x_j)$, и по ним строится интерполянт $x(y)$. Схема Эйткена[4] прямо оговаривает такую перестановку; как рабочий инструмент поиска корня обратная квадратичная интерполяция известна по алгоритму zeroin Брента[22]; сходимость методов, построенных на обратной интерполяции, исследована Островским[25].
Для потенциометрического титрования это прямой рабочий инструмент: точка эквивалентности — значение объёма при заданном потенциале, то есть интерполяция $V(E)$ вместо $E(V)$. Она смыкается с методом $\Delta V/\Delta E$ — первым методом Грана, — который в разделе «Потенциометрическое титрование ▸ Анализ» построен на той же перестановке ролей.
4.5.Как выбирать метод
В отличие от сглаживания, здесь нет численного критерия вроде GCV: все девять кривых проходят через узлы точно, и «невязка» у всех равна нулю. Выбор поэтому определяется тем, что известно о самой зависимости, а не тем, что показывает таблица.
| Задача | Метод | Почему |
|---|---|---|
| Данные из эксперимента, форма заранее не известна | PC, при сомнении рядом AK | монотонность сохраняется, лишние экстремумы не появляются |
| Кривая титрования, кондуктограмма — нужна производная | PC или AM | локальность: скачок не «раскачивает» кривую по всему диапазону |
| Сгущение таблицы гладкой расчётной кривой | BL или FH | точность выше при том же числе узлов; шума в расчётной кривой нет |
| Зависимость с насыщением или асимптотой | FH, для сравнения TH | многочлен полку описать не может; у FH нет полюсов |
| Нужна степень, названная в методике | LG или NW с этой степенью | окно $M+1$ ближайших узлов — то же, что делает классическая процедура |
| Требуется оценка достигнутой погрешности | AT с заданной точностью останова | разность соседних приближений и есть оценка |
Обратная сторона того же приёма: если LG высокой степени или BL резко расходятся с кусочными методами только у краёв — это явление Рунге, а не особенность данных.
Разбор примера: стандартный потенциал хлорсеребряного электрода
Всё сказанное выше собирается в одной задаче, знакомой всякому, кто считал
электродный потенциал. Уравнение Нернста отсчитывает ЭДС от стандартного
потенциала при температуре опыта, а справочник даёт его таблицей; термостат же
стоит на 20, 22, 30 или 37 °C, и в узел таблицы эта температура попадать не
обязана. Классический источник — работа Бейтса и Бауэра
1954 года[26], где $E^\circ$ хлорсеребряного
электрода измерен при семнадцати температурах от 0 до 95 °C (от 24 до
81 электрохимической ячейки на точку; больше всего, 81, — при 25 °C). Пример поставляется с
программой: docs\examples\bates-agcl.itp.xml — готовый файл подпункта,
bates-agcl.txt — те же семнадцать узлов для вставки
(Ctrl+V), bates-agcl-check.itp.xml — проверочный файл,
о котором ниже.
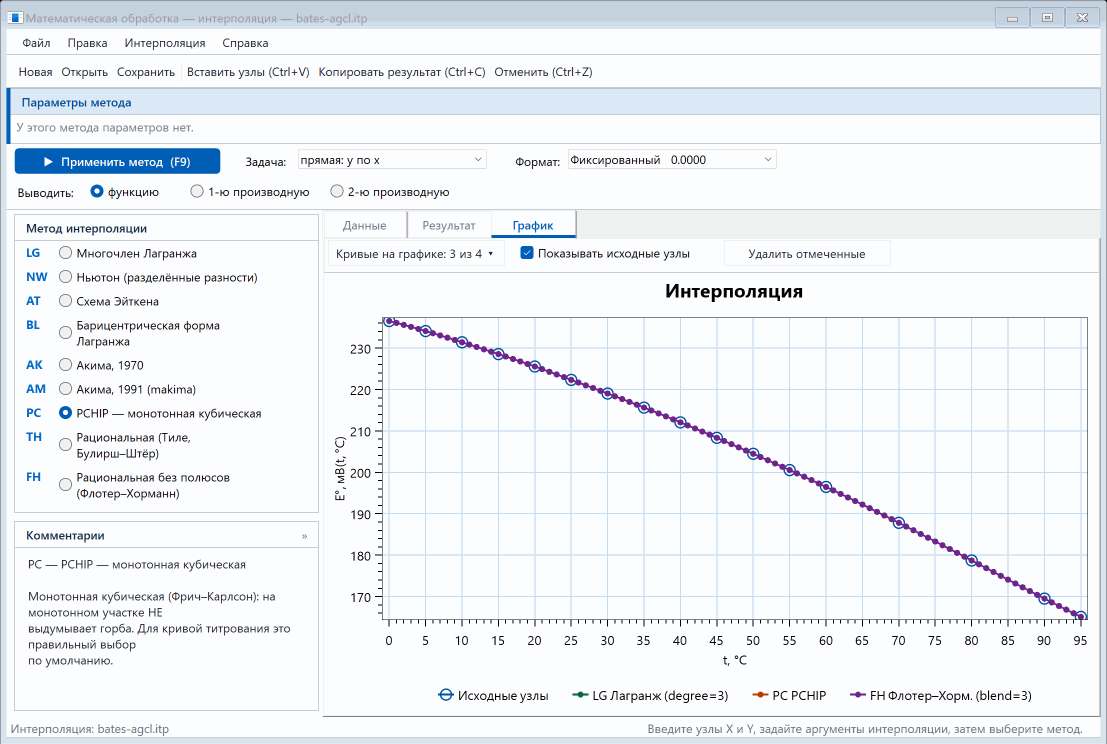
Проверка утаиванием: 25 °C против 80 °C
Приём тот же, что в разборах примеров 5.5 и 7.8: узел убирается из таблицы, восстанавливается интерполяцией по остальным и сравнивается с тем, что было. Взяты два узла — 25 °C (частый участок, шаг 5) и 80 °C (редкий, шаг 10); в поставляемом проверочном файле сняты оба сразу, а сетка аргументов состоит ровно из этих двух значений.
| Код | Метод | $E^\circ(25)$ | Δ, мВ | $E^\circ(80)$ | Δ, мВ |
|---|---|---|---|---|---|
FH | Флотер — Хорманн, $d = 3$ | 222,348 | +0,008 | 178,746 | +0,016 |
AK | Акима, 1970 | 222,354 | +0,014 | 178,667 | −0,063 |
AM | Акима, 1991 | 222,355 | +0,015 | 178,689 | −0,041 |
PC | PCHIP | 222,360 | +0,020 | 178,688 | −0,042 |
LG, NW | Лагранж и Ньютон, $M = 3$ | 222,370 | +0,030 | 178,663 | −0,067 |
TH | Тиле, окно 6 узлов | 222,433 | +0,093 | 178,657 | −0,073 |
BL | многочлен по всем узлам | 222,331 | −0,009 | 214,032 | +35,3 |
У всех кусочных методов ошибка при 25 °C лежит между 0,008 и 0,030 мВ, а при 80 °C — между 0,016 и 0,073. Сравнивать эти числа надо не с нулём, а с собственной погрешностью таблицы: 0,01 мВ при 25 °C и 0,07 при 80. То есть на обоих участках интерполяция не добавляет к неопределённости ничего сверх той, что уже есть в самих данных, — и это ответ на вопрос, ради которого пример и взят.
LG и NW дали тождественно одинаковые числа — то
самое утверждение из введения к подпункту: один и тот же
многочлен в двух формах записи. У методов, работающих по ближайшим узлам
(LG, AK, AM, PC), снятие второго
узла в другом конце таблицы ничего не меняет — числа те же, что при утаивании
поодиночке; у FH, который глобален по построению, второй снятый узел
сдвигает ответ на 0,03 мВ.
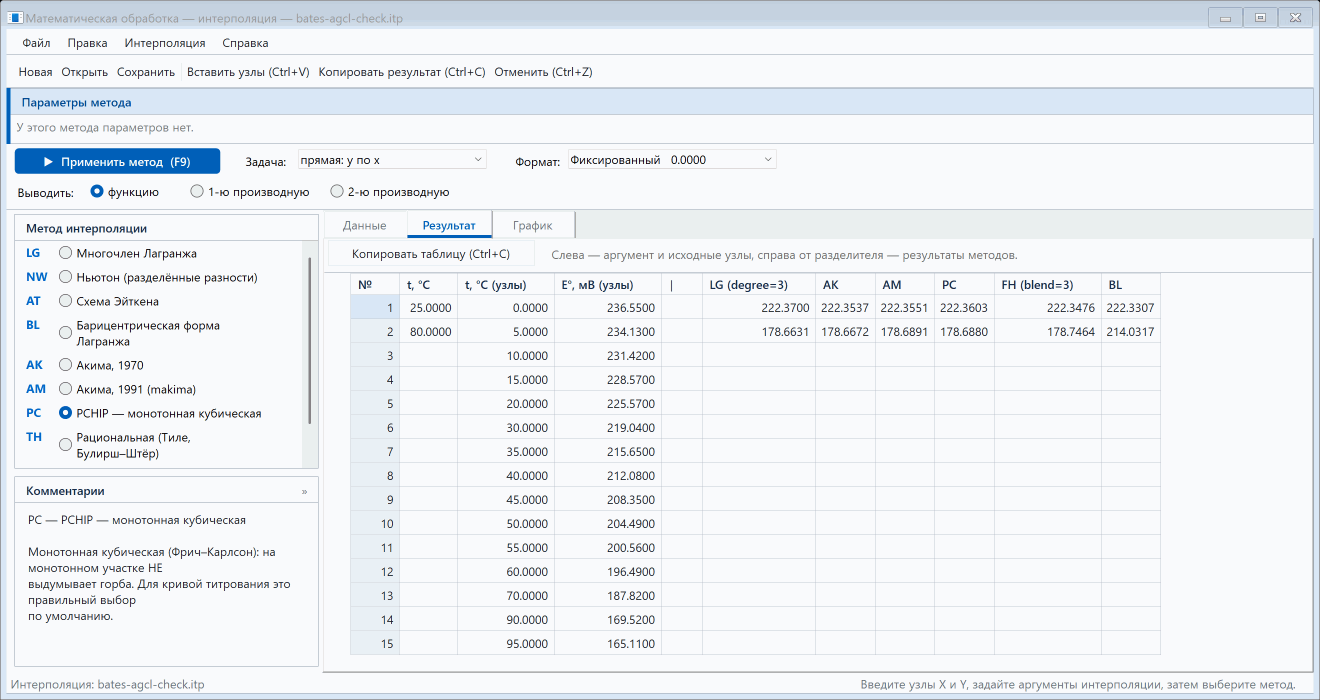
BL, при 25 °C оказывается точнее всех, а при 80 промахивается на 35 милливольт. Почему так — ниже.Отчего ошибка: от шага или от шума?
Ошибка при 80 °C вдвое-втрое больше, чем при 25. Соблазнительно приписать это удвоению шага — но у кубической интерполяции ошибка усечения падает как $h^4$ (у локальных кубик с приближёнными наклонами — как $h^3$), и удвоение шага дало бы шестнадцать раз, в худшем случае восемь, а никак не два. Значит дело не в шаге, и это проверяется прямо.
| Метод | усечение при 25 °C | усечение при 80 °C | полная при 25 | полная при 80 |
|---|---|---|---|---|
LG, NW $M = 3$ | 0,0 | 0,0 | 30 | 67 |
FH $d = 3$ | 0,0 | 0,0 | 10 | 18 |
TH окно 6 | 0,0 | 0,0 | 93 | 73 |
BL (все узлы) | 0,0 | 0,0 | 19 | 70 900 |
AK | 7,5 | 40,2 | 14 | 63 |
PC | 12,3 | 39,0 | 20 | 42 |
AM | 17,8 | 58,8 | 15 | 41 |
LG $M = 1$ (линейная) | 74,5 | 201,2 | 35 | 60 |
Первые четыре строки — ключ ко всему разбору. Сглаженная зависимость есть
многочлен третьей степени, а LG с $M = 3$, FH,
TH и BL воспроизводят кубику точно; значит
усечения у них нет вовсе, и вся их ошибка на настоящих данных —
унаследованный разброс таблицы.
У локальных кубик AK, AM и PC усечение есть
(наклоны в узлах у них приближённые), и при 80 °C оно — 0,04…0,06 мВ —
уже сравнимо с их полной ошибкой: только этим методам редкий участок и стоит чего-то.
Отчего же тогда 80 °C хуже 25? Оттого, что хуже сами данные. Собственная погрешность таблицы растёт от 0,01 мВ при 25 °C до 0,07 при 80 — в семь раз, — и наблюдаемое отношение ошибок 2…3 объясняется этим, а не шагом. Тот же вывод даёт полный перебор: каждый из пятнадцати внутренних узлов снимается по очереди и восстанавливается.
| Метод | среднее | max | среднее на участке шага 5 | среднее на участке шага 10 |
|---|---|---|---|---|
FH $d = 3$ | 0,011 | 0,032 | 0,009 | 0,018 |
LG, NW $M = 3$ | 0,026 | 0,067 | 0,021 | 0,047 |
AK | 0,030 | 0,129 | 0,017 | 0,083 |
PC | 0,034 | 0,128 | 0,024 | 0,073 |
AM | 0,038 | 0,128 | 0,027 | 0,080 |
TH окно 6 | 0,091 | 0,787 | 0,097 | 0,069 |
LG $M = 1$ | 0,093 | 0,210 | 0,084 | 0,133 |
BL (все узлы) | 53,7 | 723 | 0,431 | 267 |
Лучший метод — Флотер — Хорманн: среднее 0,011 мВ и наибольшее 0,032. Сравните с тем, насколько сама таблица расходится со своим же сглаживающим уравнением — в среднем на 0,040 мВ: интерполяция здесь давно не слабое звено, разброс самих измерений вчетверо крупнее. Объяснения «FH лучше, потому что рациональный» тут нет: он попросту точен на кубиках и при этом почти локален — сочетание, которое эта задача и вознаграждает.
Явление Рунге — на настоящих данных
Строка BL в обеих таблицах выпадает из ряда так, что её стоит разобрать
отдельно. Многочлен по всем семнадцати узлам проходит через каждый из них
точно и не имеет ошибки усечения вовсе (см. выше) — и всё же между
узлами он ошибается на десятки милливольт.
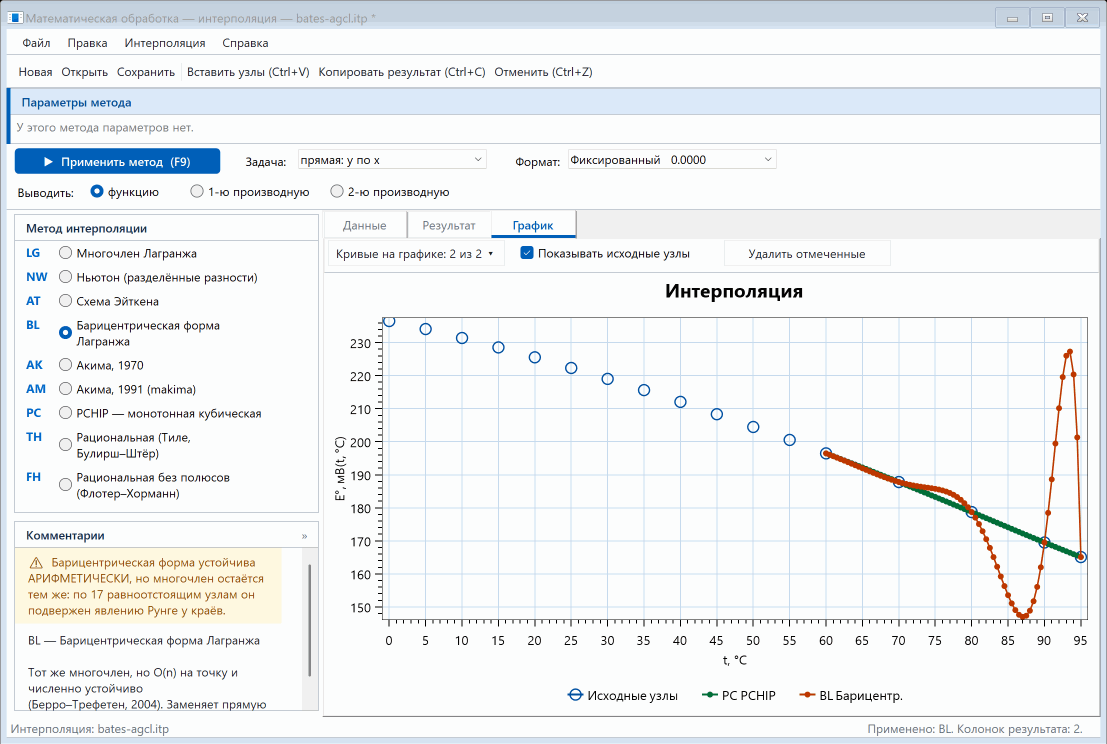
Числами: наибольшее отклонение BL от сглаженной кривой —
25,3 мВ при 87 °C, тогда как весь размах таблицы от 0 до 95 °C
составляет 71,4 мВ. Причина не в «плохой функции» и не в арифметике, а в
усилении шума узлов, и у него есть точная мера — постоянная Лебега
$\Lambda = \max_t \sum_k |\ell_k(t)|$, множитель, на который оператор интерполяции
умножает погрешность узлов[19]:
| Оператор | $\Lambda$ | во что превращает печатный квант 0,005 мВ |
|---|---|---|
LG $M = 3$ (окно 4 узла) | 1,63 | 0,008 мВ |
FH $d = 3$ | 8,2 | 0,04 мВ |
BL (17 узлов) | 2,8·10⁴ | 140 мВ |
Проверяется это одним опытом, который стоит проделать самому: измените в таблице одно значение при 25 °C на 0,01 мВ — на единицу последнего печатного знака. Монотонная кубика при 87,5 °C не шелохнётся вовсе (там работают другие узлы), а глобальный многочлен сдвинется на 8,3 мВ.
Параметр важнее метода
Схема Эйткена на этой таблице показывает то же самое с другой стороны — и заодно объясняет, зачем ей вообще нужна точность останова. Восстановление узла 80 °C одним и тем же методом:
| Точность останова | $E^\circ(80)$, мВ | Δ, мВ |
|---|---|---|
| не задана (все узлы) | 249,64 | +70,9 |
| 0,5 | 178,538 | −0,192 |
| 0,1 | 178,684 | −0,046 |
| 0,05 | 178,684 | −0,046 |
| 0,01 | 249,64 | +70,9 |
Годится середина: 0,1 и 0,05 мВ. Слишком грубая точность (0,5) останавливает
схему рано, и ошибка вчетверо больше; слишком тонкая (0,01) недостижима при
разбросе этой таблицы — разность соседних приближений до неё не опускается
никогда, схема исчерпывает все узлы и превращается в тот самый многочлен, беды
которого мы только что видели у BL. Правило простое: точность
останова задаётся на уровне собственной погрешности данных, здесь
0,05…0,1 мВ.
Полюс цепной дроби — он на этой таблице есть
Предупреждение 4.1.8 на этих данных сбывается. Рациональная интерполяция Тиле окном в 6 узлов даёт при $t = 20{,}5$ °C значение 220,79 мВ вместо 225,25 — провал на 4,5 мВ шириной меньше градуса, посреди самого частого участка таблицы. Соседние точки при этом в порядке: при 20,45 °C ответ завышен на 0,4 мВ, при 20,55 занижен на 0,4, при 21 °C ошибка уже 0,07.
TH проверяют не в одной точке, а на сетке, и смотрят на кривую;
метод без этого недостатка — FH, который на той же таблице оказался
лучшим из всех.
Производная: температурный коэффициент и энтропия
Производная $dE^\circ/dt$ — не отвлечённая величина: она прямо даёт энтропию реакции, $\Delta S = F\,(dE^\circ/dT)$. Сглаженное уравнение авторов даёт при 25 °C $-0{,}6457$ мВ/К, то есть $\Delta S = -62{,}3$ Дж/(моль·К). Интерполянты, построенные по семнадцати узлам, дают:
| Метод | $dE^\circ/dt$, мВ/К | $\Delta S$, Дж/(моль·К) | отличие |
|---|---|---|---|
LG $M = 3$ | −0,6523 | −62,9 | 0,6 |
PC | −0,6529 | −63,0 | 0,7 |
AK | −0,6561 | −63,3 | 1,0 |
FH $d = 3$ | −0,6583 | −63,5 | 1,2 |
Значение самой функции методы дают с ошибкой около 0,02 мВ (0,01 %), а её производную — с ошибкой 1…2 %. В относительных единицах их разброс между собой отличается в сотни раз: 0,9 % у производной (0,006 мВ/К из 0,65) против 0,002 % у значения (0,005 мВ из 214). Это цена одного дифференцирования, и она здесь измерена, а не оценена.
Что из этого следует
Практический ответ, ради которого пример и открывают: при 37 °C все кусочные методы дают $E^\circ = 214{,}24$ мВ и расходятся между собой на 0,005 мВ — вчетверо меньше собственной погрешности справочных значений. Значение можно брать и не думать о выборе метода. При 85 °C те же методы дают 174,09…174,12, расхождение 0,03 мВ — по-прежнему приемлемо, но уже на уровне $\sigma$ таблицы.
- На гладкой зависимости выбор метода не решает — решают степень (или ширина окна) и то, глобален метод или локален.
- Ошибку интерполяции сравнивают не с нулём, а с погрешностью самих данных; здесь она оказалась ниже неё на обоих участках.
- Редкий участок таблицы дороже для методов с приближёнными наклонами (AK, AM, PC) и безразличен для точных на кубиках (LG $M = 3$, FH).
- Разброс между способами — оценка неопределённости снизу: при утаивании узлов он занижает настоящую ошибку в 1,3…1,5 раза (25, 80 и 90 °C), а на трёх других узлах оказался немного шире неё.
- Глобальный многочлен применим ровно там, где узлы часты и равномерны. Признак беды — не «плохая функция», а редкий участок или край.
4.6.Работа с программой
Окно устроено как окно сглаживания: методы слева двухбуквенными кодами, результаты копятся колонками справа, кривые сравниваются на графике. Отличий два — второй набор чисел (аргументы интерполяции) и режим вывода.
- Узлы. Вкладка «Данные», левая таблица: столбцы $X$ и $Y$. Число узлов задаётся полем и кнопкой «Построить таблицу», либо блок вставляется из буфера (Ctrl+V) — таблица нарастёт сама. Узлы обязаны идти по возрастанию $X$ и не повторяться; если данные пришли из журнала как попало, пункт Правка ▸ Сортировать узлы по возрастанию X приводит их в порядок (тем же ядром, что подпункт «Сортировка»).
- Аргументы интерполяции. Правая таблица — точки, в которых нужны значения. Их можно вставить из буфера или построить сеткой: «от … до … шаг …» либо «или точек $N$». Пустые «от» и «до» берутся по границам узлов. Границы прижимаются к таблице: экстраполяции нет, и об изменении границ окно сообщает в строке состояния.
- Задача и вывод. Вверху: «Задача» — прямая ($y$ по $x$) или обратная ($x$ по $y$); «Выводить» — функцию, первую или вторую производную. Переключение пересчитывает уже полученные колонки, повторно применять методы не нужно.
- Метод. Выберите в списке слева. Появятся его параметры (у методов без параметров так и написано) и, если есть о чём предупредить, — жёлтая полоса. Кнопка «Применить метод» (F9) добавляет колонку результата.
-
Результат. Вкладка «Результат»: слева аргумент интерполяции и исходные
узлы, справа от разделителя — колонки методов, подписанные кодом и параметрами
(
LG (degree=3)). Пустая клетка означает, что аргумент вне таблицы или что у цепной дроби там полюс. Кнопка «Копировать таблицу» (Ctrl+C) отдаёт всё это в буфер. - График. Исходные узлы — крупные полые кружки, расчётные значения — залитые кружки поменьше: совпадение видно как точка внутри кольца. Набор кривых выбирается кнопкой «Кривые на графике», лишние удаляются кнопкой «Удалить отмеченные».
Кнопка «Очистить пробы интерполяции» убирает все колонки результатов и кривые, сохраняя узлы и аргументы, — чтобы перебирать методы заново, не вводя данные повторно.
*.itp.xml идут узлы,
аргументы, режим и список применённых методов с их параметрами; колонки
восстанавливаются пересчётом при загрузке. Поэтому файл не может разойтись с
алгоритмом: открыв старый проект, вы увидите то, что программа считает сегодня.
4.7.Литература
Ссылки в тексте подраздела даны номерами в квадратных скобках. Порядок — тематический: многочлен и его формы, локальные кубики, рациональные методы, явление Рунге, общее.
Интерполяционный многочлен и его формы
- [1] Waring E. Problems concerning Interpolations. — Philosophical Transactions of the Royal Society of London, 1779, vol. 69, p. 59–67. Фактический первоисточник формулы — за шестнадцать лет до Лагранжа.
- [2] Lagrange J.-L. Leçons élémentaires sur les mathématiques, лекция 5 (1795); опубл. в Séances des Écoles Normales, an III; переизд. 1812 в Journal de l'École Polytechnique. Постранично доступна: archive.org. Работа, чьим именем метод назван; работ Уоринга и Эйлера Лагранж не знал.
- [3] Gautschi W. Interpolation before and after Lagrange. — Rend. Sem. Mat. Univ. Politec. Torino, 2012, vol. 70, p. 347–368. Разбор приоритета и истории формулы.
- [4] Aitken A. C. On interpolation by iteration of proportional parts, without the use of differences. — Proceedings of the Edinburgh Mathematical Society, 1932, vol. 3, p. 56–76. Оригинал схемы 4.1.3; там же оговорена перестановка ролей $x$ и $y$ для обратной задачи (4.4).
- [5] Neville E. H. Iterative interpolation. — Journal of the Indian Mathematical Society, 1934, vol. 20, p. 87–120. Независимый вариант той же таблицы; в литературе алгоритм обычно «Эйткена — Невилла».
- [10] Berrut J.-P., Trefethen L. N. Barycentric Lagrange Interpolation. — SIAM Review, 2004, vol. 46, no. 3, p. 501–517. Основная ссылка на 4.1.4: $O(n)$ на точку и практическая сторона вопроса.
- [11] Higham N. J. The numerical stability of barycentric Lagrange interpolation. — IMA Journal of Numerical Analysis, 2004, vol. 24, no. 4, p. 547–556. Доказательство обратной устойчивости второй (истинно барицентрической) формы — то, на что ссылаются словами «численно устойчива».
- [12] Salzer H. E. Lagrangian interpolation at the Chebyshev points; some unnoted advantages. — Computer Journal, 1972, vol. 15, no. 2, p. 156–159. Предшественник: замкнутые барицентрические веса на чебышёвских узлах.
Локальные кубики
- [6] Akima H. A New Method of Interpolation and Smooth Curve Fitting Based on Local Procedures. — Journal of the ACM, 1970, vol. 17, no. 4, p. 589–602. Оригинал метода 4.1.5.
- [7] Akima H. A method of univariate interpolation that has the accuracy of a third-degree polynomial. — ACM Transactions on Mathematical Software, 1991, vol. 17, no. 3, p. 341–366 (там же Algorithm 697). Авторская модификация 4.1.6: чинит поведение исходного метода на почти линейных участках.
- [8] Fritsch F. N., Carlson R. E. Monotone Piecewise Cubic Interpolation. — SIAM Journal on Numerical Analysis, 1980, vol. 17, no. 2, p. 238–246. Необходимое и достаточное условие монотонности кубического эрмитова куска.
- [9] Fritsch F. N., Butland J. A Method for Constructing Local Monotone Piecewise Cubic Interpolants. — SIAM Journal on Scientific and Statistical Computing, 1984, vol. 5, no. 2, p. 300–304. Именно эта формула наклонов реализуется под именем PCHIP; без неё ссылка на 1980 год неполна.
- [23] de Boor C. A Practical Guide to Splines. — New York: Springer, 1978. — 392 p. Практическое изложение кусочно-полиномиального аппарата, из которого выросли реализации PCHIP в библиотеках. Постранично доступна: archive.org.
Рациональная интерполяция
- [14] Thiele T. N. Interpolationsrechnung. — Leipzig: B. G. Teubner, 1909. — 175 p. Оригинал цепной дроби на обратных разностях. Постранично доступна: archive.org.
- [15] Bulirsch R., Stoer J. Fehlerabschätzungen und Extrapolation mit rationalen Funktionen bei Verfahren vom Richardson-Typus. — Numerische Mathematik, 1964, vol. 6, no. 1, p. 413–427. Оригинал алгоритма в форме таблицы типа Невилла — то, что реализовано в 4.1.8.
- [16] Floater M. S., Hormann K. Barycentric rational interpolation with no poles and high rates of approximation. — Numerische Mathematik, 2007, vol. 107, p. 315–331. Семейство рациональных интерполянтов без полюсов на вещественной оси — метод 4.1.9.
- [13] Berrut J.-P. Rational functions for guaranteed and experimentally well-conditioned global interpolation. — Computers & Mathematics with Applications, 1988, vol. 15, no. 1, p. 1–16. Веса, дающие интерполянт без полюсов; частный случай $d = 0$ метода 4.1.9.
- [24] Cuyt A., Wuytack L. Nonlinear Methods in Numerical Analysis. — Amsterdam: North-Holland, 1987. — 278 p. Теория цепных дробей Тиле: недостижимые точки и полюса.
Явление Рунге
- [17] Runge C. Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. — Zeitschrift für Mathematik und Physik, 1901, vol. 46, p. 224–243. Оригинал примера $1/(1+25x^2)$.
- [18] Epperson J. F. On the Runge Example. — American Mathematical Monthly, 1987, vol. 94, no. 4, p. 329–341. Разбор с точной границей сходимости $|x| \approx 0{,}7266$; лучшая ссылка для формулировки предупреждения.
- [19] Trefethen L. N. Approximation Theory and Approximation Practice. — Philadelphia: SIAM, 2013 (extended ed. 2019), гл. 12–13 и 15. Почему на чебышёвских узлах эффекта нет, то есть что предупреждение относится именно к равноотстоящим узлам. Глава 15 — о постоянной Лебега: множителе, на который оператор интерполяции умножает погрешность узлов (им в разборе примера измерено усиление шума).
- [20] Platte R. B., Trefethen L. N., Kuijlaars A. B. J. Impossibility of fast stable approximation of analytic functions from equispaced samples. — SIAM Review, 2011, vol. 53, p. 308–318. Доказательство, что на равномерной сетке эффект в принципе неустраним никаким методом.
Обратная задача и общее
- [22] Brent R. P. Algorithms for Minimization without Derivatives. — Englewood Cliffs: Prentice-Hall, 1973. — 195 p. — гл. 4. Обратная квадратичная интерполяция как рабочий инструмент поиска корня (zeroin). В комплексе Брент уже цитируется — метод PRAXIS в потенциометрии.
- [25] Ostrowski A. M. Solution of Equations and Systems of Equations. — 2nd ed. — New York: Academic Press, 1966. — 353 p. Классика по сходимости методов, построенных на обратной интерполяции. Постранично доступна: archive.org.
- [21] Meijering E. A Chronology of Interpolation: From Ancient Astronomy to Modern Signal and Image Processing. — Proceedings of the IEEE, 2002, vol. 90, no. 3, p. 319–342. Обзорная ссылка на историю задачи в целом.
Данные примера
- [26] Bates R. G., Bower V. E. Standard Potential of the Silver–Silver-Chloride Electrode from 0° to 95° C and the Thermodynamic Properties of Dilute Hydrochloric Acid Solutions. — Journal of Research of the National Bureau of Standards, 1954, vol. 53, no. 5, p. 283–290 (Research Paper 2546). Источник таблицы разбора примера: семнадцать температур, 24…81 ячейка на точку. Там же напечатана собственная погрешность каждого значения — по ней и судят, чего стоит интерполяция, — и сглаженное уравнение $E^\circ(t)$ третьей степени, которым в разборе отделено усечение от шума.
5.Сплайны
Что такое сплайн
В подпункте «Интерполяция» кривую строил один многочлен на всю таблицу, и у него обнаружился неустранимый порок: с ростом числа узлов растёт и степень, а вместе с ней — колебания у краёв (явление Рунге). Сплайн решает ту же задачу иначе: степень не растёт никогда. Диапазон делится узлами на отрезки, на каждом строится свой многочлен низкой степени, а в узлах эти куски сшиваются по производным:
Кусочный многочлен степени $k$, у которого в узлах непрерывны все производные до $(k-1)$-й, и называется сплайном степени $k$. Число сшитых производных — это и есть класс гладкости $C^{k-1}$, главная характеристика метода в этом подпункте: по ней здесь и выбирают (5.3).
Само слово пришло из чертёжной практики: сплайном называлась упругая рейка, которую прижимали к точкам грузиками и обводили. Рейка минимизирует энергию изгиба $\int (S'')^2 dx$ — и кубический сплайн из 5.1.1 есть в точности математическая запись этой рейки. Математическую теорию заложил Шёнберг[1] в 1946 году; систематическое её изложение — у де Бура[2], Завьялова с соавторами[15] и Стечкина с Субботиным[16].
Двух уравнений не хватает — и это не мелочь
Пусть узлов $n$, значит отрезков $n-1$, и на каждом кубика с четырьмя коэффициентами: неизвестных $4(n-1)$. Условий же набирается:
| Условие | Сколько |
|---|---|
| каждый кусок проходит через оба своих узла | $2(n-1)$ |
| непрерывность $S'$ во внутренних узлах | $n-2$ |
| непрерывность $S''$ во внутренних узлах | $n-2$ |
| Итого | $4n-6$ |
Неизвестных $4n-4$, уравнений $4n-6$: не хватает ровно двух. Их и задаёт краевое условие — то самое, о котором в учебниках говорят мимоходом, а на экспериментальной кривой оно решает судьбу двух крайних интервалов (5.2). Именно поэтому у кубического сплайна в программе есть выбор из пяти условий, а не молчаливо зашитый «естественный».
У локальных методов (HR, CR, CD,
AK, MN) этой заботы нет вовсе: они не решают систему, а
назначают наклон в каждом узле по его соседям — и тем самым отказываются от
непрерывности второй производной в обмен на устойчивость.
Восемь видов подпункта
| Код | Метод | Класс | Область влияния | Параметры |
|---|---|---|---|---|
| CB | Кубический сплайн | $C^2$ | глобальный | краевые условия и их значения |
| HR | Эрмитов кубический | $C^1$ | локальный | источник наклонов (колонка D) |
| CR | Катмулл — Ром | $C^1$ | локальный | нет |
| CD | Кардинальный | $C^1$ | локальный | натяжение $c$ |
| BS | B-сплайн (де Бур) | $C^{k-1}$ | глобальный | степень $k = 2,\,3,\,5$ |
| TN | Сплайн с натяжением | $C^2$ | глобальный | жёсткость $\sigma$ |
| AK | Сплайн Акимы | $C^1$ | локальный | нет |
| MN | Монотонный (PCHIP) | $C^1$ | локальный | нет |
AK и MN есть и в подпункте «Интерполяция» (там их коды те
же). Это один и тот же метод, показанный в двух окнах, а не две реализации:
локальная кубика — одновременно и интерполянт, и сплайн. Совпадение колонок до
последнего знака проверяется тестом.
5.1.Виды сплайнов— щёлкните заголовок, чтобы свернуть
5.1.1. Кубический сплайн $C^2$ глобальный
Классика и умолчание раздела: на каждом отрезке многочлен не выше третьей степени, в узлах непрерывны и наклон, и кривизна. Из всех кривых, проходящих через узлы и имеющих непрерывную вторую производную, он минимизирует полную кривизну $\int (S'')^2 dx$ — то есть буквально повторяет упругую рейку чертёжника[3].
В программе система решается не в привычных вторых производных, а в первых: неизвестными служат наклоны $d_i = S'(x_i)$, а условие непрерывности $S''$ даёт трёхдиагональную систему
Такая запись выбрана не из вкуса: получив наклоны, кривую немедленно даёт эрмитова форма из 5.1.2 — и тем самым шесть из восьми методов подпункта считаются одним и тем же кодом, различаясь лишь тем, откуда взялись $d_i$. Систему замыкают два краевых уравнения (5.2), а решается она прогонкой с выбором ведущего элемента: строка условия «не-узел» диагонально не преобладает, и обычная прогонка на ней неустойчива.
5.1.2. Эрмитов кубический $C^1$ локальный
На отрезке $[x_i;\,x_{i+1}]$ кубика однозначно определяется четырьмя числами — значениями и наклонами на концах:
Это общая форма всех кусочно-кубических методов раздела: и Катмулл — Ром, и кардинальный, и Акима, и PCHIP, и даже кубический сплайн после решения системы — эрмитовы кубики. Различие у них ровно одно: откуда взялись $d_i$.
Собственный смысл метода HR появляется тогда, когда наклоны
задаёт пользователь — колонкой D в таблице данных. Это нужно,
когда производная известна из существа задачи: закреплённый конец, известная
скорость реакции, состыковка с другой кривой. Незаполненные клетки колонки
восполняются трёхточечной формулой (производной параболы через узел и двух его
соседей), поэтому колонку можно заполнить частично.
Параметр «Наклоны» переключает источник: «из колонки D» или «трёхточечная формула». Во втором случае колонка игнорируется целиком.
5.1.3. Сплайн Катмулла — Рома $C^1$ локальный
Наклон в узле — центральная разность по двум соседям:
Ни системы, ни краевых условий: наклон в узле зависит ровно от двух соседей, и кривая строится за один проход[8]. Метод дёшев, устойчив и воспроизводит прямую точно. Плата — класс $C^1$: вторая производная в узлах разрывна.
Крайние наклоны достраиваются продолжением по хорде: $d_0 = 2\Delta_0 - d_1$, $d_{n-1} = 2\Delta_{n-2} - d_{n-2}$.
5.1.4. Кардинальный сплайн $C^1$ локальный
Тот же Катмулл — Ром, но касательная укорочена множителем натяжения:
При $c = 0$ это в точности CR; с ростом $c$ касательные
укорачиваются и кривая прижимается к хордам, теряя «размах» между узлами. При
$c \to 1$ наклоны обращаются в нуль, и кривая подходит к каждому узлу
горизонтально.
TN там, где натяжение нужно по существу,
а не для внешнего вида.
Крайние отрезки натяжением не управляются и ведут себя обратно: краевой наклон достраивается как $d_0 = 2\Delta_0 - d_1$, поэтому чем короче становится $d_1$, тем длиннее выходит $d_0$.
5.1.5. B-сплайн, схема де Бура $C^{k-1}$ глобальный
Тот же кусочный многочлен, но записанный не по отрезкам, а в базисе B-сплайнов — функций, каждая из которых отлична от нуля лишь на нескольких соседних промежутках:
Чтобы кривая прошла через узлы, коэффициенты $P_j$ («контрольные точки») находятся из системы $S(x_i) = y_i$. Узловой вектор строится усреднением абсцисс по $k$ соседним — выбор не косметический: он обеспечивает условие Шёнберга — Уитни[6], то есть невырожденность этой системы. Значение и производные считаются схемой де Бура[5][4] — численно устойчивым аналогом схемы Горнера; технические подробности (поиск промежутка, треугольная схема базисных функций) взяты в форме Пигла и Тиллера[7].
CB. Кубический сплайн один,
и B-базис — лишь другая его запись; программа честно об этом предупреждает при
выборе степени 3. Ценность метода — в остальных степенях:
| $k$ | Класс | Что это значит на практике |
|---|---|---|
| 2 | $C^1$ | вторая производная кусочно-постоянна — на графике ступеньки. Годится, когда нужна экономная гладкая кривая, но не для второй производной |
| 3 | $C^2$ | совпадает с CB; полезен как проверка (две независимые
реализации обязаны дать одно число) |
| 5 | $C^4$ | единственный способ получить ГЛАДКУЮ вторую производную: у кубического сплайна она кусочно-линейна, то есть ломаная, и это сразу видно при переходе в «Дифференцирование» |
Степени $k$ требуется не меньше $k+1$ узлов; при нехватке окно отказывается считать и говорит, сколько точек нужно.
5.1.6. Сплайн с натяжением $C^2$ глобальный
Кубический сплайн «звенит»: между далеко разнесёнными по ординате узлами он выходит за пределы данных. Идея Швайкерта[12] — добавить к упругой рейке продольное натяжение. Уравнение изгиба перестаёт быть $S'''' = 0$ и становится
откуда решение содержит гиперболические функции:
Здесь $z_i = S''(x_i)$, так что непрерывность второй производной выполнена тождественно, а трёхдиагональная система получается из непрерывности первой. Реализация следует Клайну[13] и Шпету[14].
| $\sigma$ | Что получается |
|---|---|
| $\to 0$ | обычный кубический сплайн (естественные краевые условия) |
| единицы, делённые на типичный шаг | рабочая область: выброс погашен, гладкость сохранена |
| $\to \infty$ | ломаная по узлам |
Величина размерная. $\sigma$ сравнивается с $1/h$, поэтому осмысленный порядок — единицы, делённые на типичный шаг по $x$. Если абсциссы измеряются тысячами, начинать надо не с единицы, а с тысячных долей.
5.1.7. Сплайн Акимы $C^1$ локальный
Наклон в узле берётся как взвешенное среднее соседних разностей[9], причём веса построены так, что резко выделяющаяся точка гасит собственное влияние: там, где разности сильно расходятся, вес соответствующей стороны падает. Метод и формулы подробно разобраны в 4.1.5 — здесь он тот же самый.
В контексте сплайнов у него одна роль, и она важна: это ответ на глобальность кубического сплайна. Одна выбившаяся точка не раскачивает кривую по всей таблице, а портит лишь два-три соседних отрезка. Именно об этом предупреждение в описании исходной задачи: «в районе точки, далеко отстоящей от соседей, обычные сплайны делают неожиданные выбросы».
5.1.8. Монотонный сплайн (PCHIP) $C^1$ локальный
Наклон — взвешенное гармоническое среднее соседних разностей, а при смене их знака — нуль. Условие Фрича — Карлсона[10] гарантирует, что на монотонном участке данных интерполянт тоже монотонен: горба между двумя точками одного направления не возникает в принципе. Формулы — в 4.1.7; наклоны по Фричу — Батленду[11].
Для кривой титрования это правильный выбор по умолчанию: кубический сплайн на крутом участке «дорисовывает» несуществующий экстремум, а монотонный — нет.
5.2.Краевые условия
Как показано в начале раздела, кубическому сплайну не хватает ровно двух уравнений, и задаются они на концах. Выбор влияет только на два крайних интервала — но это как раз те интервалы, где у экспериментальной кривой обычно происходит самое интересное.
| Условие | Уравнение | Когда брать |
|---|---|---|
| не-узел (умолчание) |
$S'''$ непрерывна в $x_1$ и $x_{n-2}$: два первых и два последних отрезка несёт одна кубика | Когда о краях ничего не известно — а это обычный случай. Условие не предполагает о поведении кривой ничего и не вносит в данные постороннего допущения. Умолчание и в MATLAB[2] |
| естественный | $S''(x_0) = S''(x_{n-1}) = 0$ | Когда кривизна на концах действительно нулевая (например, кривая выходит на прямолинейный участок). По умолчанию — не брать, см. ниже |
| параболическое замыкание |
крайний отрезок — парабола ($S''$ на нём постоянна) | Компромисс: мягче естественного, но всё же навязывает краю форму. Полезен при очень коротких таблицах |
| задана $y'$ | $S'(x_0)$ и $S'(x_{n-1})$ равны введённым числам | Когда наклон на концах известен из существа задачи: горизонтальная касательная в максимуме, известная скорость, состыковка с другой кривой |
| задана $y''$ | $S''(x_0)$ и $S''(x_{n-1})$ равны введённым числам | Когда известна кривизна. Естественное условие — частный случай при нуле |
Поля «Слева» и «Справа» существуют для последних двух условий; при остальных они игнорируются, и в заголовке колонки не печатаются. При трёх узлах условие «не-узел» вырождается (слева и справа это одно и то же требование), и программа строит через них параболу — единственный осмысленный ответ.
5.3.Класс гладкости и производные
Производные здесь берутся у самого сплайна и аналитически — у всех восьми методов без исключения: кусочный многочлен дифференцируется точно, а производная B-сплайна снова есть B-сплайн степенью ниже. Никакой разностной аппроксимации в подпункте нет (в отличие от рациональной интерполяции Тиле, см. 4.3).
Но точная производная и непрерывная производная — разные вещи. Вот что происходит на самом деле:
| Метод | $S$ | $S'$ | $S''$ | Вид графика $S''$ |
|---|---|---|---|---|
CB, TN | гладко | непрерывна | непрерывна | ломаная линия (кусочно-линейная у CB), но без разрывов |
BS, $k=5$ | гладко | непрерывна | гладкая | плавная кривая — единственный такой случай |
BS, $k=3$ | гладко | непрерывна | непрерывна | как у CB (это и есть CB) |
BS, $k=2$ | гладко | непрерывна | разрывна | ступеньки (кусочно-постоянна) |
HR, CR, CD,
AK, MN |
гладко | непрерывна | разрывна | скачки в каждом узле |
Отсюда прямое следствие для подпункта «Дифференцирование»: дважды
дифференцировать имеет смысл только сплайном класса $C^2$ и выше. Если нужна
именно гладкая $S''$ (например, для поиска точки перегиба по её нулю), единственный
подходящий метод — BS при $k = 5$.
5.4.Выбросы, локальность и монотонность
Главная неприятность интерполяционных сплайнов — выброс (overshoot): кривая выходит за пределы данных там, где соседние точки резко разошлись по ординате. Причина — та самая минимизация кривизны: чтобы пройти через обе точки плавно, рейке приходится сначала отклониться в противоположную сторону.
Бороться с этим можно тремя способами, и у каждого своя цена:
| Способ | Методы | Что теряется |
|---|---|---|
| Локальность: наклон назначается по ближним соседям, система не решается вовсе | AK, CR, HR |
непрерывность второй производной ($C^2 \to C^1$) |
| Монотонность: наклон принудительно занулён там, где разности меняют знак | MN |
непрерывность второй производной; вдобавок в настоящем экстремуме кривая становится «плоской» |
| Натяжение: в уравнение изгиба добавлено продольное усилие | TN |
ничего существенного: класс $C^2$ сохраняется, прямая воспроизводится точно |
| (натяжение касательных) | CD |
точность на прямой; крайние отрезки ведут себя обратно ожидаемому |
Локальность имеет и обратную сторону. Метод, не видящий таблицу целиком, не
может и воспользоваться ею: на гладких данных кубический сплайн заметно точнее
Акимы. Проверяется это прямо в окне — постройте по узлам заведомо гладкой функции
CB и AK и сравните колонки: на кубическом многочлене
CB воспроизведёт его в точности, а AK — нет.
Промах и выброс — не одно и то же. Если точка выбилась из-за ошибки измерения, правильно не подбирать устойчивый интерполянт, а убрать шум: медианный фильтр или LOWESS в разделе 3 удаляют промах, тогда как любой интерполянт обязан через него пройти — на то он и интерполянт.
5.5.Как подобрать сплайн
В отличие от сглаживания, здесь нет численного критерия качества вроде GCV: все восемь кривых проходят через узлы точно, и невязка у всех тождественно равна нулю. Выбор определяется тем, что известно о зависимости и зачем нужна кривая. Ниже — порядок действий, проверенный на задачах комплекса.
CB либо MN.Первая производная (скорость, наклон, поиск максимума) — нужен класс не ниже $C^1$, то есть любой; но следите за выбросами.
Вторая производная (перегиб, кривизна) — только $C^2$:
CB,
TN или BS при $k = 5$. Методы $C^1$ здесь дадут ступеньки.
CB с условием «не-узел»; при необходимости повысить порядок —
BS, $k = 5$.Есть выбившиеся точки — сначала посмотрите, не промах ли это (тогда в раздел 3). Если точка настоящая, берите
AK
или TN.Заметный шум по всей кривой — интерполяция вообще не тот инструмент: она воспроизведёт шум точно. Сглаживайте.
MN: он не выдумает несуществующего экстремума.Известны наклоны на концах —
CB с условием «задана $y'$».Известны производные в узлах —
HR с колонкой D.Известно, что кривая выходит на прямую —
CB, «естественный»
(это тот редкий случай, когда условие правдиво).
CB,
AK и MN — на одной сетке аргументов и посмотрите:
- колонки совпадают в пределах точности данных — вопрос закрыт, берите любую, различие ниже уровня эксперимента;
- расходятся между узлами, но не у краёв — дело в выбросе: смотрите шаг 2;
- расходятся у краёв — дело в краевом условии: переберите их в
CB(5.2); - расходятся всюду — узлов слишком мало для такой кривизны, никакая интерполяция этого не исправит.
TN и CD параметр непрерывен, поэтому его подбирают, а
не угадывают: постройте кривую при нескольких значениях (например $\sigma = 0{,}5$;
$5$; $50$), они лягут в таблицу соседними колонками с параметром в заголовке.
Берите наименьшее натяжение, при котором выброс уже приемлем: лишнее
натяжение спрямляет и то, что спрямлять не следовало.
Короткий ответ, если выбирать некогда. Гладкие данные — CB
(«не-узел»). Данные с выбросами — AK. Монотонная зависимость —
MN. Нужна вторая производная — BS, $k = 5$.
Разбор примера: спектр поглощения метилового красного
Всё сказанное выше собирается в одной задаче, знакомой всякому, кто работал со
спектрофотометром. Метиловый красный в кислой среде даёт полосу поглощения с
максимумом около 518 нм; в исходных данных он записан дважды — с шагом
10 нм (30 точек, обычный рабочий шаг) и с шагом 2 нм (146 точек,
плотная запись) [17]. Первая таблица — узлы примера,
вторая в разборе служит истиной:
по ней и видно, чего стоит восстановленная кривая. Пример поставляется с программой:
docs\examples\methyl-red-acid.spl.xml — готовый файл подпункта,
methyl-red-acid.txt — те же 30 узлов для вставки
(Ctrl+V), methyl-red-acid-dense.txt — плотная запись.
Задача не выдуманная. Между узлами значения нужны постоянно: полоса поглощения индикатора служит и для спектрофотометрического определения pKa, и для расчёта равновесия окрашенных форм, а прибор при этом стоит на своей длине волны, которая в узел таблицы попадать не обязана. Снимать весь спектр с шагом 2 нм ради нескольких значений дорого — за это и берут сплайн.
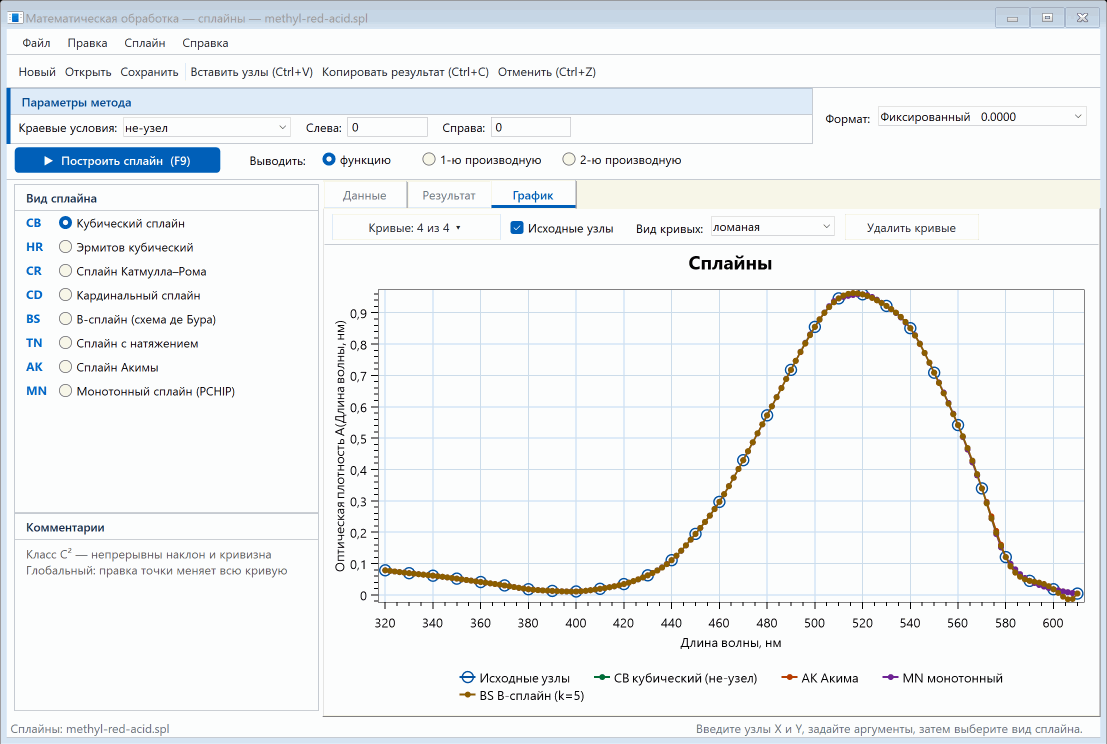
Проверка: строим по тридцати точкам, спрашиваем у ста сорока шести
Приём тот же, что в разборе двумерного примера (7.8): часть данных утаивается, а потом восстанавливается и сравнивается с тем, что было. Здесь утаивать ничего не надо — плотная запись существует сама по себе. Сплайн строится по 30 узлам, считается на сетке 320…610 нм через 2 нм, и сравнение идёт в 116 точках, которые узлами не были.
| Код | Метод (умолчания окна) | max |Δ| | при, нм | скз | max, % высоты |
|---|---|---|---|---|---|
TN | с натяжением, $\sigma = 1$ | 0,0133 | 556 | 0,0037 | 1,38 |
AK | Акима | 0,0133 | 566 | 0,0034 | 1,39 |
HR, CR | эрмитов, Катмулл–Ром | 0,0144 | 566 | 0,0033 | 1,50 |
MN | монотонный | 0,0148 | 576 | 0,0035 | 1,54 |
CD | кардинальный, $c = 0{,}5$ | 0,0169 | 556 | 0,0054 | 1,76 |
CB, BS | кубический («не-узел») и B-сплайн $k = 3$ | 0,0181 | 566 | 0,0038 | 1,89 |
Восемь методов уложились между 1,4 и 1,9 % высоты полосы, а по среднеквадратичному отклонению — между 0,33 и 0,54 %. Разница между лучшим и худшим — в полтора раза, тогда как между «сплайном» и «не сплайном» она, как увидим ниже, в тысячи раз. Вывод для практики: спорить о выборе метода на таких данных незачем, решает не он.
CB и BS при $k = 3$ дали тождественно одинаковые
числа — это не совпадение, а то самое утверждение из 5.1.5:
один и тот же многочлен в двух базисах.
Где сидит ошибка
Сводное число говорит мало; интереснее, в каком месте спектра кривая расходится с записью. Разложение по участкам (кубический сплайн, те же 116 точек):
| Участок, нм | Что это | max |Δ| | скз | скз самой записи |
|---|---|---|---|---|
| 320–400 | хвост в УФ, кривая полога | 0,0008 | 0,0003 | 0,00003 |
| 400–440 | минимум полосы | 0,0011 | 0,0006 | 0,00007 |
| 440–480 | подъём | 0,0050 | 0,0022 | 0,0009 |
| 480–505 | крутой подъём | 0,0060 | 0,0024 | 0,0011 |
| 505–535 | вершина | 0,0036 | 0,0019 | 0,0006 |
| 535–555 | спад | 0,0088 | 0,0051 | 0,0015 |
| 555–575 | крутое крыло | 0,0181 | 0,0096 | 0,0036 |
| 575–610 | хвост | 0,0109 | 0,0039 | 0,0022 |
Картина однозначна: ошибка идёт за крутизной. Там, где кривая полога, сплайн по узлам через 10 нм воспроизводит запись в четвёртом знаке (0,0003 — это 0,03 % высоты полосы), а на нисходящем крыле, где поглощение падает на 0,24 ед. A за десять нанометров, расхождение доходит до 0,018. Наибольшая крутизна записи — 0,0240 ед. A на нанометр при 572 нм; наибольшая ошибка стоит рядом, при 566 нм.
Что ограничивает ответ — и что нет
Прежде чем винить метод, стоит перебрать три возможные причины, и все три здесь измеримы.
CB и с 0,0133 до 0,0099 у AK: примерно четверть того,
что мы приписывали сплайну, принадлежит записи.
Три ловушки, которые видны на этом примере
CB,
AK, MN) равен 0,0108, тогда как настоящая ошибка
доходит до 0,0181, то есть разброс занижает её в 1,7 раза. В самой
тяжёлой точке, при 566 нм, три метода дают 0,4274, 0,4226 и 0,4238 — согласие
в пределах 0,005, — а запись говорит 0,4093. Причина понятна: все три метода
одинаково не видят кривизны, которой в узлах через 10 нм попросту нет, и
ошибаются в одну сторону. Согласие способов доказывает, что дело не в выборе
метода, — но не доказывает, что ответ верен.
BS, $k = 5$) — самый гладкий
сплайн подпункта, класс $C^4$, — на этих данных оказалась худшей: 0,0238
против 0,0181 у обычной кубики. Мало того, на последнем промежутке, между узлами
600 и 610 нм, она уходит в отрицательную оптическую плотность: −0,0136
при 606 нм, тогда как запись даёт +0,0102. Величина, которой не бывает, —
и получена она законным интерполянтом, проходящим через все узлы точно. Лишние
степени свободы, не подпёртые данными, тратятся на раскачивание кривой между узлами.
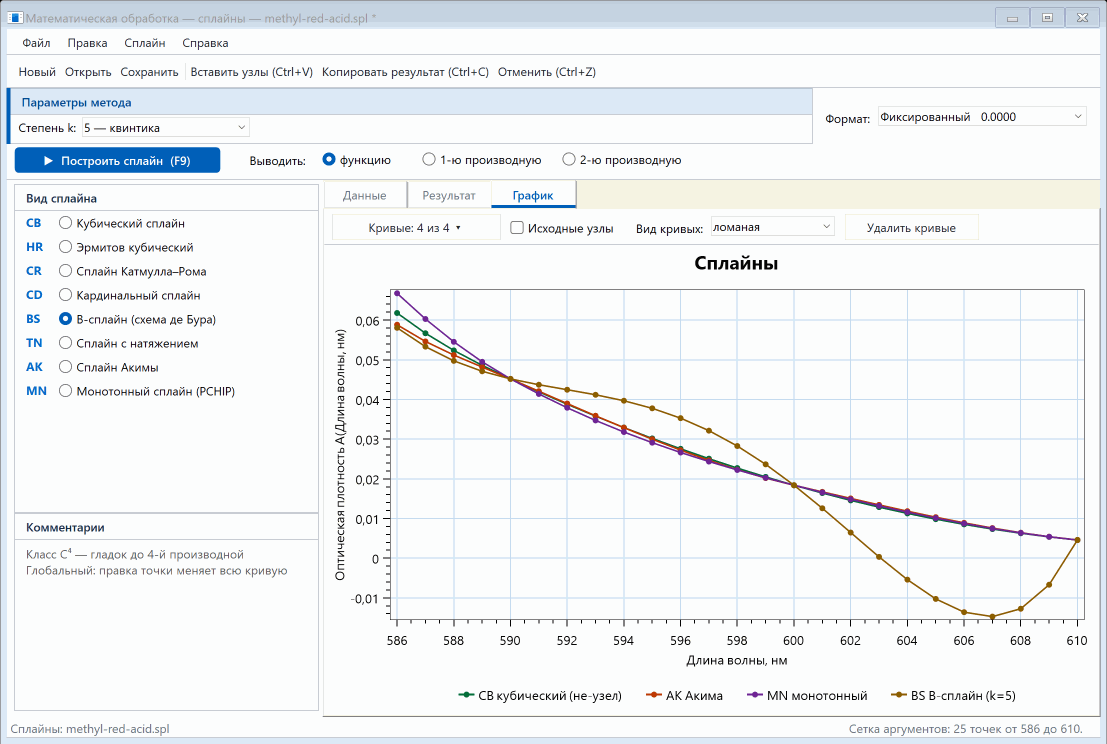
MN кладёт максимум ровно в узел, 520,00 нм. Это не
сбой, а прямое следствие устройства метода: чтобы не выдумать лишнего экстремума,
монотонный сплайн обнуляет наклон в узле, где ход данных меняется, — и вершина
садится туда же. Для поиска экстремума он непригоден по построению.
Что из этого читает химик
Три величины, которые снимают с полосы, ведут себя по-разному, и разница между ними поучительнее любой из них порознь.
| Величина | По записи | По сплайну (восемь методов) | Промах |
|---|---|---|---|
| Площадь полосы | 90,86 | 90,895…90,901 | 0,04 % |
| Высота максимума $A_{\max}$ | 0,9606 | 0,9590…0,9628 | 0,2 % |
| Положение максимума $\lambda_{\max}$ | 517,96 нм | 516,6…520,0 нм | до 1,4 нм |
Площадь устойчива: интегрирование усредняет ошибку, и разные методы сходятся в четвёртом знаке — ровно то, о чём говорит 9.3. Значение в точке уже чувствительнее. Положение максимума — самая уязвимая величина: она определяется не значением, а нулём производной, то есть берётся у кривой на порядок более тонкой характеристикой. Отсюда практическое правило: если $\lambda_{\max}$ нужна точнее нанометра, снимайте окрестность вершины с шагом 2 нм, а не полагайтесь на интерполяцию по десятинанометровой сетке.
И то, чего сплайном лучше не делать
Вторая производная спектра — приём известный: по ней разделяют перекрывающиеся полосы. Но взять её у интерполянта, построенного по редкой сетке, — затея почти безнадёжная, и на этом примере видно почему.
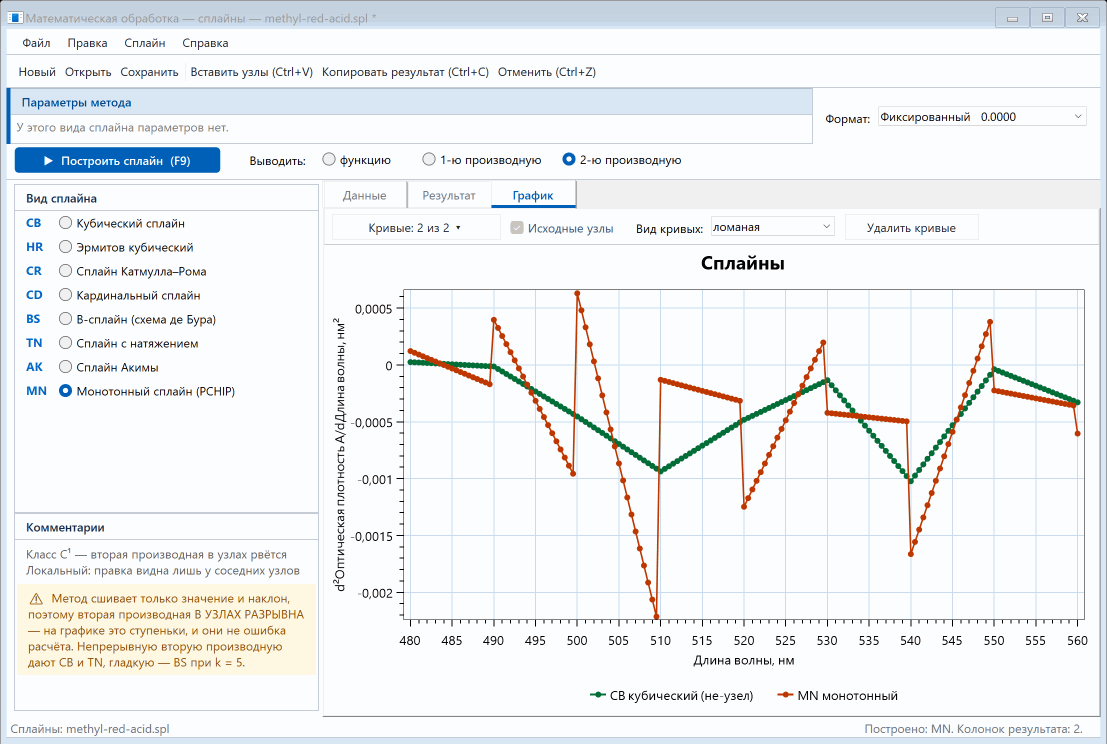
CB она непрерывна — ломаная линия без разрывов, как и обещано в 5.3; у MN в каждом узле скачок, и величина между соседними узлами меняется впятеро. Обе картинки верны: метод класса $C^1$ сшивает только значение и наклон. Но обратите внимание и на другое — размах самой величины около 0,002 ед. A/нм², а разброс записи на этом участке 0,0006 ед. A: вторая производная здесь на грани того, что данные вообще могут сказать.Если вторая производная нужна по существу, у неё есть свой подпункт со своими средствами — регуляризацией, оценкой шума и оптимальным шагом (8). Сплайн даёт её точно, но точность вычисления и достоверность — разные вещи.
Чем всё это отличается от «не сплайна»
Напоследок — мера того, насколько удачен сам выбор кусочной кривой. Через те же
30 узлов проходит ровно один многочлен 29-й степени, и подпункт
«Интерполяция» его строит (метод BL). Его наибольшее отклонение от
записи — 3273 единицы оптической плотности при 322 нм; у левого края он
выдаёт 3273,7 и 2648,9, у правого −2092,3 и −2595,3. Это явление Рунге
(4.2) во всей красе, и разница со сплайном — пять
порядков. Ради этого сплайны и придуманы: степень многочлена не растёт с числом
точек, поэтому лишних степеней свободы, которые нечем занять, у него не появляется.
Короткий итог примера. Спектр, снятый через 10 нм, восстанавливается сплайном по всей полосе со среднеквадратичным отклонением около 0,4 % высоты и промахом до 1,9 % на самом крутом участке. Выбор метода меняет ответ в полтора раза, шаг сетки — в три, а отказ от сплайна в пользу глобального многочлена — в сто тысяч. Согласие нескольких методов между собой означает лишь, что дело не в методе; чтобы узнать настоящую ошибку, нужны либо более плотные данные, либо независимая проверка — как здесь.
5.6.Работа с программой
CB (не-узел), BS (k=5), TN (σ=5)), так что
одна и та же кривая с разным параметром различима. Кнопка «Кривые ▾»
включает и выключает отдельные кривые, «Удалить кривые» убирает отмеченные,
«Очистить пробы сплайнов» удаляет все результаты, оставляя данные.
Список «Вид кривых» задаёт, как расчётные значения показаны на графике:
точки — только они и есть, ничего не добавлено; ломаная — та же
геометрия, что в таблице; сглаженная — линия, проведённая через них.
Последняя удобна для чтения формы, но рисует значения, которых не считали:
чтобы кривая стала гладкой по расчёту, а не по рисованию, добавьте точек в сетку
аргументов. По этой же причине форму на изломе или в экстремуме надо смотреть
точками либо ломаной.
5.7.Литература
Основания и общие руководства
- [1] Schoenberg I. J. Contributions to the problem of approximation of equidistant data by analytic functions. — Quarterly of Applied Mathematics, 1946, vol. 4, p. 45–99 (part A), p. 112–141 (part B). Работа, с которой сплайны начались как математический объект.
- [2] de Boor C. A Practical Guide to Splines. — New York: Springer-Verlag, 1978; revised edition 2001 (Applied Mathematical Sciences, vol. 27). Основной источник подпункта: условие «не-узел», устойчивое вычисление, вся практика работы с B-сплайнами. Постранично доступна: archive.org.
- [3] Ahlberg J. H., Nilson E. N., Walsh J. L. The Theory of Splines and Their Applications. — New York: Academic Press, 1967. Свойство минимальной кривизны и связь с упругой рейкой.
- [15] Завьялов Ю. С., Квасов Б. И., Мирошниченко В. Л. Методы сплайн-функций. — М.: Наука, Главная редакция физико-математической литературы, 1980. — 352 с. Полное изложение теории, включая сплайны с натяжением (5.1.6).
- [16] Стечкин С. Б., Субботин Ю. Н. Сплайны в вычислительной математике. — М.: Наука, Главная редакция физико-математической литературы, 1976. — 248 с. Аппроксимативные свойства сплайнов и оценки погрешности.
B-сплайны
- [4] Cox M. G. The numerical evaluation of B-splines. — Journal of the Institute of Mathematics and its Applications, 1972, vol. 10, p. 134–149. Устойчивая рекуррентная схема вычисления B-сплайна — половина того, что обычно называют схемой Кокса — де Бура. Ею считаются значение и производные метода BS (§5.1.5): прямой подсчёт по определению теряет знаки, рекуррентная формула — нет.
- [5] de Boor C. On calculating with B-splines. — Journal of Approximation Theory, 1972, vol. 6, p. 50–62. Вместе с [4] — та самая рекуррентная схема, по которой в программе вычисляются значение и производные.
- [6] Schoenberg I. J., Whitney A. On Pólya frequency functions III: The positivity of translation determinants with an application to the interpolation problem by spline curves. — Transactions of the AMS, 1953, vol. 74, p. 246–259. Условие невырожденности коллокационной системы — то, ради чего узловой вектор строится усреднением абсцисс.
- [7] Piegl L., Tiller W. The NURBS Book. — 2nd ed. — Berlin: Springer, 1997. Технические подробности: поиск узлового промежутка и треугольная схема базисных функций. Доступна: books.google.com.
Локальные кубики
- [8] Catmull E., Rom R. A class of local interpolating splines. — In: Computer Aided Geometric Design. — New York: Academic Press, 1974, p. 317–326. Работа, которой кривая Катмулла — Рома вошла в обиход: наклон в узле есть центральная разность по двум соседям, поэтому кривая строится за один проход, без системы уравнений и без краевых условий. Метод CR (§5.1.3) — самый дешёвый и самый локальный в подпункте.
- [9] Akima H. A new method of interpolation and smooth curve fitting based on local procedures. — Journal of the ACM, 1970, vol. 17, no. 4, p. 589–602. Подробный разбор — в 4.1.5.
- [10] Fritsch F. N., Carlson R. E. Monotone piecewise cubic interpolation. — SIAM Journal on Numerical Analysis, 1980, vol. 17, no. 2, p. 238–246. Условие, при котором кусочно-кубическая интерполяция СОХРАНЯЕТ монотонность данных: наклоны в узлах ограничиваются по соседним разностям. Метод MN (§5.1.8); на нём же стоит монотонный интерполянт справочных таблиц раздела буферов — там обычный кубический сплайн дал бы горб, то есть два разных объёма на одно значение pH.
- [11]
Fritsch F. N., Butland J. A method for constructing local monotone piecewise
cubic interpolants. — SIAM Journal on Scientific and Statistical Computing, 1984,
vol. 5, no. 2, p. 300–304.
Формула наклонов, применяемая в
MN.
Сплайн с натяжением
- [12] Schweikert D. G. An interpolation curve using a spline in tension. — Journal of Mathematics and Physics, 1966, vol. 45, p. 312–317. Исходная работа: уравнение $S'''' - \sigma^2 S'' = 0$.
- [13] Cline A. K. Scalar- and planar-valued curve fitting using splines under tension. — Communications of the ACM, 1974, vol. 17, no. 4, p. 218–220. Сплайн с натяжением в вычислительной форме, пригодной для программы: трёхдиагональная система относительно вторых производных, гиперболические функции вместо кубик. Реализация метода TN (§5.1.6) следует этой работе; её же приём отношений $\sinh$ спасает от переполнения при большом натяжении.
- [14]
Späth H. Exponential spline interpolation. — Computing, 1969, vol. 4,
p. 225–233.
Вместе с [13] — вычислительная форма, реализованная в
TN. Там же по этому виду сплайна: McCartin B. J. Theory of exponential splines. — Journal of Approximation Theory, 1991, vol. 66, p. 1–23; McAllister D. F., Passow E., Roulier J. A. Algorithms for computing shape preserving spline interpolations to data. — Mathematics of Computation, 1977, vol. 31, no. 139, p. 717–725.
Данные примера
- [17]
Спектр поглощения метилового красного в кислой форме: собственная запись,
поставляемая с комплексом —
docs\examples\methyl-red-acid.txt(30 точек через 10 нм) иmethyl-red-acid-dense.txt(146 точек через 2 нм). Источник данных разбора примера. Плотная запись служит там проверкой: по ней измерено, чего стоит кривая, построенная по редкой сетке, и сколько в расхождении принадлежит не сплайну, а самой записи.
6.Аппроксимация
Чем она отличается от интерполяции
Три предыдущих подпункта строили кривую через узлы: в них ответ единствен, и спорить не о чем. Здесь всё иначе, и причина одна — данные зашумлены. Точка таблицы есть сумма истинного значения и погрешности измерения, а требование пройти через неё есть требование воспроизвести погрешность в точности. Кривая, послушно исполнившая его во всех точках, описывает не зависимость, а конкретный набор случайных отклонений — и на следующей серии опытов она не повторится.
Поэтому здесь кривая проводится мимо точек, по управляемому критерию. И вместе с этим впервые появляется выбор, которого не было ни в интерполяции, ни в сплайнах: критериев много, моделей много, и вопрос «какая кривая правильная» перестаёт иметь единственный ответ. Половина этого раздела посвящена тому, как этот выбор делать не на глаз.
Две оси выбора
Слово «аппроксимация» в обиходе почти отождествлено с методом наименьших квадратов, и это отождествление — источник большей части недоразумений. На самом деле выбирать приходится по двум независимым осям:
| Ось | Что выбирается | Что стоит в подпункте |
|---|---|---|
| Базис | какими функциями приближаем | степени PL, ортогональные полиномы FO,
произвольный набор LC, Бернштейн BZ |
| Норма невязки | что именно минимизируем | $L^2$ (сумма квадратов) — и её устойчивые к выбросам варианты (6.4) |
Оси независимы: любой базис можно подгонять по любой норме. Сумма квадратов ($L^2$) удобна тем, что решается точно и в один приём, и статистически оптимальна при нормальном шуме[6]. Но нормальность — допущение, а не факт: один грубый промах делает её ложной, и тогда $L^2$ становится худшим из выборов. Об этом — 6.4.
Восемь методов подпункта
| Код | Метод | Базис | Чем задаётся гибкость | Экстраполяция |
|---|---|---|---|---|
| PL | Полином по степеням | $1, u, u^2, \dots, u^m$ | степень | да |
| FO | Полином Форсайта | ортогональный на данных $p_0, p_1, \dots, p_m$ | степень | да |
| LC | МНК по набору функций | любой из двадцати функций | сам набор | да |
| TE | Типовые уравнения | готовая форма термодинамики | число членов формы | да |
| BZ | Кривая Безье | Бернштейн $B_{j,m}(t)$ | степень | нет* |
| SS | Сглаживающий сплайн Райнша | узлы во всех точках | заданная невязка или $\lambda$ | нет |
| RS | Регрессионный сплайн | B-сплайны, мало узлов | число узлов | нет |
| PS | P-сплайн Айлерса–Маркса | B-сплайны, много узлов | штраф $\lambda$ | нет |
* у кривой Безье значение берётся прохождением по самой кривой, а она заканчивается на крайних точках данных — за ними считать нечего.
PL и FO дают ОДИН И ТОТ ЖЕ многочлен — многочлен наилучшего среднеквадратичного приближения данной степени единствен, и базис на него не влияет. Различаются они не результатом, а точностью, с какой этот результат удаётся вычислить (6.2). Это в точности то же положение дел, что у Лагранжа, Ньютона и Эйткена в разделе 4, и в программе оно проверяется теми же средствами: постройте обе кривые и сравните колонки.
6.1.Методы аппроксимации
Развернуть описания восьми методов
6.1.1. Полином по степеням (PL)
Самая распространённая модель:
Подгонка идёт не по сырому аргументу, а по нормированному $u$, где $c$ — середина диапазона, $s$ — его полуразмах. Это не косметика: при $X$ порядка сотен (температура в кельвинах, объём в микролитрах) колонка $X^6$ отличается от колонки единиц на пятнадцать десятичных порядков сама по себе, и подгонка теряет верные знаки ещё до того, как дело дойдёт до сути. После нормировки все колонки соизмеримы. Именно поэтому коэффициенты в таблице параметров даны при степенях $u$, а формула нормировки печатается рядом с ними: без неё числа нечем воспользоваться.
«Без свободного члена» означает жёсткое требование $Y(0) = 0$ — его берут, когда это известно из существа задачи (нет сигнала при нулевой концентрации). В этом случае нормировка только масштабирует, но не сдвигает ($c = 0$): требование относится к исходной переменной, а сумма степеней сдвинутой переменной свободный член содержит — он просто спрятан в скобках.
Ограничение метода — то же явление Рунге, что и в интерполяции (4.2), только в смягчённом виде: подгонка по $n \gg m$ точкам колеблется у краёв слабее, чем интерполяция по $m+1$ узлу, но при $m \gtrsim 7$ колебания появляются и здесь. Программа предупреждает об этом прямо в окне.
6.1.2. Полином Форсайта, ортогональный (FO)
Тот же многочлен, но записанный в базисе, ортогональном на данной выборке с её весами. Базис строится трёхчленной рекуррентой прямо по точкам таблицы[1]:
Коэффициенты берутся поодиночке, без всякой системы уравнений:
$a_k = \sum_i w_i y_i p_k(X_i) \big/ \sum_i w_i p_k^2(X_i)$. Отсюда три
свойства, которых у PL нет:
- Обусловленность перестаёт существовать как проблема. Матрица плана ортогональна по построению, её показатель обусловленности равен единице при любой степени — тогда как у степенного базиса он растёт лавинообразно (6.2). В программе оба числа печатаются рядом, в одной таблице: сравните.
- Коэффициенты независимы. Ковариационная матрица диагональна, значит доверительный интервал каждого $a_k$ — настоящий, а не «при прочих закреплённых». У степенного базиса коэффициенты сильно скоррелированы, и интервал отдельного $a_k$ там говорит гораздо меньше, чем кажется.
- Коэффициент при степени $k$ не меняется при добавлении степени $k+1$. Значит весь ряд степеней получается за один проход, а вклад каждой новой степени можно сравнить с её же погрешностью — это готовое правило останова. На нём построена команда «Перебрать степени 1…8».
6.1.3. МНК по произвольному набору функций (LC)
Модель набирается из двадцати одной функции аргумента: $1$, $x \dots x^6$, $1/x \dots 1/x^4$, $\ln x$, $\lg x$, $x\ln x$, $e^{x}$, $x/(1+x)$ и корни $x^{1/2}, x^{1/3}, x^{1/4}, x^{2/3}, x^{3/4}$. Так строятся модели, которые многочленом не выражаются: степенной закон с постоянным фоном $y = c_1 + c_2 x^{1/2}$, гиперболическое затухание $y = c_1 + c_2/x$, логарифмический отклик $y = c_1 + c_2 \ln x$.
Порядок набора на результат не влияет. Подгонка зависит только от состава набора: переставив функции местами, вы получите те же самые коэффициенты при тех же самых функциях. Порядок определяет лишь порядок строк в таблице параметров.
Половина списка существует не при всех $x$ ($\ln x$, $\lg x$ и корни требуют неотрицательного аргумента, $1/x^k$ — ненулевого), а данные приходят какие есть. Поэтому применимость проверяется по всей таблице сразу, и метод отказывается внятным сообщением, а не выдаёт колонку пустых клеток.
6.1.4. Типовые уравнения (TE)
Тот же линейный МНК, что и у LC, но набор функций берётся
готовым по названию формы. Формы — те, которыми в термодинамике описывают
температурные зависимости:
| Форма | Уравнение | Членов | Откуда |
|---|---|---|---|
| обратно-квадратичная | $y = a + b/x + c\,x + d\,x^2$ | 4 | плотность и мольный объём от состава, вязкость в узком промежутке |
| теплоёмкость | $C_p = a + b\,T + c\,T^2 + d/T^2$ | 4 | Майер и Келли[32] |
| энергия Гиббса | $G = a + b\,T + c\,T\ln T + d\,T^2 + e/T$ | 5 | форма SGTE[33] |
| константа диссоциации | $\lg K = a + b/T + c\lg T + d\,T + e\,T^{2}$ | 5 | Харнед и Элерс[34] |
| степенной ряд | $y = \sum a_k x^{k}$, $k$ подряд от $-2$ до $3$ | до 6 | полином с обратными степенями |
Всё это — линейные по параметрам модели, и решаются они тем же разложением, что полином: точно, за один проход, без начальных приближений. Отдельным методом форма сделана не ради математики, а ради работы: собирать «$1 + x + x^2 + 1/x^2$» вручную каждый раз — значит держать состав в голове и рано или поздно ошибиться. Ровно та же разница, что между «замена вручную» и именованной парой «Аррениус» (6.3).
Число параметров: от двух до полного
Поле «Параметров» берёт первые $p$ членов формы, а порядок членов в форме — это порядок, в каком её принято усекать: сперва то, без чего зависимости нет, в конце — уточняющие слагаемые. У теплоёмкости последним отбрасывается $d/T^2$ (низкотемпературный член: при подгонке в узком промежутке выше комнатной он почти всегда лишний), у энергии Гиббса — $e/T$, а $c\,T\ln T$ стоит третьим и не отбрасывается раньше, потому что он приходит из интегрирования теплоёмкости и без него форма перестаёт быть той самой.
У формы «константа диссоциации» этот порядок не соглашение, а физическая лестница: она получена интегрированием уравнения Вант-Гоффа $d\ln K/dT = \Delta H/RT^{2}$, куда подставлен ряд $\Delta H = a + bT + cT^{2}$, и каждый следующий член формы отвечает следующей степени этого ряда. Поэтому два параметра здесь означают $\Delta H = \mathrm{const}$, три — $\Delta C_p = \mathrm{const}$, четыре — $\Delta C_p$ линейна по $T$, и поле «Параметров» задаёт вопрос термодинамике, а не арифметике. Разобранный пример — ниже.
Степенной ряд и сдвиг аргумента
Четвёртая форма задаётся двумя числами: низшей степенью ($1/x^2$, $1/x$,
$x^0$, $x$, $x^2$, $x^3$) и числом параметров; степени идут подряд. Низшая степень
$x^0$ даёт обычный полином — тогда лучше взять PL с его нормировкой
(6.2); произвольный набор степеней вразбивку собирается
методом LC.
У этого метода — единственного, кроме двух полиномиальных, — доступна рамка «Замена переменных», и нужна она прежде всего ради сдвига $X = x - C$. Это не удобство: члены $1/x$ и $x\ln x$ типовых форм не существуют при $x = 0$, а в термодинамике зависимость почти всегда пишут от $T - 298{,}15$ или от $t - t_0$. Сдвиг виден в заголовке колонки и в формуле модели, а коэффициенты после него относятся уже к сдвинутой переменной: свободный член сдвинутой модели — это значение функции при $x = C$.
Область определения проверяется по самой таблице: если в колонке аргумента есть ноль, форма с членом $1/x$ отказывается работать внятным сообщением, а не выдаёт колонку пустых клеток. Сдвиг — законный способ этот ноль убрать.
6.1.5. Кривая Безье (BZ)
Кривая задаётся опорными точками $\mathbf{P}_0 \dots \mathbf{P}_m$ и базисом Бернштейна[15][16]:
Параметрический характер имеет и цену. Подгоняются обе координаты как функции параметра $t$, поэтому «значение в заданном аргументе» получается не подстановкой, а прохождением по кривой: программа считает её в двух тысячах точек и находит нужную абсциссу. По той же причине производная $dy/dx$ здесь численная, тогда как у остальных трёх методов она аналитическая (6.3). Параметр берётся хордовым — накопленная длина ломаной, приведённая к единице: равномерный $t$ на неравномерных данных даёт сгущения и перехлёсты[16]. Вычисляется кривая устойчивой схемой де Кастельжо[17].
6.1.6. Сглаживающий сплайн Райнша (SS)
Единственный метод подпункта, где кривая ищется не в конечномерном базисе, а среди всех достаточно гладких функций. Минимизируется сумма двух слагаемых:
Первое слагаемое требует близости к данным, второе — гладкости: интеграл от квадрата второй производной есть мера «изогнутости» кривой, и он тем больше, чем сильнее она виляет. Множитель $\lambda$ назначает цену этому вилянию.
Два предела семейства стоит помнить наизусть:
- $\lambda = 0$ — штрафа нет, и кривая проходит через каждую точку точно: это обыкновенный интерполяционный натуральный кубический сплайн, тот самый, что в разделе 5. В программе это отдельный режим «по точкам».
- $\lambda \to \infty$ — вторая производная зануляется, и остаётся прямая наименьших квадратов. Дальше сглаживать некуда.
Между ними лежит всё остальное, и весь вопрос — чем выбрать $\lambda$. Этому посвящён отдельный раздел 6.6: именно там живёт главная мысль метода, ради которой он и включён.
Веса здесь работают в полную силу. Точка с бо́льшим $w_i$ сильнее тянет кривую к себе, поэтому режим «колонка = $\sigma$, вес $1/\sigma^2$» позволяет честно смешивать в одной таблице точные и грубые измерения — обычное дело, когда часть опыта сделана на другом приборе.
6.1.7. Регрессионный сплайн (RS)
Здесь возвращаемся к обычному МНК, но базис берётся сплайновый: кубические B-сплайны с небольшим числом узлов[23].
Модель линейна по параметрам, значит решается тем же самым разложением, что и полином, и получает те же оценки: ковариацию, доверительные интервалы, рычаги, PRESS. Отличие только в том, что стоит в колонках.
Почему именно B-сплайны, а не «кубика на каждом куске со сшивкой»? Кусочный многочлен можно записать многими способами, и выбор записи не меняет кривую, зато полностью меняет обусловленность задачи. У B-сплайнов два решающих свойства: локальность (каждая функция отлична от нуля лишь на четырёх соседних промежутках, отчего матрица плана ленточная) и разбиение единицы $\sum_j B_j(x) \equiv 1$ при $B_j \ge 0$ — колонки не растут по модулю с номером, и базис не портится с ростом числа узлов. Обычная альтернатива — усечённые степенные функции $(x-\xi)^3_+$ — этими свойствами не обладает и даёт ту же болезнь, что и степенной базис.
Расстановка узлов предлагается двух видов. Равномерная проста и предсказуема. Квантильная ставит узлы так, чтобы в каждый промежуток попало поровну точек, и нужна она там, где данные сгущены неравномерно: равномерная сетка может оставить промежуток вовсе без точек, и тогда коэффициент в нём определяется одними условиями сшивки — задача теряет ранг (нарушается условие Шёнберга–Уитни). Признак беды виден сразу: показатель обусловленности в таблице «Качество» подскакивает на несколько порядков.
6.1.8. P-сплайн Айлерса–Маркса (PS)
Метод отвечает на неприятный вопрос предыдущего: сколько узлов брать и где их ставить. Ответ Айлерса и Маркса[24] — не решать этот вопрос вовсе: взять узлов заведомо много и равномерно, а гибкость ограничить штрафом на коэффициенты:
где $\Delta^d$ — конечная разность порядка $d$ соседних коэффициентов: $\Delta^1 c_j = c_{j+1} - c_j$, $\Delta^2 c_j = c_{j+2} - 2c_{j+1} + c_j$. Замысел прост: у соседних B-сплайнов носители почти совпадают, поэтому резко различающиеся соседние коэффициенты и означают виляние кривой. Штрафовать их разности — почти то же самое, что штрафовать $\int (f^{(d)})^2$, но без всякого интегрирования.
Порядок разности задаёт, во что вырождается кривая при $\lambda \to \infty$:
| $d$ | Что обнуляется | Предельная кривая | Когда брать |
|---|---|---|---|
| 1 | $c_{j+1}-c_j$ | горизонталь | когда наклона в зависимости заведомо нет |
| 2 | $\Delta^2 c_j$ | прямая МНК | по умолчанию: тот же предел, что у сглаживающего сплайна |
| 3 | $\Delta^3 c_j$ | парабола | когда кривизна заведомо есть и её не надо гасить |
Параметров у модели больше, чем точек, и это нормально. Двадцать узлов дают двадцать четыре коэффициента, а точек в опыте бывает пятнадцать. Задача при этом вполне определённая: недостающие связи даёт штраф. Смотреть надо не на число коэффициентов, а на эффективное число параметров — см. 6.6.2.
6.2.Обусловленность: почему Форсайт, и почему не нормальные уравнения
Классический способ решить задачу наименьших квадратов — выписать нормальные уравнения $A^{\mathsf T} A\,\mathbf{c} = A^{\mathsf T}\mathbf{y}$ и обратить матрицу $A^{\mathsf T}A$. Способ этот прост, повсеместен и для этого подпункта не годится, потому что портит задачу дважды.
Во-первых, для степенного базиса матрица $A^{\mathsf T}A$ есть грамиан Вандермонда, близкий к матрице Гильберта — образцовому примеру дурной обусловленности: её показатель растёт примерно как $e^{3.5\,p}$ с числом параметров. Во-вторых, и это важнее, переход к $A^{\mathsf T}A$ возводит показатель обусловленности в квадрат[2]:
То есть задача, в которой честно можно получить восемь верных знаков, после умножения матрицы на саму себя не даёт ни одного. Поэтому в программе нормальные уравнения не составляются вовсе: решение идёт через сингулярное разложение матрицы плана, вычисляемое односторонними вращениями Якоби. Метод выбран сознательно — он даёт малые сингулярные числа с высокой относительной точностью[3], а здесь именно малые сингулярные числа и есть предмет разговора: по ним видно, что базис вырожден. Разложение годится и для вырожденной задачи, чего об обращении $A^{\mathsf T}A$ сказать нельзя вовсе; обзор устойчивых способов решать задачу МНК — у Бьёрка[4].
Перед разложением каждая колонка делится на свою норму (равновесие колонок). Без этого показатель обусловленности говорил бы больше о выборе единиц, чем о модели: колонка $x^6$ при $x\sim 300$ отличается от колонки единиц на пятнадцать порядков сама по себе, безо всякой взаимной зависимости функций. То, что печатает программа, — показатель обусловленности равновесной матрицы, он же индекс обусловленности Белсли[5], и он измеряет именно коллинеарность базиса.
| Показатель | Что это значит |
|---|---|
| до $10^3$ | здоровая задача, коэффициенты определены надёжно |
| $10^3 \dots 10^6$ | заметная коллинеарность; кривая ещё осмысленна, отдельные коэффициенты — уже хуже |
| $10^6 \dots 10^{10}$ | базис близок к вырожденному; программа предупреждает |
| больше $10^{10}$ | функции на этих данных неразличимы. Коэффициенты и их доверительные интервалы доверия не заслуживают |
Направления, вдоль которых данные не несут никакой информации, в решение не пускаются вовсе (сингулярные числа ниже порога отсекаются), поэтому программа не падает и не выдаёт бессмыслицу даже на заведомо вырожденном базисе — например, если одну и ту же функцию выбрать дважды. Но число параметров в таблице качества при этом окажется меньше числа выбранных функций: это и есть честный отчёт о том, сколько их данные на самом деле различают.
FO, а не PL. Кривая получится та же, а вот коэффициенты и
их погрешности у FO будут верными. PL имеет смысл, когда
степень невелика и нужны привычные коэффициенты при степенях, либо когда нужна
замена переменных с их наглядным толкованием.
6.3.Замена переменных
Кривая, безнадёжная для многочлена, часто становится прямой в подходящих координатах. Прямая же оценивается двумя параметрами вместо шести, устойчива, честно экстраполируется, а её наклон и отрезок имеют прямой физический смысл. Ради этого замена и делается.
| Пара | Закон | Координаты | Что означают коэффициенты |
|---|---|---|---|
| Аррениус | $k = A\,e^{-E_a/RT}$ | $\ln k$ от $1/T$ | наклон $= -E_a/R$, отрезок $= \ln A$ |
| Степенная | $y = a x^{b}$ | $\ln y$ от $\ln x$ | наклон $= b$ (порядок), отрезок $= \ln a$ |
| Экспонента | $y = a\,e^{bx}$ | $\ln y$ от $x$ | наклон $= b$, отрезок $= \ln a$ |
| Ленгмюр | $y = \dfrac{y_{\max} x}{K + x}$ | $1/y$ от $1/x$ | отрезок $= 1/y_{\max}$, наклон $= K/y_{\max}$ |
| Полулог. | $y = a + b\ln x$ | $y$ от $\ln x$ | наклон $= b$ |
Пары действуют в обе стороны: выбрав руками $\ln y$ и $1/x$, вы увидите, что список сам переключился на «Аррениус». Помимо готовых пар оба преобразования выбираются независимо из общего списка ($v$, $v - C$, $\ln v$, $1/v$, $v^2$, $v^3$, $1/v^2$, $e^{v}$, $1/(1+v)$, $\sqrt{v}$, $\sqrt[3]{v}$).
Кому замена доступна. Двум полиномиальным методам (PL,
FO) и типовым уравнениям (TE) — последним прежде
всего ради сдвига $X = x - C$, без которого члены $1/x$ и $x\ln x$ не существуют
при нулевом аргументе (6.1.4). У LC функции базиса
уже несут $\ln$, $1/x$ и корни, у BZ кривая параметрическая — замена
координат меняла бы там саму геометрию, а не только шкалу, — а у сплайновых методов
гибкости и так довольно.
Из этого следуют две вещи, обе сделанные в программе.
Первое: невязки всегда пересчитываются в исходную шкалу. Только там варианты с разной заменой переменных сравнимы между собой; в таблице «Невязки» стоит именно $y_i - \hat y_i$, а не $Y_i - \hat Y_i$ (последние доступны по галочке «в шкале подгонки»).
Второе: поправка на якобиан. Если погрешность постоянна в исходной шкале, то в преобразованной её дисперсия умножается на $(\psi')^2$, а вес — делится:
С этой поправкой подгонка в преобразованных координатах приближает подгонку в исходных, без неё — систематически смещена. Флажок отдельный, потому что бывает и обратное: если прибор даёт постоянную относительную погрешность (мостовое измерение сопротивления, счётчик импульсов), то как раз логарифмическая шкала и есть правильная метрика, и поправка не нужна.
Чётные степени необратимы на знакопеременных данных. Преобразования $y^2$ и $1/y^2$ теряют знак, и вернуться в исходную шкалу — а это обязательная часть сравнения — уже нельзя. Программа отказывает заранее, а не выдаёт кривую, которую не с чем сопоставить.
Производные при замене переменных
Модель имеет вид $y = \psi^{-1}\!\left(F(\varphi(x))\right)$, и производные собираются по правилу цепочки — аналитически, без единого численного дифференцирования:
Здесь $F$ — подобранный многочлен, $\varphi$ и $\psi$ — преобразования аргумента и функции. Проверить это легко на аррениусовской зависимости, где ответ известен точно: $dk/dT = k\,E_a/(RT^2)$ — программа даёт именно это, с точностью до шести значащих цифр.
6.4.Веса и устойчивость к выбросам
Веса
Минимизируется взвешенная сумма $\sum_i w_i \left(y_i - \hat y_i\right)^2$, и вес отвечает на вопрос «насколько этой точке верить». Программа знает четыре способа его задать:
| Режим | Вес | Когда применяют |
|---|---|---|
| единичные | $w_i = 1$ | все точки равноточны |
| колонка = вес | $w_i$ из таблицы | эмпирический случай: вес назначен по опыту работы с методикой |
| колонка = $\sigma$ | $w_i = 1/\sigma_i^2$ | статистический случай: погрешность каждой точки известна (например, из повторов). Это и есть оптимальные веса Гаусса — Маркова |
| $1/y^2$ | $w_i = 1/y_i^2$ | прибор с постоянной относительной погрешностью. Без этого режима подгонка отдаёт всё внимание большим ординатам просто из-за их масштаба |
Выбросы
Грубый промах — не редкость, а обычная часть экспериментальной работы. Беда в том, что глобальная кривая реагирует на него везде, а не рядом с ним: в подгонке участвуют все точки сразу, и одна испорченная сдвигает коэффициенты, а с ними и всю кривую. Ни выбором степени, ни сменой базиса это не лечится — лечится только сменой функции потерь.
| Функция потерь | Вес точки | Поведение |
|---|---|---|
| $L^2$ (обычный МНК) | $1$ | вклад далёкой точки растёт как квадрат расстояния |
| Хьюбер[7] | $\min\!\left(1,\; \dfrac{1{,}345}{|u|}\right)$ | вблизи — квадрат, вдали — модуль: выброс учитывается, но с ограниченным весом. Функция выпукла, сходимость гарантирована |
| Бивес Тьюки[8] | $\left[1-(u/4{,}685)^2\right]^2$ при $|u| < 4{,}685$, иначе $0$ | вклад далёкой точки обращается в ноль — она попросту отбрасывается. Устойчивее, но функция невыпукла |
Здесь $u = r_i / s$ — невязка, отнесённая к устойчивой оценке разброса $s = 1{,}4826 \cdot \mathrm{med}\,|r_i|$. Медиана взята не из любви к экзотике: среднеквадратичная оценка разброса сама испорчена тем самым выбросом, который мы ищем. Решается всё повторным взвешенным МНК[9]: подгонка — веса — подгонка, пока коэффициенты не перестанут меняться. Каждый шаг — тот же самый линейный МНК, поэтому устойчивость применима к любому из четырёх методов и включается отдельным списком, а не выбором «ещё одного метода».
Две оговорки, которые следует знать. Доверительные интервалы при устойчивой подгонке приближённые: они посчитаны с итоговыми весами, как если бы те были заданы заранее. И бивес, будучи невыпуклым, в принципе допускает зависимость итога от начального приближения (у Хьюбера этого нет). Поэтому разумный порядок работы — сначала обычный МНК, затем устойчивый, и сравнение двух колонок: если они совпали, выбросов нет, а если разошлись — вы прямо видите, каких точек это касается, по колонке невязок.
6.5.Нормы невязки: L², L¹ и L∞
До сих пор молчаливо предполагалось, что «наилучшая кривая» — та, у которой меньше сумма квадратов невязок. Предположение это настолько привычно, что его почти никогда не произносят вслух, — а оно есть выбор, и выбор не единственный. Приближать можно по любой мере отклонения:
Это три разные кривые по одним и тем же точкам, и разница между ними не
косметическая. Переключатель «Норма» в панели «Подгонка» доступен у полинома по
степеням (PL) и у набора функций (LC).
| Норма | Что минимизируется | Чем хороша | Чем плоха |
|---|---|---|---|
| L² | сумма квадратов | наилучшая оценка при нормальном шуме; есть вся статистика — σ, ковариация, интервалы, PRESS; решается точно за один проход | квадрат делает вклад далёкой точки огромным: один промах двигает кривую везде |
| L¹ | сумма модулей | вклад точки растёт лишь линейно ⇒ устойчива к промаху сама по себе; это «медианная» подгонка | решение может быть не единственным; σ и интервалы — только приближённые |
| L∞ | наибольшая невязка | даёт гарантированный коридор: наименьшую из возможных наибольших ошибок на всём отрезке | кривую определяют всего $p+1$ крайних точек; один промах владеет решением целиком |
Когда L∞ — единственно правильный ответ
Тогда, когда задача формулируется словом «допуск». Градуировочная кривая прибора, по которой потом считают чужие пробы; таблица поправок, которую надо уложить в паспортную погрешность; аппроксимация справочной зависимости для встраивания в расчёт. Во всех этих случаях спрашивают не «каково среднее отклонение», а «каково наибольшее» — и метод наименьших квадратов на этот вопрос не отвечает вовсе: он вправе допустить один крупный промах ради улучшения среднего.
Наилучшее равномерное приближение обладает свойством альтернанса (теорема Чебышёва[25]): у многочлена степени $m$ найдётся не менее $m+2$ точек, где наибольшее отклонение достигается с чередованием знака. Это не отвлечённое утверждение, а рабочая проверка: постройте вкладку «Невязки» и посмотрите на график — у правильно найденного чебышёвского приближения невязки многократно касаются коридора то сверху, то снизу. Если этого рисунка нет, подгонка не сошлась.
Как это считается. Обе неквадратичные нормы решаются повторным взвешенным МНК на том же самом разложении. Точное симплексное решение задачи наименьших модулей существует[31], но потребовало бы своей арифметики, своих проверок вырожденности и не дало бы ни ковариации, ни рычагов, которыми живёт весь подпункт, — поэтому здесь его нет. Для L¹ вес точки берётся $1/|r_i|$ (тождество $\sum|r| = \sum r^2/|r|$; снизу вес подрезан, иначе точка, на которую кривая села точно, получила бы бесконечный вес). Для L∞ работает алгоритм Лоусона[26][27]: вес точки на каждом шаге умножается на её невязку и нормируется, отчего вес постепенно сосредоточивается на точках альтернанса. Сходимость там линейная и небыстрая — отсюда триста шагов вместо пятидесяти.
6.6.Сплайновая аппроксимация: чем задать силу сглаживания
У полинома гибкость задаётся числом параметров, и оно целое: степень 3 или степень 4, среднего не дано. У сплайновых методов гибкость непрерывна, и это не мелочь, а другой способ думать о задаче. Вопрос «сколько параметров взять» заменяется вопросом «насколько сильно сглаживать», а на него, в отличие от первого, часто есть прямой ответ из опыта: настолько, насколько велика погрешность измерения.
6.6.1. Три режима задания λ — и почему их именно три
Сглаживающий множитель $\lambda$ сам по себе величина размерная (единицы
$y^2\!\cdot\! x^3$) и потому непереносимая: число, годное для одной зависимости,
ничего не значит для другой. Задавать его напрямую — плохой способ работы. Гораздо
естественнее сказать программе, какую невязку мы готовы допустить, и позволить
ей найти отвечающее этому $\lambda$ самой. Именно так устроены рабочие режимы метода
SS.
| Режим | Условие на λ | Что получается | Когда брать |
|---|---|---|---|
| По точкам | $\lambda = 0$ | кривая проходит через каждый узел ТОЧНО | как эталон для сравнения: видно, от чего именно сглаживание уводит |
| По максимальной невязке | $\max_i|y_i-f_i| = $ цель | кривая заперта в коридоре ±цель вокруг КАЖДОЙ точки | сохранение формы: когда важно не срезать особенности |
| По стандартному отклонению | $\sqrt{\sum r_i^2/n} = $ цель | ограничено среднее; отдельные точки могут отойти дальше | обычное сглаживание, когда важна гладкость результата |
| λ задана | число | то, что задали | для сравнения нескольких степеней сглаживания рядом |
| По кросс-проверке | минимум GCV | компромисс, найденный по данным | когда погрешность опыта не известна и задать цель нечем |
Разница между вторым и третьим режимами — это разница между L∞ и L², перенесённая на сглаживание, и она в точности та же, что описана в 6.5. Требование «ни одна точка не отходит дальше $\varepsilon$» строже требования «среднее отклонение равно $\varepsilon$»: при одной и той же цели равномерный режим оставляет кривой больше свободы, то есть сглаживает слабее. Практическое следствие названо автором метода прямо: режим по максимальной невязке не даёт искажать кривую. Острый пик, узкий излом, короткая ступенька переживут его, потому что срезать их больше чем на цель попросту запрещено. Режим по стандартному отклонению такой гарантии не даёт: он вправе срезать особенность, расплатившись за это малыми невязками в других местах.
Отсюда рабочее правило: цель — это паспортная погрешность прибора. Если потенциометр даёт ±0,2 мВ, а мостовое измерение — 0,3 %, то именно эти числа и надо поставить целью; кривая тогда пройдёт «внутри опыта», не изображая точности, которой нет, и не выбрасывая сведений, которые есть. Если погрешность не известна — берите режим по кросс-проверке и посмотрите, какую невязку он выберет сам: программа печатает достигнутые $\max|r|$ и СКО в таблице параметров.
Как ищется λ. И максимум невязки, и её СКО монотонно растут с $\lambda$ — от нуля при $\lambda = 0$ до невязки прямой при $\lambda \to \infty$. Значит уравнение «невязка = цель» имеет не больше одного корня, и он находится делением пополам по $\log\lambda$ — надёжно, без предположений о гладкости и без риска остановиться на плоском участке. Если цель больше, чем невязка предельно сглаженной кривой, корня нет вовсе — программа говорит об этом отдельной строкой в таблице параметров, а не возвращает молча «что получилось».
6.6.2. Эффективное число параметров: величина ДРОБНАЯ
У сглаживающего сплайна формально столько же параметров, сколько точек, а у P-сплайна их бывает и больше. Обе величины бесполезны: они не говорят, сколько свободы модель израсходовала на самом деле. Правильная мера получается из того, что при фиксированном $\lambda$ сглаживание линейно:
Величина эта называется эффективным числом степеней свободы[29][30] и проверяется на двух знакомых случаях: при интерполяции $H = I$ и $\operatorname{tr} H = n$ (израсходовано всё); у прямой наименьших квадратов $\operatorname{tr} H = 2$. Между ними величина меняется непрерывно, принимая значения вроде 4,7 — и это не условность записи, а честный ответ: кривая израсходовала между четырьмя и пятью степенями свободы.
Матрица влияния считается прогоном алгоритма по единичным векторам, причём разложение ленточной системы делается один раз. Из неё же бесплатно получаются рычаги $h_{ii}$ (а значит PRESS) и дисперсия значения в точке — то есть доверительная полоса (6.8).
6.6.3. Какой из трёх сплайнов брать
| Обстоятельство | Метод | Почему |
|---|---|---|
| Известна погрешность измерения | SS |
единственный метод, где силу сглаживания задают прямо ею |
| Нужно сохранить форму (пики, изломы) | SS, режим по max|r| |
равномерный критерий запрещает срезать особенность больше, чем на цель |
| Нужна кривая «через точки» | SS, режим по точкам |
это интерполяционный сплайн, и он же эталон для сравнения |
| Нужны доверительные интервалы КОЭФФИЦИЕНТОВ | RS |
обычная линейная модель со всей штатной статистикой |
| Данные сгущены неравномерно | RS с квантильными узлами |
иначе промежуток остаётся без точек и задача теряет ранг |
| О форме зависимости ничего не известно | PS |
λ подбирается сам по кросс-проверке, узлы выбирать не надо |
| Точек мало, а форма сложная | PS |
штраф позволяет держать больше коэффициентов, чем точек |
6.7.Как выбрать модель
Вместо неё смотрят на меры, штрафующие за лишний параметр:
| Мера | Смысл | Как читать |
|---|---|---|
| $\sigma$ | разброс относительно кривой на степень свободы | сравнивают с паспортной погрешностью прибора: $\sigma$ заметно больше неё — модель не описывает данные; заметно меньше — описывает шум |
| $R^2_{\text{скорр}}$ | доля объяснённой дисперсии со штрафом | чем больше, тем лучше; в отличие от обычного $R^2$ может падать |
| AICc[10][11] | информационный критерий с поправкой на малую выборку | минимум. Поправка здесь не роскошь: при $n/p < 40$ обычный AIC систематически берёт лишние параметры, а двадцать точек в химическом опыте — обычное дело |
| BIC[12] | то же, но штраф $\ln n$ вместо 2 | минимум; выбирает более скупую модель, чем AICc |
| GCV[13] | оценка ошибки на новых данных | минимум |
| PRESS[14] | настоящая кросс-проверка: каждая точка исключается, модель предсказывает её | минимум. Самая честная из мер — она прямо отвечает на вопрос «что модель скажет о точке, которой не видела» |
| Число смен знака | чередование знаков невязок | у чистого шума знак меняется примерно в половине переходов, то есть ожидается $(n-1)/2$. Мало смен — модель неверна ПО ФОРМЕ |
| Показатель обусловленности | различимы ли параметры вообще | см. 6.2 |
О PRESS стоит сказать отдельно, потому что мера эта на вид дорогая, а на деле бесплатная. Невязка в исключённой точке выражается через рычаг $h_i$ — диагональный элемент шляпной матрицы — простым тождеством $r_{(-i)} = r_i/(1-h_i)$, так что переподгонять модель $n$ раз не нужно[14]. В программе печатается $\sqrt{\mathrm{PRESS}/n}$ — величина той же размерности, что $\sigma$, и потому прямо с ней сравнимая. Если она вдвое с лишним превышает $\sigma$ — модель подстроилась под конкретные точки, и на новых данных так себя не поведёт.
Рычаг $h_i$ полезен и сам по себе: близкий к единице означает, что кривая проходит через эту точку лишь потому, что рядом нет других. Такая точка держит модель в одиночку[20], и если она же окажется промахом, заметить это по невязке будет невозможно — невязка у неё мала по построению.
Порядок работы
- Начните с самой простой модели, какую допускает существо задачи. Если известен закон — берите замену переменных, спрямляющую его (6.3): двухпараметрическая прямая честнее любого многочлена шестой степени.
- Постройте ряд вариантов. Команда «Перебрать степени 1…8» делает это одним нажатием — колонки лягут рядом.
- Смотрите на вкладку «Качество». Сумма квадратов будет падать всегда; ищите, где разворачиваются вверх AICc и PRESS/n. Обычно они указывают на одну и ту же степень — это и есть ответ.
- Проверьте невязки на одноимённой вкладке и на графике. Разбросаны беспорядочно вокруг нуля — модель по форме верна. Идут длинными сериями одного знака или образуют дугу — неверна, и увеличивать степень бессмысленно: нужен другой набор функций.
- Сравните с устойчивой подгонкой. Совпали — выбросов нет; разошлись — смотрите, какие точки виноваты.
- Взгляните на показатель обусловленности и на доверительные интервалы. Если интервал коэффициента шире самого коэффициента, этот параметр данными не определён, и модель следует упростить.
Разбор примера: константа диссоциации уксусной кислоты
Всё сказанное выше собирается в одном примере, и пример этот —
классический: температурная зависимость константы диссоциации уксусной
кислоты, измеренная Харнедом и Элерсом в 1933 году по ЭДС цепи без переноса
[34]. Он выбран потому, что показывает сразу три вещи,
каких не показывает подгонка полиномом: уравнение не полиномиальное и взято не из
удобства, а из термодинамики; число параметров в нём — это выбор физической
модели, а не степень свободы кривой; и коэффициенты такой модели по
отдельности могут быть не определены вовсе, когда сама кривая определена
превосходно. Пример поставляется с программой:
docs\examples\harned-acetic-acid.apr.xml — готовый файл подпункта,
harned-acetic-acid.txt — те же числа для вставки в таблицу.
Данные и почему полином здесь не годится
Тринадцать точек от 0 до 60 °C через пять градусов, $K\cdot10^{5}$:
1,657 · 1,700 · 1,729 · 1,745 · 1,753 · 1,754 · 1,750 · 1,728 · 1,703 · 1,670 · 1,633 · 1,589 · 1,542 — при 0, 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60 °C. В подпункт они подаются как $T$ (кельвины, $T = t + 273{,}15$) и $\lg K$: уравнение записано именно в этих переменных.
Константа проходит через максимум около 22 °C (авторы писали «около 23 °C»; подгонка даёт 22,3) — зависимость не монотонна, и подогнать её многочленом по $t$ ничего не стоит: три-четыре степени лягут по точкам не хуже. Только сказать по такому многочлену будет нечего. Коэффициенты полинома по температуре Цельсия не отвечают ни одной величине, которую можно измерить отдельно, а за пределами 0…60 °C он немедленно уходит в сторону. Уравнение же, о котором речь, выводится, и каждый его коэффициент означает свою термодинамическую величину.
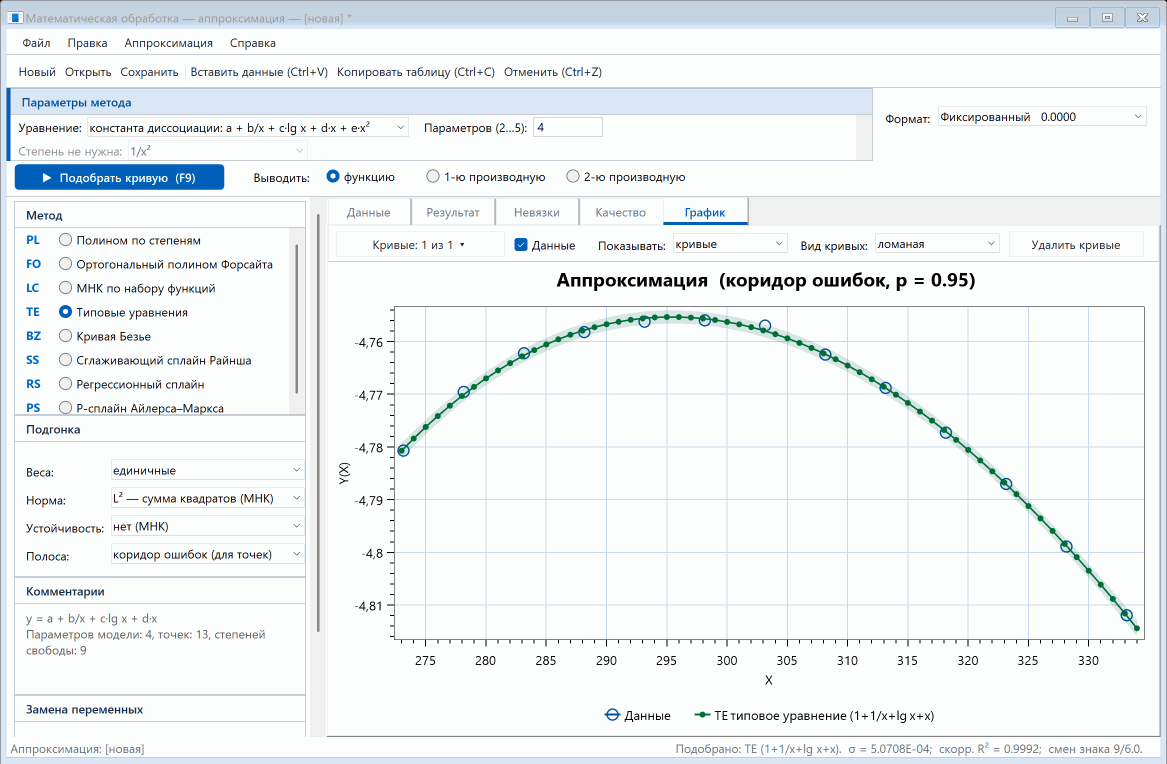
Откуда уравнение
Отправная точка — уравнение Вант-Гоффа, связывающее константу равновесия с тепловым эффектом:
Если бы $\Delta H$ не зависела от температуры, интегрирование дало бы всем известную прямую $\lg K$ от $1/T$ — и двухпараметрическую модель. Но у диссоциации слабой кислоты в воде $\Delta C_p$ велика и отрицательна, поэтому $\Delta H$ заметно меняется с температурой; Харнед и Элерс взяли для неё ряд по степеням $T$:
Подстановка этого ряда под интеграл и переход к десятичным логарифмам дают ровно ту форму, которая стоит в программе под названием «константа диссоциации»:
— постоянная интегрирования $A$ вбирает энтропийный член, а коэффициенты при $1/T$, $\lg T$ и $T$ пересчитываются обратно в ряд $\Delta H(T)$ по формулам справа. Этот обратный ход и делает подгонку осмысленной: из чисел кривой получаются измеримые величины — тепловой эффект и разность теплоёмкостей.
Уравнение линейно по параметрам $A, B, C, D, E$ — и только поэтому подпункт
решает его тем же разложением, что полином: точно, за один проход, без начальных
приближений. Нелинейность по аргументу ($1/T$, $\lg T$) на это не влияет вовсе; это
и есть содержание методов LC и TE
(6.1.3, 6.1.4).
Что получилось
Метод TE, форма «константа диссоциации», меню
«Аппроксимация ▸ Перебрать варианты» — программа строит все четыре
усечения и кладёт их рядом:
| $p$ | тепловая модель | СКО невязок | $\sigma$ | AICc | PRESS/$n$ | $\Delta H(25°)$, кал/моль | $\Delta C_p(25°)$, кал/(моль·К) |
|---|---|---|---|---|---|---|---|
| 2 | $\Delta H = \mathrm{const}$ | 0,0138 | 0,0150 | −106,2 | 0,0174 | −223 | 0 |
| 3 | $\Delta C_p = \mathrm{const}$ | 0,000436 | 0,000497 | −192,6 | 0,000538 | −105 | −37,1 |
| 4 | $\Delta C_p$ линейна (Харнед) | 0,000422 | 0,000507 | −189,0 | 0,000647 | −100 | −36,9 |
| 5 | следующая степень $\Delta H$ | 0,000421 | 0,000537 | −183,5 | 0,000969 | −101 | −36,7 |
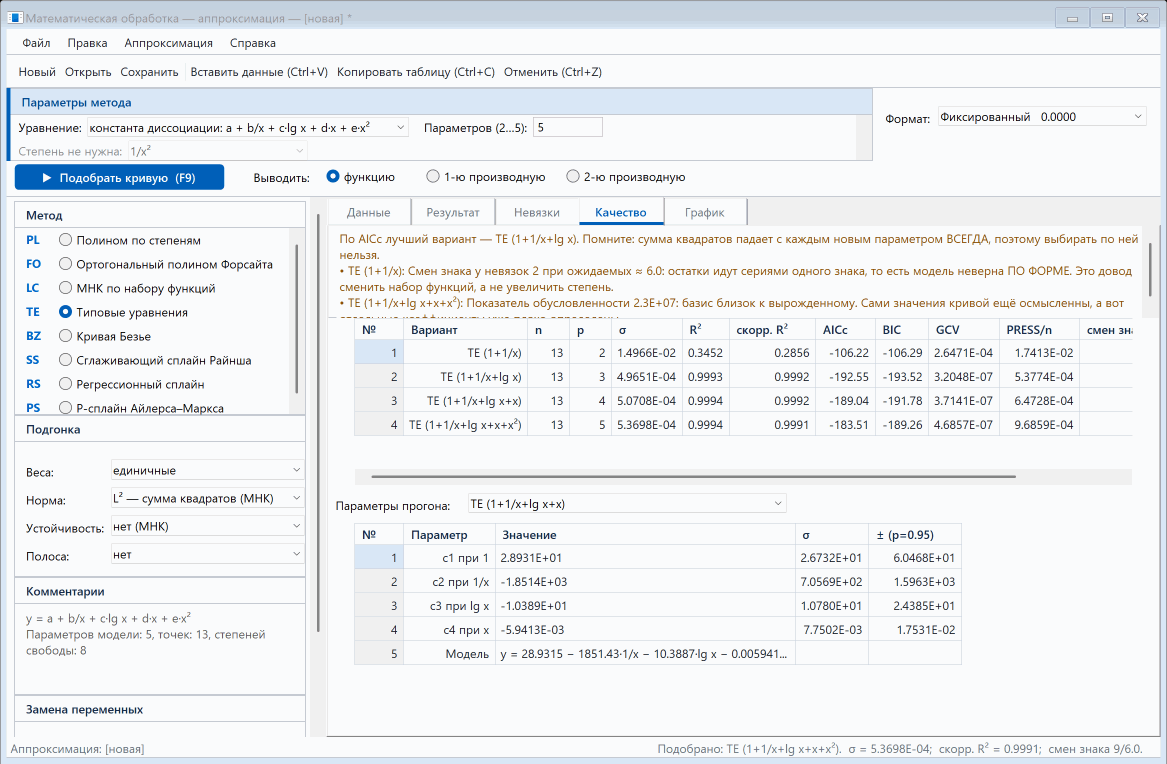
Сначала — то, ради чего таблица и строится. СКО невязок падает во всех четырёх строках подряд, от 0,0138 до 0,000421: по нему победила бы самая богатая модель, и так будет всегда. А $\sigma$, у которой в знаменателе $n-p$, уже разворачивается — её минимум приходится на три параметра, и то же самое говорят AICc и PRESS. Разница AICc между тремя и четырьмя параметрами — 3,5 единицы, то есть не «на волосок»: тринадцать точек не различают модель с постоянной $\Delta C_p$ и модель, где $\Delta C_p$ линейна по температуре. Вывод программа печатает сама, над таблицей: «по AICc лучший вариант — TE (1+1/x+lg x)».
Тот же вывод виден и без критериев — по доверительным интервалам, шестой пункт порядка действий выше. При трёх параметрах все коэффициенты определены уверенно ($C = -18{,}65 \pm 0{,}42$ при $p = 0{,}95$), а при четырёх полуширина у трёх коэффициентов из четырёх больше их самих: $C = -10{,}39 \pm 24{,}4$, $D = -0{,}00594 \pm 0{,}0175$. Данные не отличают эти члены от нуля, и добавлять их незачем.
Проверка по существу, а не по критерию: при трёх параметрах СКО невязок равно 0,00044 ед. $\lg K$, то есть 0,10 % по самой $K$, или 0,0018 в единицах $K\cdot10^{5}$. У самих авторов среднее расхождение наблюдённых и расчётных значений — ±0,003 $K\cdot10^{5}$, что отвечает 0,04 мВ на ЭДС, то есть точности их измерений. Модель уже описывает данные точнее, чем они измерены, — значит, улучшать нечего, и следующий член только опишет шум.
Кривая определена, коэффициенты — нет
Четырёхпараметрический вариант поучителен сам по себе. Опубликованное уравнение Харнеда и результат подгонки на тех же тринадцати точках выглядят как разные уравнения:
Коэффициент при $1/T$ различается на четверть, при $\lg T$ — в полтора раза. И тем не менее обе кривые совпадают: на всём промежутке 0…60 °C они расходятся не более чем на 0,003 ед. $\lg K$ — меньше, чем сами точки отклоняются от любой из них. Причину печатает сама программа: показатель обусловленности 5,4·10⁵ (по лестнице усечений он растёт как 32 → 9,0·10³ → 5,4·10⁵ → 2,3·10⁷ — на пятом параметре программа уже сама предупреждает, что базис близок к вырожденному). На шестидесяти градусах функции $1$, $1/T$, $\lg T$ и $T$ почти линейно зависимы, и подогнанный набор коэффициентов можно заметно сдвинуть, скомпенсировав сдвиг остальными, — кривая при этом не шелохнётся. Это ровно то, о чём 6.2: определена модель, а не отдельные её числа.
Производные величины: чем дальше от данных, тем хуже
Ради $\Delta H$ и $\Delta C_p$ такие измерения и делаются, и здесь видно, как быстро растёт цена. Сама кривая $\lg K(T)$ у всех разумных вариантов одна и та же в третьем знаке. Первая производная — то есть $\Delta H$ — при 25 °C выходит −105 (три параметра), −100 (четыре) и −114 кал/моль по опубликованному уравнению: разброс около 14 кал/моль на величине порядка сотни. Вторая производная — $\Delta C_p$ — даёт −37,1, −36,9 и −33,9 кал/(моль·К): расхождение уже 9 %. Каждое дифференцирование отнимает точность, и это общее свойство, разобранное в §8; здесь оно проступает на классических данных отличного качества.
Мелочь, которую стоит знать, сверяя числа с первоисточником: в 1933 году лёд принимали за 273,1 K, а не 273,15. На кривую это не влияет (сдвиг всех $T$ на 0,05 K меняет $\lg K$ в шестом знаке), но коэффициенты и производные величины от него немного зависят: печатное $\Delta H(25°) = -112$ кал/моль пересчитывается на нынешнюю шкалу в −114.
docs\examples\harned-acetic-acid.apr.xml
(«Файл ▸ Открыть») — в нём уже стоят данные, сетка аргументов и все четыре усечения;
вкладка «Качество» покажет таблицу выше. Чтобы пройти путь целиком, начните с пустого
окна: вставьте два столбца из harned-acetic-acid.txt (Ctrl+V), постройте
сетку аргументов от 273 до 334 с шагом 1, выберите метод TE, форму
«константа диссоциации», и нажмите «Аппроксимация ▸ Перебрать варианты».
6.8.Доверительные интервалы и коридор ошибок
Раз кривая проходит мимо точек, возникает законный вопрос: насколько мимо она вправе быть. Ответ даёт ковариационная матрица коэффициентов $\mathbf{C} = \sigma^2 (A^{\mathsf T}WA)^{-1}$, которую разложение отдаёт заодно с решением. Доверительный интервал коэффициента при $p = 0{,}95$:
Тот же аппарат даёт и полосу вокруг кривой. Различать надо две, и путать их — распространённая ошибка:
где $\mathbf{b}$ — строка значений функций базиса в точке $x$. Доверительная полоса показывает, где проходит истинная кривая; коридор ошибок — куда попадут отдельные измерения. Он шире ровно на $\sigma$, и именно в него должны укладываться экспериментальные точки. Узкая доверительная полоса, мимо которой лежит половина точек, — не признак плохой подгонки, а ровно то, чем она и должна быть[6].
О названии. В статистической литературе вторую полосу называют предсказательным интервалом (prediction interval)[6], и под этим именем её надо искать в справочниках. В программе она названа коридором ошибок — так понятнее, что именно она означает для экспериментатора: это коридор, в который укладывается разброс самих измерений. Название относится только к ней: доверительная полоса говорит не о разбросе точек, а о положении кривой, и «коридором ошибок» её называть нельзя.
Полоса у сплайновых методов
У регрессионного сплайна (RS) полоса считается той же формулой, что у
полинома: это обычная линейная модель, и $\mathbf{b}$ — строка значений B-сплайнов в
точке. У P-сплайна (PS) берётся байесовская ковариация
$\sigma^2(M^{\mathsf T}M)^{-1}$, где $M$ — матрица плана вместе со строками штрафа:
для штрафованных моделей она даёт хорошо откалиброванные полосы, тогда как
«частотная» их систематически занижает[28]. У
сглаживающего сплайна (SS) базиса нет вовсе, и дисперсия значения в
точке берётся прямо из матрицы влияния: $\operatorname{var}\hat f(t) =
\sigma^2 \sum_j L_j^2(t)/w_j$, где $L_j(t)$ — вклад $j$-й точки данных в значение
кривой при аргументе $t$.
6.9.Работа с программой
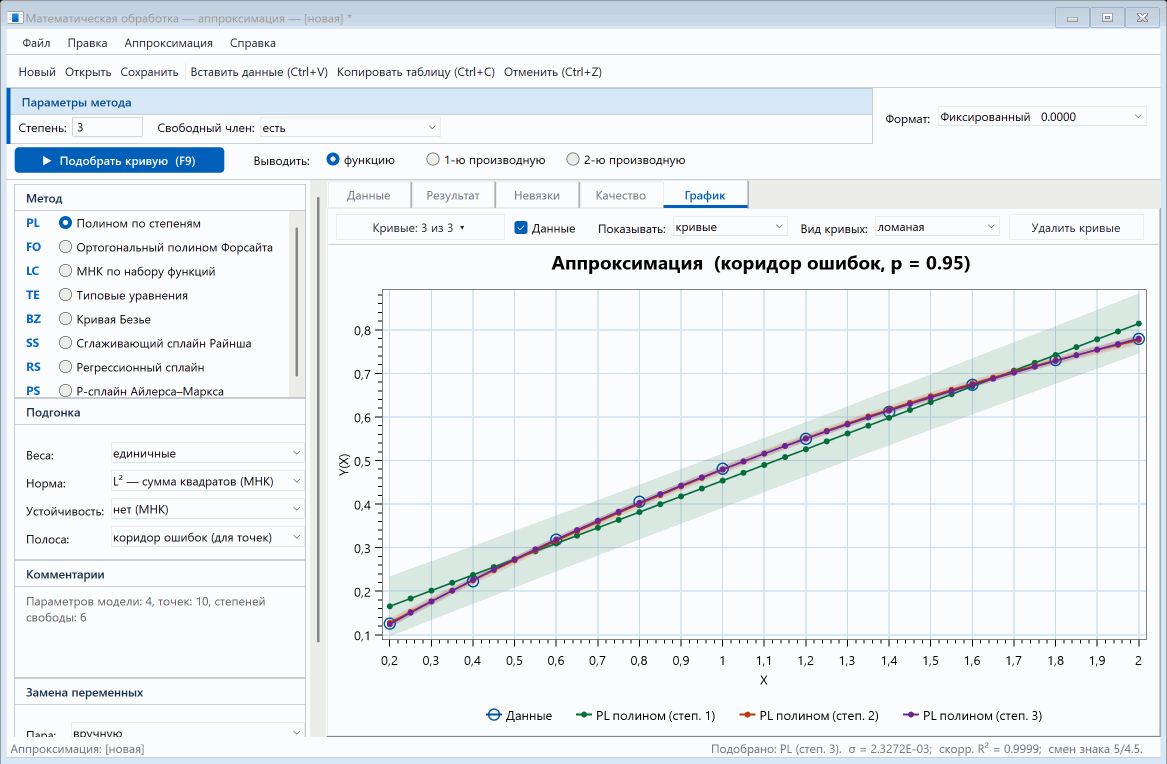
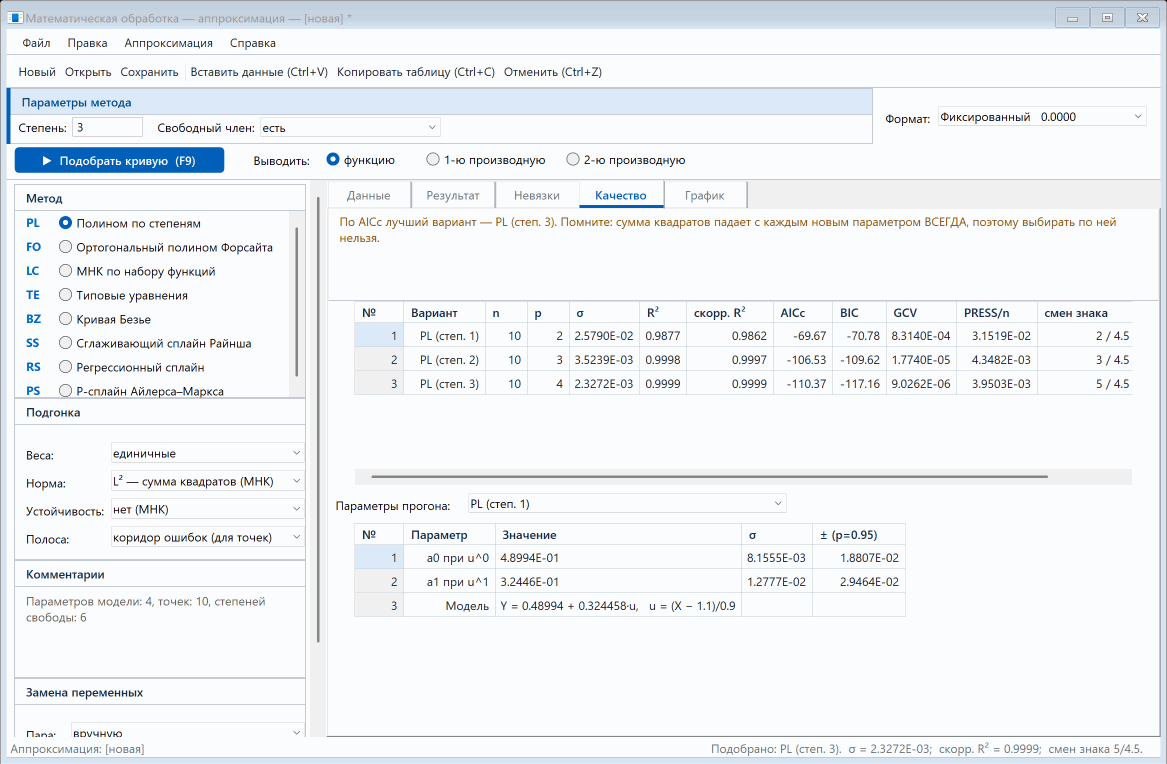
LC вместо них разворачивается конструктор набора:
выберите функцию, нажмите «Добавить», и модель тут же покажется формулой справа.
TE первым стоит
уравнение — готовая форма, — а рядом число параметров: подпись поля
показывает предел именно этой формы («Параметров (2…4)»). Третье поле, «низшая
степень», имеет смысл только у формы «полином по степеням» и у остальных гаснет.
Сама модель печатается в «Комментариях» ещё до расчёта, а сдвиг аргумента
$X = x - C$ берётся из рамки «Замена переменных» (6.1.4).
SS первым стоит режим,
и подпись соседнего поля меняется вместе с ним: «Целевая max|r|», «Целевое СКО» или
просто «λ»; в режимах «по точкам» и «по GCV» поле гаснет, потому что не значит
ничего. У RS задаются число внутренних узлов и их расстановка,
у PS — число узлов, порядок штрафа и λ, где ноль означает не
«без сглаживания», а «подобрать по кросс-проверке».
PL, FO и TE
(последнему — ради сдвига $X = x - C$); у
LC нужные функции и так есть в наборе, а BZ параметрична, и
замена координат меняла бы саму её геометрию; у сплайновых методов замена переменных
не имеет смысла — они и так следуют любой форме. Норма доступна у
PL, LC и TE; при выборе L¹ или L∞ список
«Устойчивость» гаснет — это та же ось (6.5).
PL,
FO и BZ — степени 1…8, у RS — число
узлов 0…8, у TE — число параметров от двух до полного числа
членов формы. У SS и PS перебирать нечего: их гибкость
задаётся невязкой или штрафом, и сравнивать надо несколько целей, поставленных
вручную.
Таблица параметров у сплайновых методов устроена немного иначе. Сначала идут
коэффициенты со своими $\sigma$ и доверительными интервалами (у SS это
значения кривой в узлах, у RS и PS — коэффициенты при
B-сплайнах), а затем — строки без $\sigma$: найденное λ, узловой вектор,
эффективное число параметров и достигнутые невязки. У этих величин погрешности нет и
быть не может: λ не оценивается по данным, а выбирается, и приписать ей
доверительный интервал значило бы соврать в самой честной таблице подпункта.
Экспериментальные точки на графике — полые крупные кружки, расчётные — залитые и мельче: при совпадении залитый кружок садится внутрь контура, и совпадение читается, а не превращается в слипшееся пятно. Соглашение общее для всего раздела.
6.10.Литература
Численные основания
- [1]
Forsythe G. E. Generation and use of orthogonal polynomials for data-fitting
with a digital computer. — Journal of the Society for Industrial and Applied
Mathematics, 1957, vol. 5, no. 2, p. 74–88.
Исходная работа метода
FO: трёхчленная рекуррента и правило останова по вкладу степени. - [2] Golub G. H., Van Loan C. F. Matrix Computations. — 4th ed. — Baltimore: Johns Hopkins University Press, 2013. — 756 p. Обусловленность задачи наименьших квадратов и почему $\kappa(A^{\mathsf T}A) = \kappa(A)^2$.
- [3] Demmel J., Veselić K. Jacobi's method is more accurate than QR. — SIAM Journal on Matrix Analysis and Applications, 1992, vol. 13, no. 4, p. 1204–1245. Там же по этому вопросу: Mascarenhas W. F. A note on Jacobi being more accurate than QR. — SIAM Journal on Matrix Analysis and Applications, 1994, vol. 15, no. 1, p. 215–218. Обоснование выбора одностороннего Якоби: относительная точность малых сингулярных чисел.
- [4] Björck Å. Numerical Methods for Least Squares Problems. — Philadelphia: SIAM, 1996. — 408 p. Полное руководство по устойчивым методам решения задачи МНК.
- [5] Belsley D. A., Kuh E., Welsch R. E. Regression Diagnostics: Identifying Influential Data and Sources of Collinearity. — New York: Wiley, 1980. — 292 p. (переизд.: Wiley, 2005. — 320 p.) Индекс обусловленности равновесной матрицы плана — то число, которое печатает программа.
Регрессия, веса и диагностика
- [6]
Draper N. R., Smith H. Applied Regression Analysis. — 3rd ed. — New York:
Wiley, 1998. — 736 p.
Русский перевод: Дрейпер Н. Р., Смит Г. Прикладной регрессионный анализ. — 3-е изд. — М.: Издательский дом «Вильямс», 2007. — 912 с. — ISBN 978-5-8459-0963-3. Более раннее рус. изд. в двух книгах: М.: Финансы и статистика, 1986. — Кн. 1. — 366 с.; 1987. — Кн. 2. — 351 с. Основной справочник подпункта: веса, преобразования и их цена, доверительные и предсказательные полосы, диагностика остатков. Русское издание выпущено тем же домом, который позже стал называться «Диалектика». - [20] Weisberg S. Applied Linear Regression. — 4th ed. — Hoboken: Wiley, 2014. — 368 p. Рычаг $h_i$, влиятельные наблюдения и связь PRESS с диагональю шляпной матрицы.
- [18] Box G. E. P., Cox D. R. An analysis of transformations. — Journal of the Royal Statistical Society, Series B, 1964, vol. 26, no. 2, p. 211–252. Классическая работа о преобразованиях отклика и о том, что они делают с распределением ошибки.
- [19] Lineweaver H., Burk D. The determination of enzyme dissociation constants. — Journal of the American Chemical Society, 1934, vol. 56, no. 3, p. 658–666. Двойные обратные координаты: пример спрямления, у которого цена в весах особенно велика.
Устойчивые методы
- [7] Huber P. J. Robust estimation of a location parameter. — The Annals of Mathematical Statistics, 1964, vol. 35, no. 1, p. 73–101 (перепечатано: Breakthroughs in Statistics / eds. S. Kotz, N. L. Johnson. — New York: Springer, 1992, p. 492–518). Функция потерь Хьюбера; постоянная 1,345 отвечает 95 % эффективности при нормальном шуме.
- [8] Beaton A. E., Tukey J. W. The fitting of power series, meaning polynomials, illustrated on band-spectroscopic data. — Technometrics, 1974, vol. 16, no. 2, p. 147–185. Бивес; работа примечательна тем, что написана именно про подгонку полиномов к спектроскопическим данным.
- [9] Holland P. W., Welsch R. E. Robust regression using iteratively reweighted least-squares. — Communications in Statistics — Theory and Methods, 1977, vol. 6, no. 9, p. 813–827. Тот самый повторный взвешенный МНК, которым обе устойчивые оценки и вычисляются.
Выбор модели
- [10] Akaike H. A new look at the statistical model identification. — IEEE Transactions on Automatic Control, 1974, vol. 19, no. 6, p. 716–723. Работа, которой введён информационный критерий: правдоподобие со штрафом за число параметров. Здесь он — ответ на главную методическую трудность подпункта (§6.7): сумма квадратов МОНОТОННО падает с числом параметров, поэтому выбирать модель по ней нельзя.
- [11] Hurvich C. M., Tsai C.-L. Regression and time series model selection in small samples. — Biometrika, 1989, vol. 76, no. 2, p. 297–307. Поправка AICc — она и используется по умолчанию: выборки в химическом опыте малы.
- [12] Schwarz G. Estimating the dimension of a model. — The Annals of Statistics, 1978, vol. 6, no. 2, p. 461–464. Байесовский информационный критерий: тот же вид, но штраф $\ln n$ вместо 2, то есть более строгий к лишним параметрам на длинных рядах. Стоит в сводке рядом с AICc (§6.7) намеренно — расхождение двух критериев само по себе указывает, что выбор модели данными не определён.
- [13] Craven P., Wahba G. Smoothing noisy data with spline functions. — Numerische Mathematik, 1979, vol. 31, p. 377–403. Обобщённая кросс-проверка (GCV); та же работа лежит в основе выбора параметра сглаживания в разделе 3.
- [14] Allen D. M. The relationship between variable selection and data augmentation and a method for prediction. — Technometrics, 1974, vol. 16, no. 1, p. 125–127. PRESS и тождество $r_{(-i)} = r_i/(1-h_i)$, благодаря которому кросс-проверка не требует повторных подгонок.
Сплайновая аппроксимация
- [21]
Reinsch C. H. Smoothing by spline functions. — Numerische Mathematik, 1967,
vol. 10, no. 3, p. 177–183.
Исходная работа метода
SS: сведение задачи к ленточной системе и постановка «сгладить до заданной невязки» — та самая, которой отвечают рабочие режимы программы. - [22] Schoenberg I. J. Spline functions and the problem of graduation. — Proceedings of the National Academy of Sciences USA, 1964, vol. 52, no. 4, p. 947–950. Доказательство того, что минимум функционала $\sum w_i r_i^2 + \lambda\!\int\!(f'')^2$ достигается на натуральном кубическом сплайне с узлами в точках данных.
- [23]
de Boor C. A Practical Guide to Splines. — Revised ed. — New York: Springer, 2001. — 346 p.
B-сплайновый базис, устойчивая рекуррента, условие
Шёнберга–Уитни и вся техника, на которой стоят
RSиPS. Постранично доступна: archive.org. - [24] Eilers P. H. C., Marx B. D. Flexible smoothing with B-splines and penalties. — Statistical Science, 1996, vol. 11, no. 2, p. 89–121. P-сплайны: много узлов плюс разностный штраф; разбор того, что делает порядок разности и почему выбор числа узлов перестаёт быть задачей.
- [28] Wahba G. Spline Models for Observational Data. — Philadelphia: SIAM, 1990. — 169 p. Байесовская трактовка сглаживающего сплайна и полосы, которые из неё следуют; они и используются у штрафованных моделей. Постранично доступна: archive.org.
- [29] Green P. J., Silverman B. W. Nonparametric Regression and Generalized Linear Models: A Roughness Penalty Approach. — London: Chapman & Hall, 1994. — 192 p. Веса, матрица влияния и эффективное число параметров $\operatorname{tr}H$ — то самое дробное число, которое печатает программа.
- [30] Hastie T., Tibshirani R., Friedman J. The Elements of Statistical Learning. — 2nd ed. — New York: Springer, 2009. — 745 p. Гл. 5 (с. 139–190): регрессионные сплайны, сглаживающие сплайны и сравнение их между собой по эффективному числу степеней свободы.
Нормы, отличные от L²
- [25] Cheney E. W. Introduction to Approximation Theory. — New York: McGraw-Hill, 1966. — 271 p. Теорема Чебышёва об альтернансе и вся теория наилучшего равномерного приближения. Постранично доступна: archive.org.
- [26] Lawson C. L. Contributions to the Theory of Linear Least Maximum Approximation: Ph. D. thesis. — Los Angeles: University of California, 1961. — 198 p. Алгоритм, которым чебышёвская задача сводится к последовательности обычных взвешенных МНК.
- [27] Rice J. R., Usow K. H. The Lawson algorithm and extensions. — Mathematics of Computation, 1968, vol. 22, no. 101, p. 118–127. Доказательство сходимости алгоритма Лоусона и оценка её скорости — она линейная, отсюда и число шагов в программе.
- [31] Barrodale I., Roberts F. D. K. An improved algorithm for discrete $\ell_1$ linear approximation. — SIAM Journal on Numerical Analysis, 1973, vol. 10, no. 5, p. 839–848. Точное симплексное решение задачи наименьших модулей; здесь вместо него взят повторный взвешенный МНК — тот же ответ на том же двигателе, что и все прочие методы подпункта.
Кривые Безье
- [15] Bézier P. Numerical Control: Mathematics and Applications. — London; New York: Wiley, 1972. — 240 p. Изложение метода Безье его автором. Базис Бернштейна и опорные точки — основа метода BZ (§6.1.5), единственного в подпункте, где подгоняются ОБЕ координаты как функции параметра, а не $y$ как функция $x$.
- [16] Farin G. Curves and Surfaces for CAGD: A Practical Guide. — 5th ed. — San Francisco: Morgan Kaufmann, 2002. — 509 p. Базис Бернштейна, выпуклая оболочка, хордовая параметризация и подгонка кривой к точкам.
- [17] de Casteljau P. Améliorations possibles apportées aux techniques de cotation et de calcul numérique. — Document interne P.2108, Département Outillage – Méthodes Calcul, S. A. André Citroën, Paris, 1959. Déposé à l'INPI sous Enveloppe Soleau n° 40 040. Устойчивый алгоритм вычисления кривой, найденный на четыре года раньше работ Безье, но остававшийся внутренним документом фирмы.
Типовые уравнения термодинамики
- [32] Maier C. G., Kelley K. K. An equation for the representation of high-temperature heat content data. — Journal of the American Chemical Society, 1932, vol. 54, no. 8, p. 3243–3246. Та самая форма $C_p = a + bT + c/T^{2}$, к которой с тех пор сводят табличные теплоёмкости; член $c/T^{2}$ отвечает за низкотемпературный ход.
- [33] Dinsdale A. T. SGTE data for pure elements. — Calphad, 1991, vol. 15, no. 4, p. 317–425. Стандартная форма записи энергии Гиббса $G = a + bT + cT\ln T + dT^{2} + e/T$ и порядок членов в ней — тот же, в каком форма усекается в программе.
- [34] Harned H. S., Ehlers R. W. The dissociation constant of acetic acid from 0 to 60 degrees centigrade. — Journal of the American Chemical Society, 1933, vol. 55, no. 2, p. 652–656. Первоисточник формы $\lg K = A + B/T + C\lg T + D\,T$ вместе с её выводом из уравнения Вант-Гоффа и разложения $\Delta H(T)$; тринадцать значений $K$ уксусной кислоты от 0 до 60 °C — данные разобранного примера (6.7).
7.2D аппроксимация
Зачем нужен этот подпункт
Почти всё, что известно о растворах из справочников и оригинальных статей, зависит от двух переменных сразу: плотность, диэлектрическая проницаемость, вязкость, мольный объём, предельная электропроводность — это функции состава и температуры. И напечатаны они именно так: слева колонкой состав, сверху строкой температура, внутри значения. Чтобы посчитать равновесие при 30 °C и 40 % спирта, значение нужно снять между узлами такой таблицы — и на глаз этого делать нельзя, потому что ошибка здесь уходит прямо в исходные данные расчёта и дальше уже неотличима от ошибки модели.
- смешанная производная $\partial^2 z/\partial x\,\partial y$ — от неё зависит, будет ли поверхность гладкой, и обнулить её нельзя (7.2);
- число членов модели растёт квадратично, а вместе с ним появляется выбор между «полным порядком» и «тензорным набором» степеней — это разные модели (7.3);
- сглаживание нельзя вести по осям порознь: два независимых сглаживания не решают никакой единой двумерной задачи (7.4);
- коллинеарность становится нормой: на прямоугольной сетке $x$, $y$, $xy$ и $x^2$ связаны почти линейно, и хорошая поверхность вполне может иметь бессмысленные по отдельности коэффициенты (7.7);
- класс гладкости перестаёт быть мелочью: у двух методов из пяти производная рвётся, и на графике это выглядит поломкой, хотя таково само определение метода (7.5).
Подпункт работает только с регулярной сеткой — прямоугольной таблицей, у которой есть свой вектор $X$ и свой вектор $Y$. Задача о рассеянных точках (значения измерены при произвольных, ничем не связанных парах $x,y$) — принципиально другая: там нет ни ячеек, ни строк, ни столбцов, и решается она триангуляцией, сплайнами тонкой пластины или обратными расстояниями. Ни один из этих методов сюда не входит, и это сознательное ограничение: справочные и литературные таблицы, ради которых подпункт сделан, всегда регулярны.
Раскладка таблицы: одно соглашение, и его надо знать
X \ Y — это напоминание, а не украшение. Если обозначения осей заданы
(7.9), в углу стоят они: T, K \ c, моль/л.
Оговорка не педантизм. Перепутанные оси не дают ни ошибки, ни пустого экрана: поверхность строится, числа выглядят правдоподобно, и обнаруживается подмена только тогда, когда результат расходится с опытом на десятки процентов неизвестно почему. Хуже того, в литературе (и в исходных модулях, с которых этот подпункт начинался) встречаются оба соглашения, взаимно обратные. Поэтому здесь оно названо один раз, напечатано в углу таблицы и закреплено отдельным тестом: транспонирование таблицы вместе с векторами обязано давать ту же самую поверхность.
Вектор $Y$ живёт строкой самой таблицы, а не в её заголовках колонок. Так сделано ради вставки: блок, скопированный из табличного редактора вместе с шапкой и первой колонкой, ложится в окно целиком и разом (Ctrl+V наращивает таблицу под размер вставленного). Если бы $Y$ был заголовком, его пришлось бы вводить отдельно.
Требования к таблице — три, и все три проверяются перед расчётом:
- оба вектора строго возрастают. Повтор узла — отказ («узлы должны быть различными»), убывание — отказ с предложением отсортировать таблицу (раздел 2);
- таблица заполнена целиком. Пустая клетка внутри — отказ с её номером. Сеточные методы строят поверхность по ячейке, и дырка в ячейке означает, что ячейки нет; МНК-модели пропуск бы пережили, но тогда невязки и сетка перестали бы соответствовать друг другу, а сводка качества — считаться по одному и тому же числу точек;
- узлов хватает выбранному методу: билинейной нужно $\ge 2$ по каждой оси, бикубической Лагранжа — $\ge 4$ (у неё окно $4\times4$), тензорному сплайну — $\ge 2$ в режиме «по узлам» и $\ge 4$ в режимах сглаживания.
Число точек для МНК-моделей равно произведению $n = n_x \cdot n_y$: таблица $6\times5$ — это тридцать точек. Но лежат они на решётке, а не где попало, и это ещё аукнется в 7.7.
Пять методов подпункта
| Код | Метод | Через узлы | Гладкость | Экстраполяция | Чем задаётся |
|---|---|---|---|---|---|
| BL | Билинейная по ячейке | да | $C^0$ — производная рвётся | нет | ничем |
| BC | Бикубическая по Лагранжу | да | $C^0$ — производная рвётся | нет | ничем (окно $4\times4$) |
| TS | Тензорный бикубический сплайн | по выбору | $C^2$ | нет | краевое условие + режим сглаживания |
| MR | Множественная регрессия | нет | аналитическая | да | набором членов |
| P2 | Двумерный полином | нет | аналитическая | да | степенью |
Первые три метода ничего не предполагают о законе, по которому величина зависит от аргументов: они лишь связывают соседние узлы. Последние два подбирают закон — формулу с числовыми коэффициентами, которую можно выписать, напечатать в статье и подставить в другой расчёт. Отсюда и разница в правах: продолжать закон за пределы таблицы законно, а продолжать «связку соседей» — нет (7.6).
7.1.Методы— щёлкните заголовок, чтобы свернуть
7.1.1. Билинейная по ячейке BL $C^0$
Самый простой метод раздела. Точка попадает в ячейку $[x_i;\,x_{i+1}]\times[y_j;\,y_{j+1}]$, и значение берётся по её четырём углам:
Производные берутся дифференцированием той же формулы и потому аналитические внутри ячейки: $\partial z/\partial x = \bigl[(1-v)(z_{10}-z_{00}) + v(z_{11}-z_{01})\bigr]/h_x$. Обратите внимание: по $x$ она не зависит от $x$ вовсе — то есть кусочно-постоянна поперёк линий узлов и скачком меняется при переходе через каждую из них. На графике это ступеньки (7.5).
Что метод воспроизводит точно: любую функцию вида $a + bx + cy + d\,xy$ — и больше ничего. Уже на $z = x^2$ он ошибается, причём ошибка пропорциональна квадрату шага сетки. Когда его брать: когда узлов по оси меньше четырёх (для бикубики не хватает), когда таблица заведомо грубая, и когда нужен заведомо устойчивый ответ без всяких выбросов — билинейная не может вылезти за пределы значений четырёх углов, в отличие от любой кубики.
7.1.2. Бикубическая по Лагранжу BC $C^0$
Вокруг точки выбирается окно $4\times4$ узла, и по нему строится интерполяционный многочлен третьей степени по каждой переменной — прямое обобщение локального Лагранжа из 4.1.1. Веса — произведение одномерных лагранжевых по каждой оси:
Окно выбирается тем же правилом, что и в одномерной интерполяции: берётся ближайший слева узел, отступается один влево и прижимается к краю таблицы, если места не хватило. То есть внутри таблицы окно охватывает интервал и по одному узлу с каждой стороны — это и даёт кубике «разбег». Та же конструкция хорошо известна в обработке изображений под именем кубической свёртки[5].
Производные считаются дифференцированием самих весов, аналитически. Заметим одну техническую подробность, которая сберегает нервы: привычная краткая запись $L'(t) = L(t)\sum_j 1/(t-t_j)$ здесь не годится — она обращается в неопределённость ровно в узлах, а попасть в узел проще простого, потому что сетка аргументов часто строится от того же минимума круглым шагом. Поэтому производная произведения раскрывается честной суммой по снятому множителю.
Что метод воспроизводит точно: полную бикубику, то есть любой многочлен степени не выше третьей по каждой переменной в отдельности (включая $x^3y^3$). Требует не меньше четырёх узлов по каждой оси.
7.1.3. Тензорный бикубический сплайн TS $C^2$
Рабочая лошадь подпункта и единственный метод, дающий непрерывную производную по обеим осям. Восходит он к работе де Бура 1962 года[1], строится в два приёма — и именно в этом «тензорном» устройстве вся суть, поэтому ему отведён отдельный подраздел 7.2. Здесь — краткая сводка.
Сначала по таблице считаются наклоны в узлах: обычным кубическим сплайном из 5.1.1 — вдоль $X$ в каждом столбце (получается $\partial f/\partial x$) и вдоль $Y$ в каждой строке (получается $\partial f/\partial y$). Затем тем же сплайном вдоль $Y$, но уже по найденным $\partial f/\partial x$, считается смешанная производная $\partial^2 f/\partial x\,\partial y$. После этого каждая ячейка описывается эрмитовой заплатой по шестнадцати числам — четырём углам, в каждом из которых известны значение, оба наклона и смешанная производная.
Все пять краевых условий из 5.2 доступны и применяются по обеим осям сразу. Умолчание — «не-узел»: оно ничего о крае не предполагает. «Естественное» ($y''=0$) для опытной таблицы обычно ложно и распрямляет крайние интервалы по всему периметру — сразу с четырёх сторон, а не с двух концов, как в одномерной задаче; программа об этом предупреждает.
Тонкость, о которой стоит знать: заданные пользователем числовые значения краевых производных («задана $y'$», «задана $y''$») относятся к самой функции, а не к её наклону, поэтому для смешанной производной они бессмысленны. Там берётся тот же вид условия, если он значений не требует (естественное, параболическое), иначе — «не-узел».
Помимо интерполяции «по узлам» метод умеет сглаживать — тремя способами, и им отведён подраздел 7.4. Именно в сглаживающих режимах у прогона появляются невязки, статистика и эффективное (дробное) число параметров.
7.1.4. Множественная регрессия MR закон
Модель — сумма членов, каждый из которых есть произведение двух одномерных функций:
Функции $f$ и $g$ берутся из того же набора двадцати, что и в одномерной аппроксимации ($1$, $x \dots x^6$, $1/x \dots 1/x^4$, $\ln x$, $x\ln x$, $e^{x}$, $x/(1+x)$ и пять корней), поэтому одним и тем же механизмом описываются и обычный двумерный полином $x^a y^b$, и смешанные формы вроде $\dfrac{\ln y}{x}$ — например, зависимость Робинсона — Стокса $a + b/x + cx + dx^2$, у которой каждый коэффициент, в свою очередь, зависит от температуры.
Решается она тем же SVD-двигателем, что и одномерная аппроксимация (6.2): нормальные уравнения не составляются вовсе, потому что переход к ним удваивает показатель обусловленности, а он здесь и без того велик. Одно разложение отдаёт сразу коэффициенты, ковариацию, диагональ шляпной матрицы (из неё PRESS получается даром) и число обусловленности.
Набор членов выбирается из пяти готовых: плоскость $1,x,y$; билинейная
$1,x,y,xy$; полная квадратичная; квадратичная с добавленными $x^2y$ и $xy^2$;
полная кубическая. Начинать следует с плоскости и усложнять модель только
тогда, когда невязки идут сериями одного знака: это признак того, что модель
неверна по форме, а вовсе не того, что не хватает степени. Ровно так же, как
LC относится к PL в одномерном случае, MR
отличается от P2 тем, что здесь набор членов выбирается, а не
выводится из степени.
Подгонка идёт в исходных переменных, без приведения к $[-1;1]$. Это не небрежность: базис содержит $\ln x$ и $1/x$, а приведение переменной меняет смысл таких функций и легко выводит их за область определения (сдвинутая переменная становится отрицательной, и логарифма нет). Ценой служит худшая обусловленность — за ней и надо следить по VIF (7.7).
7.1.5. Двумерный полином P2 закон
Тот же двигатель, но набор членов задаётся не перечислением, а степенью:
Какие именно пары $(a,b)$ входят в сумму — полный порядок ($a + b \le m$) или тензорный набор ($a \le m_x$, $b \le m_y$) — решает отдельный переключатель, и это разные модели; им посвящён подраздел 7.3.
Наибольшая допустимая степень по одной оси — шесть. Программа предупреждает, когда членов набирается больше половины числа узлов (степеней свободы почти не остаётся, и поверхность начинает воспроизводить шум), и отказывается считать, когда членов больше, чем узлов вообще.
7.2.Что значит «тензорное построение»
Слово «тензорный» пугает больше, чем следует. Оно означает ровно одно: поверхность строится одномерным методом сначала вдоль одной оси, потом вдоль другой, и результат не зависит от того, с какой начали. Последнее — не пожелание, а свойство: на полной прямоугольной сетке операторы построения по разным осям коммутируют[7]. Именно поэтому построение однозначно и метод вообще имеет право называться методом; экстремальные свойства такой поверхности (она, как и одномерный сплайн, минимизирует полную кривизну) разобраны в классической монографии[4].
Этот тест ловит разом три самые вероятные ошибки: перепутанные оси, неверно выбранное окно и потерянное краевое условие. И им же можно пользоваться руками: постройте в подпункте «Сплайны» кривую по одному столбцу вашей таблицы, а здесь — сечение при соответствующем $y$, и сравните колонки. Если они разошлись, дело не в физике.
7.2.1. Смешанная производная: шестнадцать чисел на ячейку
В одномерном случае кубика на отрезке однозначно задаётся четырьмя числами — значениями и наклонами на двух концах (эрмитова форма, 5.1.2). В двумерном ячейка имеет четыре угла, и в каждом нужно знать четыре величины. Всего шестнадцать:
| Величина | Смысл | Откуда берётся |
|---|---|---|
| $f$ | значение | из таблицы |
| $f_x$ | наклон вдоль $X$ | сплайн по столбцу |
| $f_y$ | наклон вдоль $Y$ | сплайн по строке |
| $f_{xy}$ | смешанная производная | сплайн вдоль $Y$ по уже найденным $f_x$ |
Сама заплата — двойная сумма по эрмитову базису:
где чётные номера отвечают значениям, нечётные — наклонам, а $M_{ab}$ и есть та самая матрица шестнадцати чисел (её угол с двумя нечётными номерами — как раз $f_{xy}$). Множитель $h$ у наклонных функций стоит затем, чтобы базис работал с настоящими производными, а не с их безразмерным подобием: иначе результат зависел бы от единиц измерения аргумента.
Считать $f_{xy}$ можно двумя путями — сплайном вдоль $Y$ по $f_x$ или сплайном вдоль $X$ по $f_y$. На полной сетке они дают один и тот же ответ, и это та же коммутативность, с которой начался подраздел; в программе берётся первый путь.
7.2.2. Поверхность строится один раз
Всё, что зависит только от данных, — наклоны, смешанные производные, коэффициенты МНК — считается единожды, при нажатии «Построить поверхность». После этого вычисление в любой точке стоит постоянного времени: найти ячейку двоичным поиском и сложить шестнадцать произведений. Это стоит знать по двум причинам. Во-первых, сетку аргументов можно делать сколь угодно частой — цена линейна по числу точек, а не квадратична. Во-вторых, все три матрицы — значение, $\partial Z/\partial X$ и $\partial Z/\partial Y$ — считаются сразу, за один проход, и переключатель «Выводить» в окне ничего не пересчитывает, а лишь показывает уже готовое.
7.3.Полный порядок или тензорный набор степеней
Это единственный вопрос двумерного полинома, у которого нет одномерного прообраза, — и потому самый частый источник недоразумений. «Полином второй степени» в двух переменных может означать две разные вещи.
- Полный порядок: берутся все члены $x^a y^b$ с $a + b \le m$ — треугольник Паскаля. Степень понимается как суммарная.
- Тензорный набор: берутся все члены с $a \le m_x$ и $b \le m_y$ по отдельности — прямоугольник в решётке степеней. Степень понимается покоординатно.
| Степень $m$ | Полный порядок $\dfrac{(m+1)(m+2)}{2}$ | Тензорный $m\times m$: $(m+1)^2$ | Чего нет в полном |
|---|---|---|---|
| 1 | 3 | 4 | $xy$ |
| 2 | 6 | 9 | $x^2y,\; xy^2,\; x^2y^2$ |
| 3 | 10 | 16 | шесть членов, включая $x^3y^3$ |
| 4 | 15 | 25 | десять членов |
| 6 | 28 | 49 | двадцать один член |
Что брать. По умолчанию — полный порядок: он растёт медленнее, реже вырождается и почти всегда достаточен для гладкой физической зависимости. Тензорный набор оправдан в одном случае: когда известно, что зависимость по каждой переменной сама по себе высокой степени, а взаимодействие между ними «мультипликативно» — скажем, величина есть произведение функции состава на функцию температуры. Тогда члены вида $x^a y^b$ с большими $a$ и $b$ несут смысл, а не подгоняют шум.
В режиме «полный порядок» поле «Степень по $Y$» не участвует в расчёте: суммарная степень задаётся полем «Степень по $X$». Так устроено намеренно — у полного порядка второй степени просто нет.
7.4.Сглаживание поверхности
Табличные данные расходятся с истиной по трём причинам, и все три встречаются в справочниках: погрешность самого измерения; округление при печати (последний напечатанный разряд — это уже неопределённость); и «сшивка» участков, измеренных разными авторами разными способами. Требовать от поверхности пройти через каждый такой узел — значит требовать воспроизвести все эти дефекты в точности. Отсюда режимы сглаживания у тензорного сплайна.
7.4.1. Одно λ на всю поверхность — и почему это принципиально
Подгонка поверхности сплайнами — предмет обширный[9], но в задаче «регулярная сетка плюс погрешность» весь вопрос сводится к одному числу $\lambda$: насколько мы доверяем данным. Напрашивающееся решение — сгладить каждую строку и каждый столбец по отдельности, подобрав для каждой своё $\lambda$. Так поступает не одна известная реализация, и так делать нельзя. Разные сечения окажутся сглажены с разной силой, и получившийся набор чисел не будет решением никакой единой двумерной задачи: по оси $X$ у него одна степень доверия к данным, по оси $Y$ — другая. Сравнивать такие поверхности между собой бессмысленно, а эффективное число параметров у них попросту не определено.
Поэтому здесь $\lambda$ одно на всю поверхность, а перед сглаживанием обе оси приводятся к отрезку $[0;\,1]$. Приведение обязательно: штраф наказывает кривизну $\int (f'')^2$, а вторая производная имеет размерность $Z$, делённую на квадрат аргумента. Если состав меняется от 0 до 1, а температура от 273 до 373 К, то одно и то же $\lambda$ без приведения означало бы сглаживание, различающееся по осям на десять порядков.
7.4.2. Три способа задать силу сглаживания
| Режим | Что задаётся | Что происходит |
|---|---|---|
| по узлам (точно) | ничего | $\lambda = 0$: обычная интерполяция, невязок нет |
| по макс. невязке | величина в единицах $Z$ | норма $L^\infty$: поверхность заперта в коридор $\pm$цель вокруг каждого узла — форма сохраняется |
| по СКО | величина в единицах $Z$ | норма $L^2$: критерий агрегатный — форма может измениться |
| λ задана | само $\lambda$ | для повторения чужого результата и для ручного перебора |
Что ставить целью. Разумный выбор — погрешность прибора в единицах $Z$, а для справочной таблицы — единица последнего напечатанного разряда. Смысл прост: мы разрешаем поверхности отклоняться от данных ровно настолько, насколько данные и так не определены. Цель, заданная меньше шума, ничего не даёт (поверхность пойдёт практически по узлам); цель, заданная заметно больше, начнёт срезать реальные особенности.
7.4.3. Как подбирается λ, и что означают отказы
Отклонение сглаженной поверхности от таблицы монотонно растёт с $\lambda$. Значит, здесь решается уравнение «отклонение = цель», а не задача оптимизации, и золотое сечение (поиск минимума) для неё — неверный инструмент. Программа делит пополам по $\log_{10}\lambda$ в пределах от $10^{-14}$ до $10^{14}$, шестьдесят шагов; это покрывает любой мыслимый случай и всегда сходится.
Два краевых исхода описаны словами, а не молчанием:
- цель недостижима — даже предельное сглаживание даёт отклонение меньше заданного (обычно это значит, что цель поставлена больше размаха самих данных). Возвращается предельно сглаженная поверхность, и прогон помечается как не достигший цели;
- цель слишком мала — её не выполняет даже наименьшее $\lambda$. Поверхность идёт практически по узлам, и это честный ответ: сгладить сильнее, оставаясь в таком коридоре, невозможно.
Отдельный случай: цель оставлена нулевой. Тогда поверхность строится точно по узлам, а жёлтая полоса в «Комментариях» прямо говорит, что сглаживание не работает, пока не введена величина. Молчаливое «сглаживание с нулевой целью» выглядело бы как поломка метода.
7.5.Производные по каждой оси
Частные производные $\partial Z/\partial X$ и $\partial Z/\partial Y$ считаются у всех пяти методов и всегда аналитически: у сеточных — дифференцированием той самой заплаты, которой описана ячейка, у МНК-моделей — дифференцированием базиса, $\partial^{a+b}\!\bigl[f(x)g(y)\bigr] = f^{(a)}(x)\,g^{(b)}(y)$. Численных производных (разностей) в подпункте нет вовсе — в отличие от цепной дроби Тиле в 4.1.8, где их избежать не удалось.
Но аналитическая и непрерывная — не одно и то же, и вот тут методы расходятся принципиально:
| Метод | Значение | Первая производная | Вторая производная |
|---|---|---|---|
| BL | непрерывно | рвётся на линиях узлов; между ними постоянна | тождественно нуль внутри ячейки |
| BC | непрерывно | рвётся в узлах (там меняется окно $4\times4$) | рвётся |
| TS | непрерывно | непрерывна | непрерывна ($C^2$); третья рвётся |
| MR, P2 | поверхность аналитическая всюду — производные любого порядка непрерывны | ||
Разрыв производной у локальных схем — не особенность этой программы, а общее место всех методов, работающих по скользящему окну; о нём прямо предупреждают и руководства[6].
Ещё одно наблюдение, которое стоит держать в голове: дифференцирование усиливает шум. Если исходная таблица зашумлена, то поверхность, прошедшая через все узлы точно, даст производную, скачущую от ячейки к ячейке, — и это будет производная шума, а не зависимости. Правильный порядок действий в таком случае: сначала сгладить (TS в режиме «по макс. невязке» с целью, равной погрешности), и уже у сглаженной поверхности брать производную. Тот же довод, что открывает введение.
7.6.Экстраполяция: разрешена по типу метода
В интерполяции и сплайнах действовало единое правило: за пределами таблицы — прочерк. Здесь правило зависит от метода, и это не непоследовательность, а прямое следствие того, чем метод является.
| Методы | Вне прямоугольника данных | Почему |
|---|---|---|
| BL, BC, TS | прочерк | метод не знает никакого закона — он лишь связывает соседние узлы. За крайним узлом кубика уходит как куб расстояния, и выдать это за результат значило бы обмануть |
| MR, P2 | считается | подобран закон с числовыми коэффициентами, и продолжить его законно |
Построитель сетки аргументов («Построить») прижимает границы к таблице и говорит об этом в строке состояния. Вывести сетку за пределы данных можно — векторы $X_{int}$ и $Y_{int}$ правятся вручную и вставкой из буфера; для сеточных методов там будет прочерк, для МНК-моделей — числа.
7.7.Регрессионный анализ: нужен ли каждый член
Меры качества, общие для всего раздела 6 ($\sigma$, AICc, GCV, PRESS), отвечают на вопрос «хороша ли модель целиком». Регрессионный анализ спрашивает другое и по каждому члену отдельно: «нужен ли он вообще». Для двумерных моделей это не роскошь, а необходимость — членов в них много, и половина обычно лишняя. Изложение ведётся в объёме, достаточном для работы; полное — в руководствах по регрессионному анализу[12].
7.7.1. Коэффициент, его погрешность, t и p
Ковариационная матрица оценок[13] даёт каждому коэффициенту свою погрешность $\sigma_j = \sigma\sqrt{(\mathbf{X}^{\top}\mathbf{X})^{-1}_{jj}}$, где $\sigma^2 = \mathrm{RSS}/(n-p)$. Из неё получаются три числа, стоящие в таблице «Качество» рядом с коэффициентом:
$t_j$ — во сколько раз коэффициент больше собственной погрешности. $p_j$ — вероятность получить такое $t$ случайно, если истинный коэффициент равен нулю. $\Delta_j$ — полуширина доверительного интервала при $p = 0{,}95$; коэффициент печатается как $c_j \pm \Delta_j$.
Вероятность считается по распределению Стьюдента[16] через регуляризованную неполную бета-функцию, вычисляемую цепной дробью в схеме Лентца[17]. Это не «таблица квантилей»: нужна именно функция распределения, по своему аргументу для каждого коэффициента.
7.7.2. Дисперсионный анализ: лучше ли модель, чем одно среднее
Полная сумма квадратов разбивается на объяснённую и остаточную, и их средние квадраты сравниваются по критерию Фишера:
Смысл: объясняет ли модель больше, чем объяснило бы одно среднее значение. Малое $p$ при $F$ означает «да». Обратите внимание на неочевидное: модель может иметь прекрасный $R^2$ и не пройти этот критерий — так бывает, когда параметров почти столько же, сколько узлов. $R^2$ такой ситуации не различает вовсе (он растёт с каждым добавленным членом механически), а $F$ различает, потому что делит на степени свободы.
7.7.3. Коллинеарность и VIF — главная особенность двумерного базиса
На регулярной прямоугольной сетке члены $x$, $x^2$, $xy$, $x^2y$ и подобные сильно связаны между собой: узлы лежат не где попало, а по решётке, и значения одних членов почти линейно выражаются через другие. Это не патология данных, а свойство самого плана эксперимента, и в двух измерениях оно встречается почти всегда. Мера связи — фактор инфляции дисперсии:
где $R^2_j$ — коэффициент детерминации регрессии $j$-го члена на все остальные. Считается он даром: это в точности диагональ обращённой корреляционной матрицы предикторов, так что $p$ отдельных регрессий строить не нужно. Постоянная колонка (свободный член) предиктором не является и получает прочерк.
| VIF | Что это значит |
|---|---|
| $\approx 1$ | член независим от остальных; коэффициент определён хорошо |
| $2 \dots 5$ | заметная связь; интервал коэффициента вдвое-втрое шире, чем был бы |
| $> 10$ | коэффициенты по отдельности не определяются; программа выводит замечание[15] |
| сотни | базис практически вырожден — понижайте степень или убирайте члены |
Чем лечится. Тремя средствами, в порядке предпочтения: приведение переменных (для полинома оно уже сделано — на степенях сырой температуры VIF доходит до сотен, на приведённой к $[-1;1]$ падает до единиц; на ортогональном плане он в точности равен единице); понижение степени; отказ от незначимых членов по $p$. Рядом с VIF стоит показатель обусловленности из SVD-разложения — он говорит о том же самом с другой стороны, для всего базиса разом, и оба показателя восходят к одной и той же работе о диагностике плана эксперимента[14].
Корреляционная матрица оценок коэффициентов (не путать с корреляцией предикторов) вычисляется из ковариационной и показывает, какие именно пары коэффициентов «перетекают» друг в друга.
7.7.4. Замечания, которые программа делает сама
Под таблицей разбора появляются три вида замечаний, и каждое требует действия:
7.8.Как выбирать метод
Выбор здесь определяется не «точностью» (все пять методов точны в своей области), а двумя вопросами о задаче и одним — о данных.
| Задача | Что брать |
|---|---|
| Снять значение из справочной таблицы | TS, режим «по узлам» |
| То же, но узлов по оси меньше четырёх | BL или TS |
| Своя таблица с погрешностью, нужно значение | TS, «по макс. невязке», цель = погрешность прибора |
| Нужна $\partial Z/\partial X$ или $\partial Z/\partial Y$ | TS (после сглаживания, если данные зашумлены) |
| Нужна формула для статьи или для другого расчёта | P2, начиная с полного порядка 2; затем MR с отбором членов |
| Нужно значение за пределами таблицы | MR или P2, с оговоркой |
| Проверить, нет ли в таблице опечатки | TS «по макс. невязке» + карта невязок: опечатка выделяется одиноким крупным кружком |
В сводке качества у прогонов, идущих точно через узлы, строка пуста и стоит «проход по узлам — мерить нечего». Это не отказ и не поломка: у такой поверхности невязки тождественно нулевые, и любые меры качества, посчитанные по ним, были бы фикцией.
Разбор примера: диэлектрическая проницаемость вода – 1,4-диоксан
Всё сказанное выше собирается в одном примере, и взят он из работы, к которой
обращается всякий, кто считает равновесия в смешанном растворителе: Окерлёф и Шорт
измерили диэлектрическую проницаемость смесей воды с 1,4-диоксаном от 0 до
80 °C по всему ряду составов [18]. Величина эта
нужна не сама по себе — из неё считаются коэффициенты $A$ и $B$ уравнения
Дебая — Хюккеля, а значит, без неё не берётся ни одна константа устойчивости в
неводной среде. Пример поставляется с программой:
docs\examples\akerlof-dioxane.ap2.xml — готовый файл подпункта,
akerlof-dioxane-check.ap2.xml — та же таблица без одного среза (проверка,
о которой речь ниже), akerlof-dioxane.txt — те же числа для вставки
(Ctrl+V).
Поверхность, у которой оси ведут себя по-разному
Девять температур (0…80 °C через десять) на девять составов (0…80 масс. % диоксана через десять) — 81 узел. Случай непростой, и это видно по числам: вдоль состава $\varepsilon$ падает с 88,31 до 12,19, то есть в семь раз, а вдоль температуры — с 88,31 до 60,58, то есть на треть. Падает притом по-разному: по температуре зависимость почти показательная и совершенно гладкая, по составу — с заметным изгибом у диоксанового края, где вода перестаёт задавать свойства среды. Двумерная задача здесь не сводится к двум одномерным «на глаз»: шаг, достаточный по одной оси, по другой оказывается либо избыточным, либо грубым.
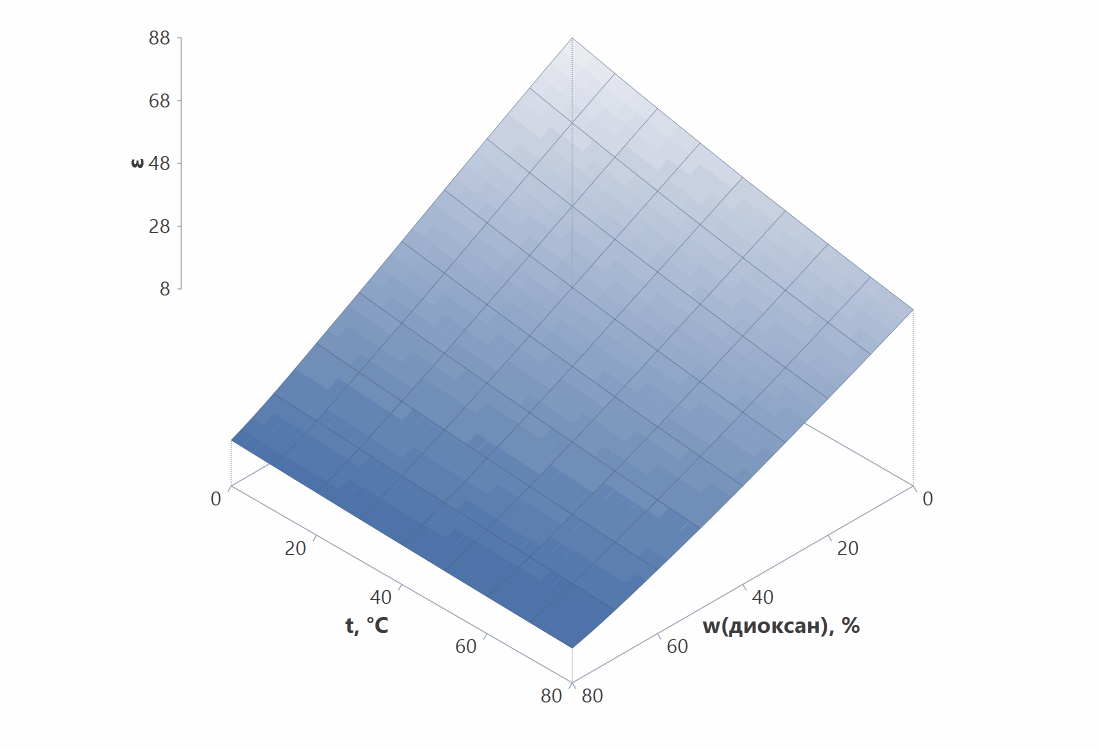
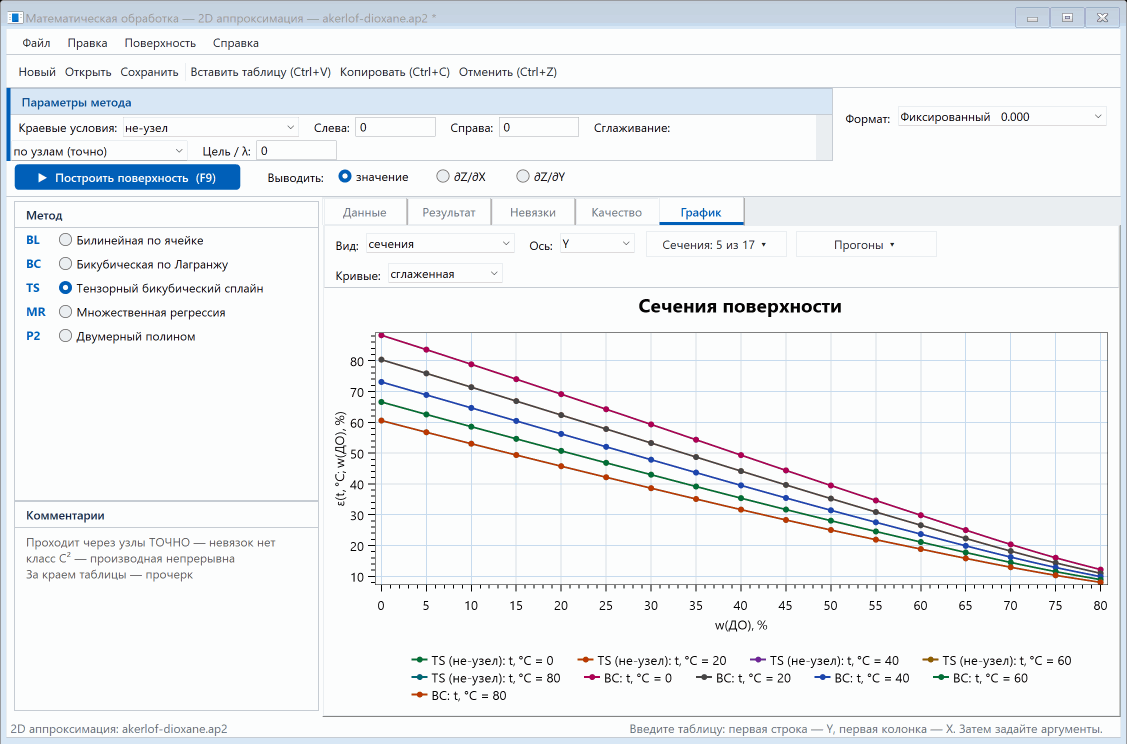
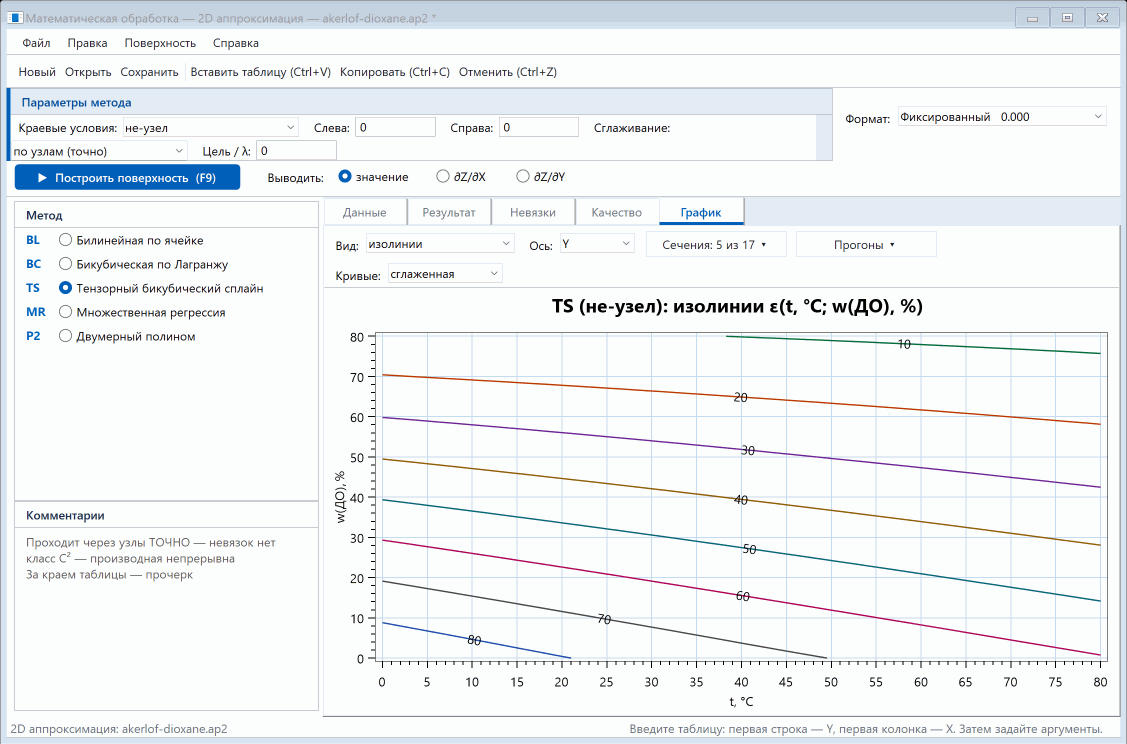
.txt. Первая: в статье подписи осей таблицы переставлены
местами. Стуб подписан «Dioxane, wt. %», шапка — «Temperature, °C», а по
числам всё наоборот: строки суть температура, столбцы — состав. Проверяется мгновенно
и без всякой химии — первый столбец (88,31 … 60,58) есть в точности
$\varepsilon$ чистой воды при 0…80 °C, а последний (2,109 … 2,090) —
чистого диоксана; прочтение «как подписано» дало бы у воды при 100 °C значение
2,109. Вторая: опечатка в клетке $t = 60$ °C, $w = 10$ % — напечатано
68,60 при верном 58,60. Её видно тремя независимыми способами: по гладкости столбца
(соседи 61,57 и 55,77), по постоянству отношения соседних значений вдоль температуры
и — окончательно — по собственному уравнению авторов $\lg D = \lg a - b\,t$,
коэффициенты которого напечатаны там же ($\lg a = 1{,}8969$, $b = 0{,}00215$ при
$w = 10$ %): оно даёт ровно 58,60. В поставляемом файле стоит исправленное
значение.
Как проверяют метод, который проходит через узлы
У интерполирующей поверхности невязок нет по построению, и мерить в узлах
нечего: строка мер качества у такого прогона пуста (7.8).
Единственная честная проверка — утаить у таблицы целую линию, построить
поверхность по остальным узлам и сравнить восстановленный срез с тем, что напечатано
в справочнике. Ровно это и лежит в файле akerlof-dioxane-check.ap2.xml:
таблица там без строки $t = 50$ °C, а сетка аргументов состоит из одного этого
значения.
Так измеряется верхняя оценка, а не рабочая точность. Утаив линию, мы заставляем поверхность перешагнуть двойной интервал: соседи утаённой линии отстоят от неё на 10, а друг от друга — на 20. При обычной работе, когда все узлы на месте, интерполировать приходится вдвое более короткий интервал, и ошибка там заведомо меньше — насколько именно, измерено ниже.
Срез $t = 50$ °C: восстановлены 9 значений по 72 узлам
| Метод | макс $|\Delta|$ | скз | макс $\delta$, % | ср $\delta$, % |
|---|---|---|---|---|
| BC бикубическая по Лагранжу | 0,062 | 0,021 | 0,088 | 0,022 |
| TS тензорный сплайн, не-узел | 0,070 | 0,024 | 0,100 | 0,024 |
| BL билинейная | 0,080 | 0,052 | 0,168 | 0,128 |
| P2 полный порядок 4 | 0,100 | 0,046 | 0,445 | 0,139 |
| P2 полный порядок 3 | 0,199 | 0,098 | 0,938 | 0,320 |
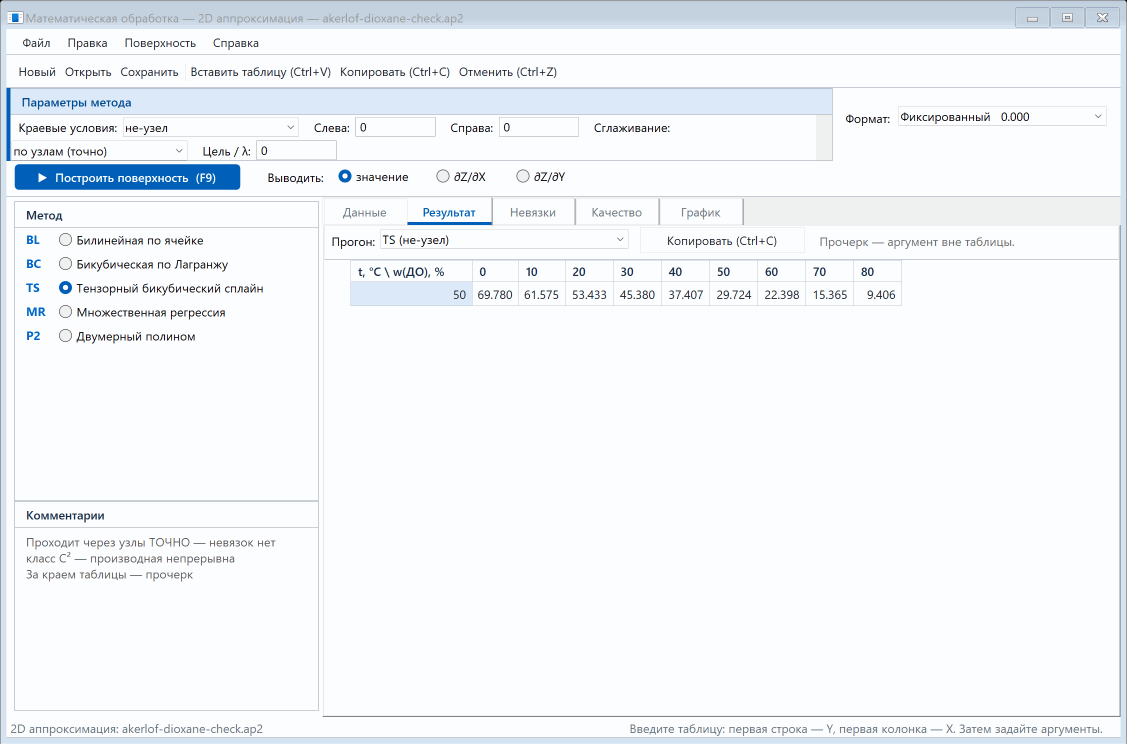
Единственное расхождение — у чистой воды: 69,780 против напечатанных 69,85. И оно не наше: собственное уравнение авторов при $w = 0$ ($\lg a = 1{,}9461$, $b = 0{,}00205$) даёт при 50 °C значение 69,76, то есть сама таблица в этой клетке отходит от своей же кривой на 0,09 — и это её наибольшее отклонение из всех 81 узла. Сплайн, построенный по соседям, воспроизвёл кривую, а не эту клетку. Случай поучительный: проверка утаиванием измеряет не только метод, но и внутреннюю согласованность самой таблицы, и наибольшее расхождение стоит сперва отнести к источнику, а уж потом к численному методу.
Состав $w = 40$ %: те же 9 значений по тем же 72 узлам
| Метод | макс $|\Delta|$ | скз | макс $\delta$, % | ср $\delta$, % |
|---|---|---|---|---|
| TS тензорный сплайн, естественный | 0,009 | 0,006 | 0,024 | 0,012 |
| TS тензорный сплайн, не-узел | 0,014 | 0,009 | 0,035 | 0,017 |
| BC бикубическая по Лагранжу | 0,023 | 0,018 | 0,059 | 0,044 |
| P2 полный порядок 3 | 0,152 | 0,073 | 0,308 | 0,136 |
| BL билинейная | 0,170 | 0,125 | 0,537 | 0,317 |
Здесь все девять значений легли внутрь последнего печатного знака: 49,384 · 46,716 · 44,194 · 41,810 · 39,554 · 37,417 · 35,398 · 33,480 · 31,669 против справочных 49,37 · 46,71 · 44,19 · 41,80 · 39,54 · 37,41 · 35,39 · 33,48 · 31,67. Средняя относительная ошибка — 0,017 %. Разница между двумя срезами объяснима и полезна: при 40 % диоксана изотерма проходит серединой интервала, далеко от изгиба, тогда как водный столбец несёт собственное рассеяние таблицы.
Каждая линия по очереди
Проверку стоит проделать не для одной линии, а для всех: она дёшева и сразу показывает, где у таблицы трудное место. Тензорный сплайн, максимальное отклонение по утаённой линии:
| $t$, °C | макс $|\Delta|$ | макс $\delta$, % | $w$, % | макс $|\Delta|$ | макс $\delta$, % |
|---|---|---|---|---|---|
| 10 | 0,108 | 0,128 | 10 | 0,056 | 0,070 |
| 20 | 0,064 | 0,080 | 20 | 0,033 | 0,048 |
| 30 | 0,095 | 0,124 | 30 | 0,040 | 0,071 |
| 40 | 0,105 | 0,143 | 40 | 0,014 | 0,035 |
| 50 | 0,070 | 0,100 | 50 | 0,048 | 0,192 |
| 60 | 0,019 | 0,055 | 60 | 0,159 | 0,632 |
| 70 | 0,031 | 0,098 | 70 | 0,267 | 1,538 |
По температуре все семь линий укладываются в 0,15 %. По составу шесть линий из семи — тоже, а седьмая, 70 % диоксана, выбивается впятеро: там изотерма ломается сильнее всего, и никакой метод не угадает излом по соседям, отстоящим на 20 %. Это и есть ответ на вопрос, где у справочной таблицы надо сгущать сетку: не везде поровну, а там, где кривизна велика. Сами авторы поступили именно так — за 80 % в их таблице идут 90, 95, 98 и 100 %.
Где предел точности — и почему он не в методе
Ошибка кубической интерполяции убывает как $h^{4}$, поэтому проверка допускает прямое продолжение: утаим не одну линию, а три подряд — шаг удвоится ещё раз, и ошибка обязана вырасти примерно в шестнадцать раз. По составу так и выходит: 0,014 при шаге 20 против 0,125 при шаге 40, отношение 8,9. По температуре — нет: 0,105 при шаге 20 и 0,076 при шаге 40, отношение 0,7. Ошибка не убывает при сгущении сетки, а это значит, что по температуре она вообще не является ошибкой интерполяции: там достигнут шум самой таблицы.
Проверяется это и прямо. Поверхность, построенная по всей таблице, сравнена с собственным уравнением авторов в промежуточных температурах (5, 15, …, 75 °C): максимальное расхождение 0,102, среднеквадратичное 0,016. Сама таблица, сравненная с тем же уравнением в своих узлах, даёт 0,091 и 0,016. Числа совпали: сплайн воспроизводит таблицу ровно с той точностью, с какой таблица воспроизводит собственную кривую. Точнее и быть не может — и требовать не с чего.
Вывод для практики
Расстановка методов на этой задаче устойчива и объяснима. TS лучший (0,014 по составу) и вдобавок единственный, дающий непрерывную производную по обеим осям (7.5). BC держится рядом (0,023) и на температурном срезе даже чуть впереди, но производная у него в узлах рвётся. BL отстаёт в двенадцать раз (0,170) — билинейная поверхность не воспроизводит кривизну вовсе, и на изогнутой изотерме это видно сразу. P2 и MR здесь не конкуренты и не должны ими быть: их дело — формула и экстраполяция (7.6), а не снятие значения из справочника.
И последнее, ради чего таблица бралась. Коэффициент $A$ уравнения Дебая — Хюккеля меняется как $(\varepsilon T)^{-3/2}$, поэтому относительная ошибка проницаемости входит в него с множителем 1,5. Достигнутые 0,035 % дают 0,05 % по $A$ — величину, которой в расчёте равновесия не видно вовсе: погрешность придут задавать сами константы устойчивости, а не интерполяция растворителя. Ради сравнения: на трудной линии 70 % диоксана, где соседние узлы отстоят на целых 20 %, ошибка доходит до 1,5 %, то есть до 2,3 % по $A$, — а это уже величина, сравнимая с разницей между самими моделями коэффициентов активности.
7.9.Работа с программой
X \ Y. Размер задаётся полями
«Узлов по X» и «по Y» с кнопкой «Построить таблицу» — либо просто вставкой
(Ctrl+V), которая наращивает таблицу под вставленный блок вместе с обоими
векторами. Ctrl+Z отменяет последнее изменение.
BL и BC
параметров нет вовсе. У TS их пять: краевое условие, два числовых значения
для условий «задана $y'$ / $y''$», режим сглаживания и цель. У P2 — набор
степеней и две степени. У MR — готовый набор членов. Там же справа стоит
формат показа чисел, общий для всех таблиц окна.
- Результат — матрица на сетке аргументов: строки $X_{int}$, колонки $Y_{int}$. Прочерк означает, что аргумент вне таблицы, а метод экстраполировать не умеет.
- Невязки — данные минус поверхность в узлах исходной таблицы, а не на сетке аргументов: сравнивать с опытом можно только там, где опыт есть. У методов, идущих через узлы, вкладка сообщает, что невязок нет по построению.
- Качество — сверху сводка всех прогонов рядом, снизу разбор выбранного: формула модели, приведение переменных, коэффициенты с $\pm$, $t$, $p$ и VIF, таблица дисперсионного анализа и замечания. У сеточных прогонов вместо этого стоят метод, настройки и — при сглаживании — найденное $\lambda$ с эффективным числом параметров.
- График — три вида, см. ниже.
*.ap2.xml — и хранится там
рецепт, а не числа: метод, его параметры, данные и векторы аргументов. При
открытии все прогоны пересчитываются заново, поэтому файл никогда не может разойтись
с текущим состоянием программы. Соглашение общее для всего раздела.
Внутри оболочки «ElectroChemLab» клавиша F9 не работает: хост намеренно гасит меню встроенного модуля, чтобы Ctrl+N / Ctrl+O / Ctrl+S не срабатывали дважды. Пользуйтесь кнопкой «Построить поверхность». В самостоятельной программе «DataAnalysisLab» и в отдельном окне подпункта горячие клавиши работают как обычно.
7.10.Литература
Поверхности по сетке
- [1] de Boor C. Bicubic spline interpolation. — Journal of Mathematics and Physics, 1962, vol. 41, no. 1–4, p. 212–218. Работа, с которой начинается тензорная бикубика: построение по наклонам и смешанным производным в узлах.
- [2] Ferguson J. Multivariable curve interpolation. — Journal of the ACM, 1964, vol. 11, no. 2, p. 221–228. Эрмитова заплата по шестнадцати числам; здесь же виден смысл смешанной производной.
- [3] Coons S. A. Surfaces for Computer-Aided Design of Space Forms. — MIT Project MAC, Technical Report MAC-TR-41, Cambridge (Mass.), 1967. — 105 p. Заплата с нулевой смешанной производной — тот самый вариант, который тензорному произведению не равен. Постранично доступна: archive.org.
- [4] Ahlberg J. H., Nilson E. N., Walsh J. L. The Theory of Splines and Their Applications. — New York: Academic Press, 1967. — 284 p. Классическая монография; тензорные сплайны и их экстремальные свойства. Постранично доступна: archive.org.
- [5]
Keys R. G. Cubic convolution interpolation for digital image processing. —
IEEE Transactions on Acoustics, Speech, and Signal Processing, 1981,
vol. ASSP-29, no. 6, p. 1153–1160.
Локальная бикубика по окну и её порядок точности — та же
конструкция, что у метода
BC. - [6] Press W. H., Teukolsky S. A., Vetterling W. T., Flannery B. P. Numerical Recipes: The Art of Scientific Computing. — 3rd ed. — Cambridge University Press, 2007. — 1235 p. — §3.6. Постранично доступна: archive.org. Сводка методов интерполяции по сетке в нескольких измерениях, с явным предупреждением о разрывах производной у локальных схем.
- [7] de Boor C. A Practical Guide to Splines. — Revised ed. — New York: Springer, 2001. — 346 p. — (Applied Mathematical Sciences, vol. 27). Глава о тензорных произведениях: почему построение по осям коммутирует и почему этого достаточно.
Сглаживание поверхности
- [8] Reinsch C. H. Smoothing by spline functions. — Numerische Mathematik, 1967, Bd. 10, S. 177–183. Сглаживающий сплайн с заданной невязкой — одномерный кирпич, из которого здесь складывается двумерный сглаживатель.
- [9] Dierckx P. Curve and Surface Fitting with Splines. — Oxford: Clarendon Press, 1993. — 302 p. — (Monographs on Numerical Analysis). Наиболее полное изложение подгонки поверхностей сплайнами, в том числе по регулярной сетке.
- [10] Eilers P. H. C., Currie I. D., Durbán M. Fast and compact smoothing on large multidimensional grids. — Computational Statistics & Data Analysis, 2006, vol. 50, no. 1, p. 61–76. Кронекерова структура двумерного сглаживателя и её следствия — в том числе то, что след произведения есть произведение следов.
- [11] Wahba G. Spline Models for Observational Data. — Philadelphia: SIAM, 1990. — (CBMS-NSF Regional Conference Series in Applied Mathematics, vol. 59). Теория сглаживающих сплайнов и эффективного числа параметров как следа оператора сглаживания. Постранично доступна: archive.org.
Регрессионный анализ
- [12] Draper N. R., Smith H. Applied Regression Analysis. — 3rd ed. — New York: Wiley, 1998. — 736 p. Рус. изд.: Дрейпер Н. Р., Смит Г. Прикладной регрессионный анализ. — 3-е изд. — М.: Издательский дом «Вильямс», 2007. — 912 с.; более раннее рус. изд. в двух книгах: М.: Финансы и статистика, 1986. — Кн. 1. — 366 с.; 1987. — Кн. 2. — 351 с. Основной источник по дисперсионному анализу регрессии и отбору членов модели.
- [13] Seber G. A. F., Lee A. J. Linear Regression Analysis. — 2nd ed. — Hoboken: Wiley, 2003. — 592 p. Строгое изложение: ковариация оценок, $t$- и $F$-критерии, корреляция коэффициентов. Постранично доступна: archive.org.
- [14] Belsley D. A., Kuh E., Welsch R. E. Regression Diagnostics: Identifying Influential Data and Sources of Collinearity. — New York: Wiley, 1980. — 292 p. Диагностика коллинеарности и показатели обусловленности плана.
- [15] Marquardt D. W. Generalized inverses, ridge regression, biased linear estimation, and nonlinear estimation. — Technometrics, 1970, vol. 12, no. 3, p. 591–612. Отсюда происходит рабочий порог VIF > 10.
Распределения
- [16] Abramowitz M., Stegun I. A. Handbook of Mathematical Functions with Formulas, Graphs, and Mathematical Tables. — Washington, D. C.: U. S. Government Printing Office, 1964. — 1046 p. — (NBS Applied Mathematics Series 55). — §6.5, §26.5. Постранично доступна: archive.org. Неполная бета-функция и её связь с распределениями Стьюдента и Фишера — через неё считаются все $p$ этого подпункта.
- [17] Lentz W. J. Generating Bessel functions in Mie scattering calculations using continued fractions. — Applied Optics, 1976, vol. 15, no. 3, p. 668–671. Схема вычисления цепной дроби, которой берётся неполная бета-функция.
Данные примера
- [18] Åkerlöf G., Short O. A. The dielectric constant of dioxane–water mixtures between 0 and 80°. — Journal of the American Chemical Society, 1936, vol. 58, no. 7, p. 1241–1243. Источник справочной таблицы разбора примера: девять температур на тринадцать составов. Там же напечатаны коэффициенты уравнения $\lg D = \lg a - b\,t$, которым таблица и построена, — ими проверены и опечатка в клетке $t = 60$ °C, $w = 10$ %, и собственное рассеяние таблицы.
Выходные данные книжных изданий приведены по общепринятому цитированию; при подготовке публикации их стоит сверить по имеющемуся экземпляру.
8.Дифференцирование
Подпункт вычисляет производную $y'(x)$ (и, по требованию, $y''(x)$) по экспериментальной таблице. В химическом опыте производная — не вспомогательная величина, а сам предмет измерения: наклон кинетической кривой есть скорость реакции, $\partial E/\partial V$ на кривой титрования указывает точку эквивалентности, а вся термодинамика построена на производных одного потенциала —
Последнее равенство — уравнение Вант-Гоффа, и оно же образец типичной задачи: энтальпию получают наклоном экспериментальной зависимости, а не измеряют напрямую. Программа при этом остаётся чисто математической — никаких термодинамических рецептов в ней нет; названные величины перечислены здесь лишь затем, чтобы было видно, откуда берётся спрос. Чтобы продифференцировать $\ln K$ по $1/T$, достаточно вписать эти две колонки в таблицу либо воспользоваться заменой переменных в модели §6.
Почему это самый ненадёжный подпункт раздела
Задача численного дифференцирования некорректна по Адамару[2]: решение не зависит непрерывно от данных. Это не свойство какой-то неудачной формулы, а свойство самой задачи, и обойти его нельзя — можно только заплатить. Показать это проще всего примером. Прибавим к функции слагаемое
Сама функция сдвинулась на $\varepsilon$ — при $\varepsilon = 10^{-6}$ этого не увидит ни один прибор. Производная при этом изменилась на миллион. Никакая точность вычислений здесь не помогает: неустойчива задача, а не арифметика.
В приложении к таблице это выглядит так. Пусть каждое значение $y_i$ измерено с погрешностью $\sigma$, а шаг таблицы равен $h$. Тогда шум разностных формул равен
Оптимальный шаг: почему густая сетка не спасает
Полная ошибка разностной формулы складывается из двух слагаемых, которые ведут себя противоположно. Ошибка усечения (то, чем многочлен отличается от функции) убывает с шагом, шум — растёт:
У суммы есть минимум. Приравняв производную нулю, получаем оптимальный шаг и достижимую в нём точность:
Показатель $2/3$ и есть цена некорректности: увеличив шум в восемь раз, точность производной теряют вчетверо, а не в восемь раз, — но и уменьшив шум вдвое, выигрывают не вдвое, а лишь в $2^{2/3}\approx1{,}6$ раза. Для второй производной показатель ещё хуже, а общий результат теории непараметрического оценивания [16] формулируется так: каждое дифференцирование отнимает один порядок скорости сходимости. Никакой метод этого не отменяет — он лишь подбирается ближе к минимуму. Практическая сторона вопроса разобрана в [15].
Обратный случай тоже бывает: если шаг таблицы больше оптимального, ошибку определяет усечение, а не шум. Тогда сглаживание только испортит ответ, и помочь могут либо формула более высокого порядка, либо новые точки — третьего не дано.
Всякий надёжный способ здесь — это регуляризация
Девять способов подпункта выглядят по-разному, но делают одно и то же: заменяют данные близкой к ним гладкой функцией и дифференцируют её. Фильтр, локальная регрессия, сплайн, подгонка модели, штраф Тихонова[1] — всё это разные способы задать, что считать «гладким», и разные способы измерить, насколько далеко от данных позволено уйти.
Поэтому выбор состоит не в том, какая формула правильная, а в том, чем заплатить: смещением формы или шумом. Ослабляя регуляризацию, приближаются к данным и получают шумную производную; усиливая — получают гладкую, но срезанную. У каждого способа есть параметр, который двигает по этой оси, и весь подпункт устроен вокруг того, чтобы эту цену показать, а не спрятать.
Девять способов подпункта
| Код | Способ | Семейство | Чем задаётся гладкость | $\sigma$ производной |
|---|---|---|---|---|
| FD | конечные разности | разностные | число узлов в шаблоне | да, точно |
| RD | экстраполяция Ричардсона | разностные | число удвоений шага | да |
| SG | фильтр Савицкого — Голея | локальный многочлен | окно и степень | да |
| LP | локальная регрессия | локальный многочлен | доля окна, степень, робастность | да, если без робастности |
| TK | регуляризация Тихонова | обратная задача | $\lambda$ и порядок штрафа | да, при заданном $\lambda$ |
| TV | TVD с сохранением излома | обратная задача | $\alpha$ | нет |
| SP | производная сплайна (§5) | по кривой | вид сплайна и краевое условие | кроме Акимы и PCHIP |
| IN | производная интерполянта (§4) | по кривой | метод и степень | у многочленных форм |
| MD | производная модели (§6) | по кривой | вид модели и её параметр | да, без задания шума |
8.1.Способы дифференцирования— щёлкните заголовок, чтобы свернуть
8.1.1. Конечные разности FD по таблице
Производная в точке $z$ ищется как взвешенная сумма значений в $m$ ближайших узлах:
Обычно такие формулы выписывают таблицей — центральная второго порядка, центральная четвёртого, односторонние на краях, — и каждая строка живёт отдельной константой, справедливой только на равномерной сетке. Здесь вместо таблицы работает алгоритм Форнберга[3][4], который порождает веса для любого порядка производной, любого набора узлов и любой точки вычисления. Отсюда даром: неравномерная сетка работает без единой оговорки, краевые формулы не нужно выписывать (шаблон просто прижимается к краю, а точка вычисления оказывается не в его середине), и производную можно взять в аргументе, не совпадающем ни с одним узлом.
Веса — это в точности строка линейного оператора, поэтому по ним же считается $\sigma$ производной (см. 8.2).
Когда брать. Как меру сравнения, а не как рабочий ответ: это единственный способ подпункта, ничего не добавляющий от себя. Плюс два случая, где он незаменим: точные (расчётные) данные и односторонняя производная до и после излома, где точки по разные стороны принадлежат разным явлениям.
Чего ждать. Формула по $m$ узлам ТОЧНА на многочлене степени $m-1$ — а значит, проходит через все точки шаблона вместе с их шумом. Расширение шаблона повышает порядок формулы и при этом ухудшает ответ на реальных данных: веса становятся знакопеременными и большими по модулю. Это явление Рунге (4.2) в разностном обличье, и потому шире девяти узлов шаблон не предлагается.
Как оценить результат. Посчитайте с тремя узлами и с пятью. Разница между ними — оценка усечения; если она заметно меньше напечатанной $\sigma$, ошибку определяет шум, и нужен способ со сглаживанием.
8.1.2. Экстраполяция Ричардсона RD по таблице
Центральная разность считается с шагом $h$, $2h$, $4h$ … и предел при $h\to0$ достаётся исключением членов разложения. Разложение содержит только чётные степени шага,
поэтому за один шаг исключается сразу $h^2$, и коэффициенты те же $4^m$, что в методе Ромберга (9.1.5): $T_{m} = (4^{m}T_{m-1}(h) - T_{m-1}(2h))/(4^{m}-1)$.
Когда брать. Гладкая функция, равномерная сетка, умеренный шум — это лучший разностный способ подпункта.
Чего ждать. Требуются узлы по обе стороны от точки, поэтому у краёв таблицы число доступных удвоений падает, а в двух крайних узлах производной нет вовсе. На изломе экстраполяция хуже обычной центральной разности: разложение, которое она исключает, там просто не существует.
Как оценить результат. Программа печатает разность двух последних столбцов треугольника как оценку остатка. Перестала меняться — экстраполяция сработала; растёт с числом уровней — данные слишком шумны, и уровней нужно меньше.
8.1.3. Фильтр Савицкого — Голея SG по таблице
Вокруг точки берётся окно из $w$ соседей, по ним методом наименьших квадратов строится многочлен степени $d$, и производная снимается с него аналитически. Классическая работа [5] даёт готовые свёрточные коэффициенты для равномерной сетки; общий вывод для любой степени, любого порядка производной и любой точки окна принадлежит Горри [6], и реализована здесь именно эта форма — поэтому сетка может быть неравномерной, а у краёв работает своя, несимметричная строка.
Это тот же фильтр, что в §3: в узлах результаты обязаны совпадать до последнего знака, и совпадение закреплено тестом.
Когда брать. Рабочая лошадь подпункта: равномерная или почти равномерная сетка, умеренный шум, гладкая кривая без изломов.
Чего ждать. Ширина окна играет ту же роль, что шаг в разностной формуле, и выбирается по $h_{\text{опт}}$: рекомендуемое число точек программа называет сама. Узкое окно повторяет шум, широкое срезает настоящие изгибы — и на краях таблицы смещает результат сильнее, чем в середине, потому что окно там прижато и несимметрично.
Как оценить результат. Стройте кривую при трёх ширинах окна. Пока растёт гладкость, а форма не меняется, — окно ещё узко; как только начали пропадать детали, вы прошли оптимум.
8.1.4. Локальная полиномиальная регрессия LP по таблице
Тот же локальный многочлен, но с двумя отличиями, каждое из которых решает свою задачу. Первое: окно задаётся долей таблицы, а веса убывают к его краю по трикубическому закону $\left(1-u^{3}\right)^{3}$ — резкая граница окна у SG заметна на кривой производной, у LP её нет. Второе: робастные проходы с бивесами Тьюки по Кливленду [7] — точка, отстоящая от локального многочлена больше чем на шесть медианных модулей остатка, полностью теряет вес.
Когда брать. Когда в данных есть грубые промахи. У всех остальных способов одиночный выброс портит производную не только в своей точке, но и у соседей — по ширине окна; робастные проходы это прекращают.
Чего ждать. Кривая производной глаже, чем у SG при том же числе точек в окне. Цена робастности названа прямо: метод перестаёт быть линейным по данным, и $\sigma$ производной у него не существует — в сводке стоит прочерк.
Как оценить результат. Посчитайте дважды — с робастными проходами и без. Разошлись заметно ⇒ в данных есть промах, и стоит найти его глазами на исходной кривой, а не только погасить.
8.1.5. Регуляризация Тихонова TK обратная задача
Все предыдущие способы действуют в два приёма: сначала строится гладкая кривая, потом с неё снимается производная. Здесь искомой величиной сразу является сама производная $u = f'$, а данные связаны с ней интегральным уравнением:
и решается сглаженная задача с квадратичным штрафом [1][8]:
Порядок штрафа отвечает на вопрос, что считать шероховатостью: первый тянет производную к постоянной (кривую — к прямой), второй — к прямой (кривую — к параболе). Для термодинамических зависимостей обычно верен второй, он и стоит по умолчанию. Параметр $\lambda$ безразмерен: он приведён к протяжённости таблицы по абсциссе, поэтому одно и то же значение означает одно и то же, записана температура в кельвинах или в градусах.
При $\lambda = 0$ программа подбирает его сама обобщённой перекрёстной проверкой (GCV) [12]: минимизируется $n\,\mathrm{RSS}/(n-\operatorname{tr}H)^{2}$, где $H$ — матрица влияния. След при переборе оценивается стохастически [13] с фиксированным зерном, поэтому результат воспроизводим.
Когда брать. Гладкая зависимость, важны края таблицы, а сглаживающее окно не хочется подбирать руками. Разумное начало для незнакомых данных: GCV ничего не требует знать заранее.
Чего ждать. Штраф квадратичный, поэтому излом производной будет размазан. Задача решается плотной матрицей, и работа растёт как куб числа точек — выше шестисот точек программа отказывается считать и говорит об этом. Вторую производную этот способ не даёт: в такой постановке она не является неизвестной.
Как оценить результат. Смотрите на эффективное число параметров в сводке: это дробная величина, и она прямо говорит, сколько степеней свободы осталось у кривой. Значение порядка числа точек означает, что регуляризации фактически нет.
8.1.6. TVD: производная с изломом TV обратная задача
Та же постановка, что у Тихонова, но штрафуется полная вариация — модуль, а не квадрат [10][9]:
Замена квадрата модулем меняет ответ качественно. Квадратичный штраф платит за ступеньку высоты $\Delta$ величиной $\Delta^{2}/\ell$ и потому всегда предпочитает размазать её на как можно большую длину $\ell$; штраф по модулю платит $\Delta$ независимо от $\ell$, и размазывать ему невыгодно. Поэтому ступенька в производной выживает.
Задача нелинейна и решается последовательностью квадратичных — методом запаздывающей диффузии [11]: вес $1/\sqrt{(u')^{2}+\varepsilon^{2}}$ берётся с предыдущей итерации, и каждый шаг сводится к системе того же вида, что у Тихонова. Тот же приём, что у TVD-сглаживания в §3.
Когда брать. Когда излом производной ожидается по существу дела: фазовый переход, скачок теплоёмкости, смена лимитирующей стадии, излом кондуктограммы. Это единственный способ подпункта, который его не уничтожит.
Чего ждать. Производная получается кусочно-гладкой, местами почти ступенчатой, — и это правда о постановке, а не дефект. $\sigma$ у неё не существует (метод нелинеен по данным), эффективного числа параметров тоже нет: след последней квадратичной задачи говорил бы о линеаризации, а не о методе.
Как оценить результат. $\alpha$ подбирается глазами по графику: нужно наименьшее значение, при котором ступеньки шума уже исчезли, а настоящая ступенька ещё видна. Проверка — сравнение с TK: если оба дают одно и то же, излома в данных нет и брать TVD незачем.
8.1.7. Производная сплайна SP по кривой
Строится сплайн §5 — со всеми его настройками, включая краевое условие, — и производная берётся с него аналитически. Метод чужого подпункта берётся целиком, поэтому «сплайн здесь» и «сплайн в §5» настраиваются одинаково и разъехаться не могут.
Когда брать. Точки точные: справочная таблица, результат расчёта, выход другого подпункта. Тогда сплайн — лучший способ получить производную между узлами и на всей кривой сразу.
Чего ждать. Сплайн проходит ЧЕРЕЗ УЗЛЫ, то есть через весь их шум, а дифференцирование его усиливает: на зашумлённых данных производная сплайна колеблется сильнее самой разностной формулы. Краевое условие влияет на производную заметно сильнее, чем на саму кривую, — «естественный» сплайн зануляет $y''$ на концах, и вторая производная там заведомо неверна.
Как оценить результат. Постройте кривую при двух краевых условиях. Разошлись только у краёв ⇒ дело в условии; разошлись всюду ⇒ узлов слишком мало.
8.1.8. Производная интерполянта IN по кривой
То же самое для методов §4. У восьми из девяти производная аналитическая; у цепной дроби Тиле её нет в замкнутом виде, и там она берётся численно по самому интерполянту — то есть дифференцированием дважды подряд, о чём программа предупреждает, а вторую производную у неё вовсе не даёт.
Когда брать. Точные данные и уже выбранный в §4 метод: чтобы производная отвечала той самой кривой, по которой строилась таблица значений.
Чего ждать. На зашумлённых данных не годится совсем: интерполянт проходит через все точки, а многочлен высокой степени вдобавок осциллирует между ними — явление Рунге (4.2). Локальные кубики Акимы и PCHIP нелинейны по данным (наклоны считаются по модулям разностей), поэтому $\sigma$ у них не существует.
Как оценить результат. Сравните с производной сплайна по тем же узлам. Заметное расхождение почти всегда означает, что степень интерполянта завышена.
8.1.9. Производная модели MD по кривой
Строится модель §6 — полином, типовое уравнение, регрессионный или сглаживающий сплайн — и дифференцируется аналитически. Здесь же работает замена переменных §6 с полным правилом цепочки, поэтому производная по $1/T$ или по $\ln x$ получается без пересчёта таблицы вручную.
Когда брать. Когда известен закон: теплоёмкость по Майеру — Келли, энергия Гиббса в форме SGTE, Вант-Гофф. Тогда производная получается точной по построению, а не приближённой, и вдобавок с честной погрешностью. Это лучший ответ подпункта, когда он применим.
Чего ждать. Ответ настолько верен, насколько верна модель: неверная по форме кривая даст гладкую и уверенную, но неправильную производную, и узкая полоса $\sigma$ об этом не предупредит — она говорит только о разбросе коэффициентов, а не об ошибке самой модели. При включённой замене переменных $\sigma$ не считается: множитель $\psi'(y)$ сам случаен, и перенос ковариации перестаёт быть линейным. У сглаживающего сплайна и кривой Безье явных коэффициентов нет, поэтому $\sigma$ у них тоже прочерк.
Как оценить результат. Смотрите на невязки подгонки в §6: пятна одного знака означают, что модель неверна ПО ФОРМЕ, и производная будет смещена систематически. Второй способ — сравнить с SG или TK, которые формы не предполагают.
8.2.Неопределённость производной
Шесть способов из девяти линейны по ординатам: результат есть $y' = D\,y$ с матрицей $D$, не зависящей от самих значений. Тогда
и строка $D_i$ добывается пробегом самого способа по единичным векторам — без единого предположения о его виде. Тот же приём, что для весов квадратур в 9.4: он не может разойтись с алгоритмом, потому что использует сам алгоритм. Проверить формулу легко на центральной разности, где ответ известен заранее: строка равна $(-1,0,1)/2h$, её норма $\sqrt2/2h$, — и программа обязана дать ровно это (закреплено тестом).
| Способ | $\sigma$ | Почему |
|---|---|---|
| FD, RD, SG, TK | считается | оператор линеен, строка добывается пробегом |
| LP без робастности | считается | веса зависят только от абсцисс |
| LP с робастностью | прочерк | бивеса зависят от самих ординат |
| TV | прочерк | вес запаздывающей диффузии зависит от решения |
| SP, IN | кроме Акимы, PCHIP и Тиле | там наклоны считаются по модулям разностей |
| MD | из ковариации | шум оценён разбросом точек вокруг кривой |
Два обстоятельства, о которых стоит помнить. Первое: у Тихонова $\sigma$ верна при фиксированном $\lambda$; подобранный по GCV параметр сам зависит от данных, и напечатанная $\sigma$ слегка занижена — та же оговорка, что у сглаживающего сплайна в 9.4. Второе: $\sigma$ описывает только шум. Смещение, которое вносит сглаживание, в неё не входит вовсе, и узкая полоса $\sigma$ у сильно сглаженной кривой не означает, что кривая верна.
8.3.Вторая производная
Вторая производная нужна реже, но в термодинамике неизбежна: теплоёмкость есть $-T\,\partial^2 G/\partial T^2$. Она наследует все трудности первой, помноженные ещё раз. Шум растёт как $\sigma\sqrt6/h^{2}$ — при шаге $0{,}1$ и $\sigma = 10^{-3}$ это уже $0{,}24$, — а оптимальный шаг сдвигается вправо, то есть сглаживать надо сильнее, чем для первой производной по тем же данным.
Второе обстоятельство — класс гладкости. Не всякая кривая имеет непрерывную вторую производную, и там, где её нет, график покажет ступеньки:
| Способ | Вторая производная |
|---|---|
| FD, RD, SG, LP | считаются; нужна степень многочлена не ниже 2 |
| TK, TV | не даются: в этой постановке неизвестной является $u=f'$ |
| SP: кубический, с натяжением, B-сплайн $k\ge3$ | непрерывна (класс $C^2$) |
| SP: Акима, PCHIP, Катмулл — Ром, кардинальный, эрмитов | разрывна в узлах — ступеньки на графике |
| IN: Тиле | не даётся: первая уже численная |
| MD | аналитическая; нужна модель не ниже второй степени |
Третья производная в подпункте не предусмотрена намеренно: её шум равен $\sigma\sqrt{20}/h^{3}$, и осмысленно получить её из экспериментальной таблицы нельзя. Если она нужна по существу задачи — подберите модель §6 подходящей степени и продифференцируйте её формулу; там это законная операция над известной функцией, а не обработка данных.
8.4.Как сравнивать способы
Истины здесь нет ни у кого: точной производной таблично заданной функции не существует, и всякий способ возвращает свой ответ. Поэтому подпункт вооружён не одной мерой качества, а шестью независимыми — каждая отвечает на свой вопрос, и вместе они дают то, чего не даёт ни одна.
| Инструмент | Отвечает на вопрос | Где в окне |
|---|---|---|
| Оценка шума | какова σ моих данных? | кнопка «Оценить по данным» |
| Режим задачи | сглаживать вообще нужно? | вкладка «Режим» |
| L-кривая | какую силу сглаживания взять? | вкладка «Подбор» |
| Разброс способов | можно ли ответу верить? | вердикт под сводкой |
| Обратный ход | не переглажено ли? | колонка сводки |
| Самопроверка | на сколько способ врёт? | кнопка «Самопроверка» |
Первые пять отвечают относительно: этот вариант лучше того, этому числу верить можно, а этому нет. Абсолютный ответ — «врёт на столько-то» — даёт только последний, и добывается он не измерением, а численным опытом.
8.4.1. Оценка шума по самим данным
Без $\sigma$ повисает всё остальное, а спрашивать её у пользователя обычно бесполезно: он её не знает. Программа оценивает её сама — по отклонению точки от прямой, проведённой через двух её соседей:
причём отклонение делится на $\sqrt{1+a^{2}+b^{2}}$ — иначе на неравномерной сетке оценка была бы завышена в разы, — а мерой разброса служит медиана, а не среднеквадратичное. Последнее существенно: одиночный грубый промах даёт одно огромное отклонение, и обычная оценка выросла бы в разы, после чего весь дальнейший вывод («шум велик, сглаживать не нужно») оказался бы вывернут наизнанку.
8.4.2. Режим задачи
По оценённой $\sigma$ и грубой оценке $|f'''|$ печатается $h_{\text{опт}}$ и его отношение к шагу таблицы (вывод формулы — выше). Это единственный ответ подпункта, не зависящий от выбора метода, и потому первое, что стоит прочесть: он сразу говорит, в каком режиме находится задача и нужно ли вообще сглаживать.
8.4.3. L-кривая: где сглаживание перестаёт окупаться
Регулятор сглаживания двигает решение между двумя крайностями, и обе плохи. Измерим обе беды по отдельности и посмотрим, как они меняются одна за счёт другой:
С ростом регулятора $\rho$ растёт, а $\eta$ падает, и график $(\lg\rho,\ \lg\eta)$ имеет характерную форму буквы «L» [14][17]. Смысл у обеих ветвей прямой:
| Участок | Что происходит | Вывод |
|---|---|---|
| вертикальная ветвь — слабое сглаживание, левый верх | усиление регулятора сильно успокаивает производную и почти не портит согласие с данными: точка едет вниз, почти не смещаясь вправо | сглаживать ещё стоит |
| горизонтальная ветвь — сильное сглаживание, правый низ | производную уже почти не успокаивает, зато быстро уводит от данных: точка едет вправо, почти не опускаясь | сглаживать поздно |
| угол между ними | обе беды сопоставимы | это и есть разумный выбор |
Как это сделано. Невязка $\rho$ меряется одинаково для всех способов — через обратный ход (8.4.5), то есть через расхождение восстановленной кривой с данными. Иначе «невязка» у фильтра и у обратной задачи означала бы разные вещи и сравнивать их ветви было бы нельзя. Регулятор перебирается по своему естественному шагу: у окна фильтра — нечётные числа точек, у $\lambda$ и $\alpha$ — логарифмическая сетка, потому что их полезный диапазон занимает много порядков и равномерный шаг потратил бы почти все точки на один его конец.
Угол ищется методом треугольника [18]: обе оси приводятся к отрезку $[0,1]$, концы кривой соединяются хордой, и углом объявляется точка, сильнее всех выступающая от этой хорды к началу координат. Величина выступа стоит в таблице отдельной колонкой, так что выбор виден числом, а не только на глаз. У этой меры нет собственных настроек — ни ширины сглаживания, ни степени подгонки, — которые сами требовали бы выбора и тем возвращали бы задачу к началу.
L-кривая есть только у четырёх способов — SG, LP, TK и TV: у остальных пяти параметра силы сглаживания нет вовсе, и перебирать нечего. У Тихонова рядом с ней работает GCV (8.1.5), и полезно сравнить, что́ они советуют: расхождение между ними — само по себе указание на то, что задача плохо обусловлена данными.
8.4.4. Разброс между способами
Программа печатает вердикт под сводкой и красит его: расхождение меньше 2 % размаха производной — ответу можно верить; больше 15 % — данные не определяют производную, и никакой метод этого не исправит. Полезно и обратное наблюдение: на точных данных расхождение не равно нулю, и остаток есть смещение сглаживания. Способа без шума и без смещения не существует.
Край таблицы считается отдельно и виной не объявляется: там формулы односторонние и расходятся по построению (на гладких данных наибольшее расхождение почти всегда сидит именно на краю — измерено 16 % при 9–12 % внутри таблицы). Если разошлись только края, вердикт остаётся благополучным и прямо это оговаривает.
И проверяется само сравнение: если все посчитанные способы оказались одного семейства, их согласие говорит о семействе, а не о данных, — программа скажет об этом вместо того, чтобы выдать согласие за надёжность.
8.4.5. Обратный ход
Найденную производную интегрируют обратно и сравнивают с исходными данными:
Свободная постоянная $c$ не берётся из первой точки (её собственный шум сдвинул бы всю восстановленную кривую), а подбирается по методу наименьших квадратов — сравниваются формы, а не уровни. Читается результат так: rms много меньше $\sigma$ — производная повторила шум, сглаживание стоит усилить; порядка $\sigma$ — согласуется; много больше — переглажена либо срезала излом.
Предел этой проверки назван честно: у способов, снимающих производную с построенной кривой (SP, IN, MD), восстановленная кривая совпадает с самой кривой, и rms равен невязке подгонки. Там проверка не независима — она различает прежде всего разностные и регуляризованные способы.
8.4.6. Самопроверка: единственный абсолютный ответ
Все пять предыдущих инструментов отвечают относительно. Абсолютного ответа — «на сколько врёт» — из самих данных получить нельзя: истинной производной у них нет. Но её можно назначить, и тогда всё становится измеримым.
Зачем это нужно
Ответ на вопрос «какова погрешность моей производной» до сих пор был неполон, причём неполон систематически. Колонка $\sigma$ (8.2) описывает только шум — разброс вокруг среднего. Но у всякого сглаживания есть и вторая беда, о которой $\sigma$ молчит: смещение — то, что способ портит одинаково при каждом повторении опыта. Срезанный пик, заниженный наклон у края таблицы, сглаженный излом — всё это смещение, и узкая полоса $\sigma$ вокруг такой кривой не только не предупреждает о нём, но и внушает ложную уверенность.
Как это сделано
Отклонения берутся по Боксу — Мюллеру, а не суммой равномерных: у последней обрезаны хвосты, а именно редкие далёкие выбросы и создают ту нагрузку, ради устойчивости к которой берут робастные способы. Зерно генератора фиксировано — два одинаковых запуска дают одинаковые числа, как у всех численных опытов комплекса.
Итог печатается тремя колонками сводки — «Смещение», «Шум», «Полная ошибка» — и выводом-действием в колонке замечаний. Строка состояния называет способ, оказавшийся точнее всех: это и есть прямой ответ на вопрос «какой из посчитанных вариантов брать».
Чему здесь можно и чему нельзя верить
Отдельный случай назван программой вслух: если проверяется способ MD со сглаживающим сплайном, то опорной кривой служит он же — способ проверяется сам собой, и его оценка занижена. Вывод в этом случае начинается со слова «ВНИМАНИЕ».
Зато у самопроверки есть область, где она единственный источник: у нелинейных способов (TVD, робастная локальная регрессия, Акима, PCHIP) аналитической $\sigma$ не существует вовсе, и численный опыт — единственный способ узнать их разброс. Там, где обе величины есть, они обязаны совпасть — и это самая сильная проверка во всём подпункте: измеренный опытом шум сходится с $\sigma$, посчитанной пробегом по единичным векторам, хотя обе получены совершенно независимо.
Опыт стоит сотен расчётов, поэтому запускается только кнопкой и только для уже посчитанных способов. Сотни прогонов хватает, чтобы уверенно сказать, что преобладает; для сравнения самих чисел между способами берите 300–500. Итоги сбрасываются при любом изменении задачи — данных, порядка производной, состава способов, — потому что относились бы уже к другому опыту.
8.5.Как выбирать способ
| Данные | Что брать | Почему |
|---|---|---|
| расчётная таблица, шума нет | RD, FD (5 узлов), SP | сглаживать нечего, важна точность формулы |
| гладкая кривая с умеренным шумом | SG или TK | ширина окна берётся из $h_{\text{опт}}$; у TK края лучше |
| есть грубые промахи | LP с робастностью | бивеса гасят выброс, не размазывая его по окну |
| ожидается излом производной | TV | единственный способ, который его не уничтожит |
| известен физический закон | MD | производная точна по построению и с честной $\sigma$ |
| нужна производная у самого края | TK или MD | оконные способы у края смещены сильнее всего |
| нужна вторая производная | MD, SP ($C^2$), SG со степенью $\ge3$ | остальные её либо не дают, либо дают разрывной |
| точек меньше десяти | MD | сглаживать нечего; форму задаёт модель, а не окно |
Разбор примера: от таблицы до ответа
Пройдём эти шаги на конкретной задаче. Пусть измерена кинетическая кривая распада первого порядка: концентрация $c(t) = 0{,}1\,e^{-0{,}35\,t}$ моль/л, 51 точка от 0 до 10 с шагом $0{,}2$ с, погрешность анализа $5\cdot10^{-4}$ моль/л (полпроцента от начальной концентрации). Нужна скорость реакции $-dc/dt$. Все числа ниже посчитаны самой программой на этой таблице; истинная производная известна и равна $-0{,}035\,e^{-0{,}35\,t}$, поэтому видно и то, насколько каждый вариант ошибся на самом деле.
Шаги 1–2: что говорят данные
| Величина | Значение | Что из этого следует |
|---|---|---|
| $\sigma$, оценка по данным | $5{,}8\cdot10^{-4}$ | заложено было $5\cdot10^{-4}$ — оценка завышена на 15 %, для дальнейших выводов этого достаточно |
| шаг таблицы | $0{,}2$ | то, чем мы располагаем |
| $|f'''|$, оценка | $7{,}9\cdot10^{-4}$ | кривая пологая — усечение мало |
| оптимальный шаг | $1{,}15$ | в 5,8 раза больше шага таблицы |
| рекомендуемое окно | 13 точек | сглаживание обязательно, и его ширина уже названа |
| достижимая точность | $5{,}3\cdot10^{-4}$ | лучшее, на что вправе рассчитывать любой способ |
Шаги 3–4: выбор семейства и силы
Закон известен (распад первого порядка), поэтому строго говоря лучший ответ дал бы способ MD с моделью $a\,e^{bx}$. Но предположим, что порядок реакции как раз и проверяется, — тогда форму навязывать нельзя, и берём SG. L-кривая на вкладке «Подбор» даёт угол при окне 7. Режим советовал 13. Расхождение нормально: угол L-кривой обычно чуть осторожнее, поскольку он ничего не знает о третьей производной.
Шаги 5–6: сравнение и опыт
| Способ | Смещение | Шум | Полная ошибка | Вывод программы | Ошибка на самом деле |
|---|---|---|---|---|---|
| FD, 3 узла | $1{,}6\cdot10^{-4}$ | $2{,}4\cdot10^{-3}$ | $2{,}4\cdot10^{-3}$ | шум 99,8 % | $2{,}2\cdot10^{-3}$ |
| SG, окно 5 | $2{,}3\cdot10^{-4}$ | $1{,}1\cdot10^{-3}$ | $1{,}2\cdot10^{-3}$ | шум 98 % | $9{,}5\cdot10^{-4}$ |
| SG, окно 7 (угол) | $3{,}6\cdot10^{-4}$ | $7{,}2\cdot10^{-4}$ | $8{,}0\cdot10^{-4}$ | сопоставимы | $7{,}8\cdot10^{-4}$ |
| SG, окно 11 | $5{,}1\cdot10^{-4}$ | $4{,}1\cdot10^{-4}$ | $6{,}5\cdot10^{-4}$ | сопоставимы | $4{,}7\cdot10^{-4}$ |
| SG, окно 13 (режим) | $5{,}9\cdot10^{-4}$ | $3{,}3\cdot10^{-4}$ | $6{,}7\cdot10^{-4}$ | сопоставимы | $3{,}3\cdot10^{-4}$ |
| SG, окно 31 | $1{,}7\cdot10^{-3}$ | $1{,}2\cdot10^{-4}$ | $1{,}7\cdot10^{-3}$ | смещение 99,8 % | $1{,}7\cdot10^{-3}$ |
Читается таблица сразу в трёх отношениях, и каждое стоит внимания.
- Обе половины ошибки ведут себя ровно так, как обещано. Слева направо шум падает в двадцать раз, смещение растёт в десять, а их сумма имеет минимум — он и есть оптимум. Ни одна из половин по отдельности его не показывает: по шуму лучшим было бы окно 31, по смещению — простая разность.
- Вывод программы совпадает с истиной. «Сопоставимы» стоит ровно на плато 7–13, «шум» — левее, «смещение» — правее. То есть словесный вывод можно принимать за указание, в какую сторону двигать регулятор, не глядя на числа.
- Оценка достижимой точности сбылась. Режим обещал $5{,}3\cdot10^{-4}$; лучшее, что удалось получить, — $6{,}5\cdot10^{-4}$. Совпадение с точностью до четверти означает, что задача решена настолько хорошо, насколько данные вообще позволяют, и искать другой метод бессмысленно.
Итог: скорость реакции получена способом SG с окном 11 (или 13 — они неразличимы), с ожидаемой ошибкой около $6\cdot10^{-4}$ моль/(л·с). Сообщать её надо именно так — с указанием способа, ширины окна и погрешности.
8.6.Работа с программой
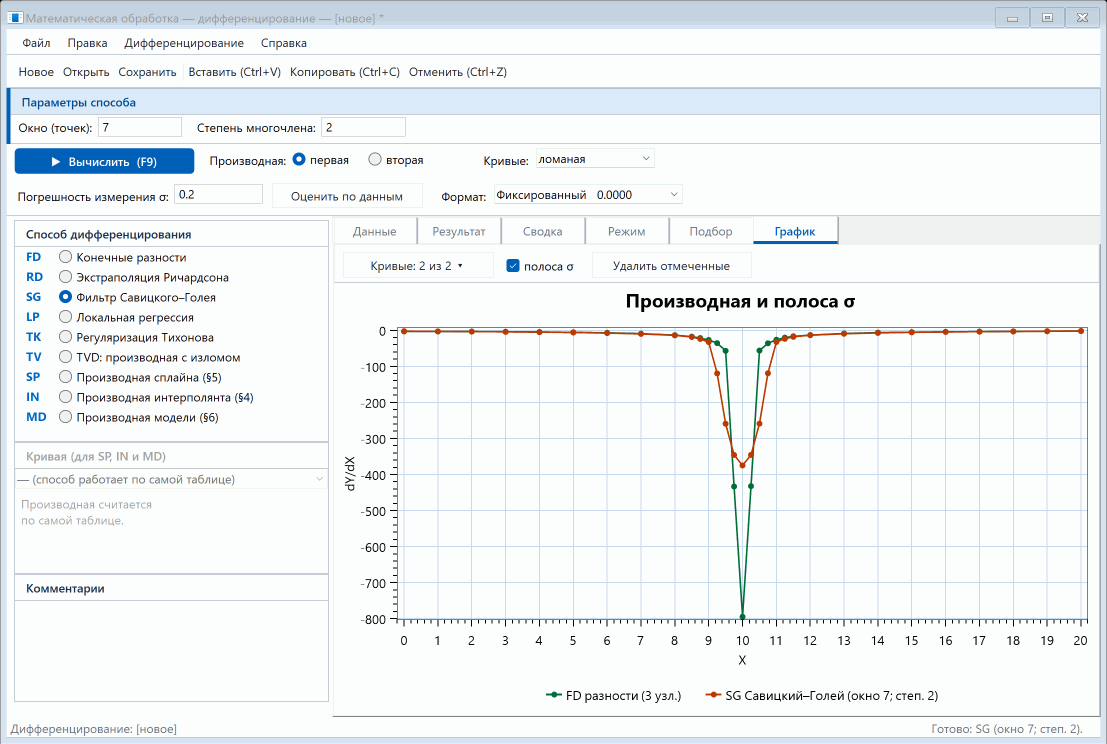
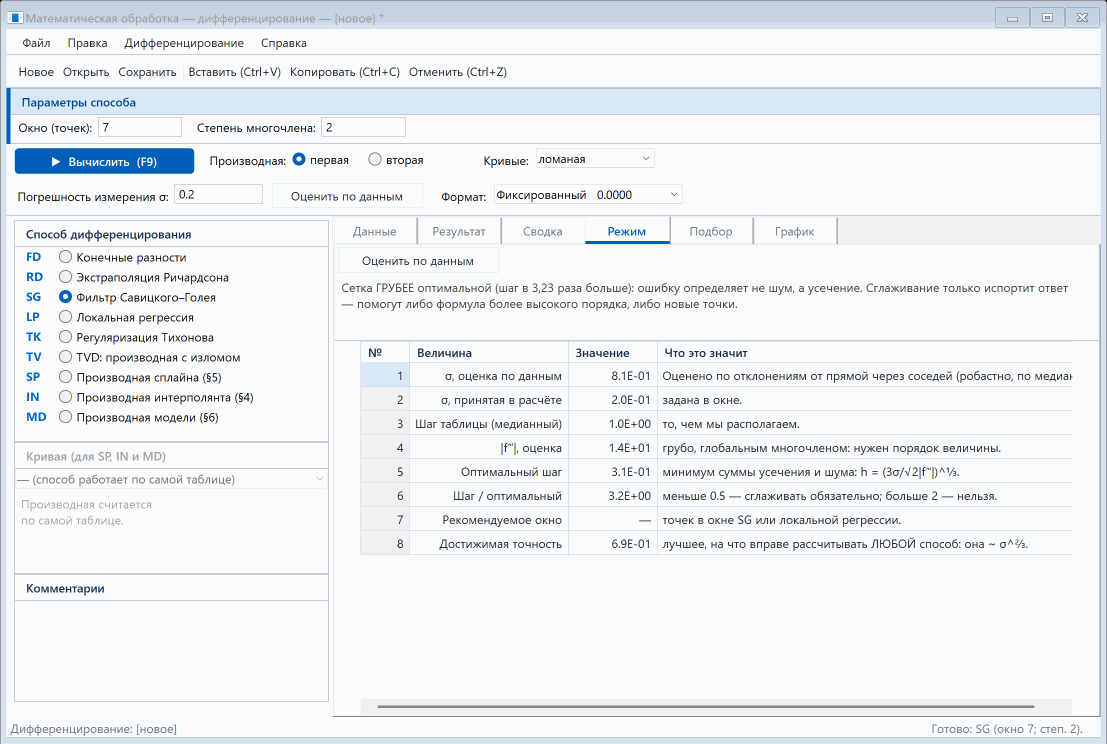
Данные подпункта сохраняются в файл *.drv.xml. В файле лежит рецепт
— способы, их настройки и выбранные кривые, — а числа восстанавливаются пересчётом при
загрузке, поэтому файл не может разойтись с алгоритмом.
8.7.Литература
Некорректность задачи и регуляризация
- [1] Тихонов А. Н., Арсенин В. Я. Методы решения некорректных задач. — 2-е изд. — М.: Наука, 1979. — 288 с. Классическая монография: постановка со штрафом, выбор параметра регуляризации, численное дифференцирование как образцовый пример.
- [2] Hadamard J. Sur les problèmes aux dérivées partielles et leur signification physique // Princeton University Bulletin. — 1902. — V. 13. — P. 49–52. Определение корректно поставленной задачи; отсюда и термин «некорректная».
- [8] Cullum J. Numerical differentiation and regularization // SIAM Journal on Numerical Analysis. — 1971. — V. 8, № 2. — P. 254–265. Дифференцирование как обратная задача к интегрированию — та постановка, которая реализована здесь в способе TK.
- [15] Anderssen R. S., Bloomfield P. Numerical differentiation procedures for non-exact data // Numerische Mathematik. — 1974. — V. 22. — P. 157–182. Сопоставление разностных, фильтровых и регуляризованных подходов на зашумлённых данных; откуда берётся оптимальный шаг.
- [16] Stone C. J. Optimal rates of convergence for nonparametric estimators // The Annals of Statistics. — 1980. — V. 8, № 6. — P. 1348–1360. Строгий результат о том, что каждое дифференцирование отнимает порядок скорости сходимости: отсюда показатель $\sigma^{2/3}$.
Разностные формулы
- [3] Fornberg B. Generation of finite difference formulas on arbitrarily spaced grids // Mathematics of Computation. — 1988. — V. 51, № 184. — P. 699–706. Алгоритм, порождающий веса для любого порядка производной и любого набора узлов; на нём стоит способ FD.
- [4] Fornberg B. Calculation of weights in finite difference formulas // SIAM Review. — 1998. — V. 40, № 3. — P. 685–691. Изложение того же алгоритма в форме, удобной для программирования; именно она транскрибирована в коде.
Локальный многочлен
- [5] Savitzky A., Golay M. J. E. Smoothing and differentiation of data by simplified least squares procedures // Analytical Chemistry. — 1964. — V. 36, № 8. — P. 1627–1639. Оригинал: свёрточные коэффициенты для равномерной сетки. Заголовок статьи не случайно называет дифференцирование наравне со сглаживанием.
- [6] Gorry P. A. General least-squares smoothing and differentiation by the convolution (Savitzky — Golay) method // Analytical Chemistry. — 1990. — V. 62, № 6. — P. 570–573. Общий вывод для любой степени, любого порядка производной и любой точки окна — та форма, которая реализована здесь и которая даёт правильные краевые строки.
- [7] Cleveland W. S. Robust locally weighted regression and smoothing scatterplots // Journal of the American Statistical Association. — 1979. — V. 74, № 368. — P. 829–836. Трикубический вес, бивеса Тьюки и правило шести медианных модулей остатка — всё, на чём стоит способ LP.
Полная вариация и выбор параметра
- [9] Chartrand R. Numerical differentiation of noisy, nonsmooth data // ISRN Applied Mathematics. — 2011. — Article ID 164564. — 11 p. Постановка TVD именно для дифференцирования; отсюда способ TV.
- [10] Rudin L. I., Osher S., Fatemi E. Nonlinear total variation based noise removal algorithms // Physica D. — 1992. — V. 60. — P. 259–268. Работа, с которой начался штраф по полной вариации: почему модуль сохраняет разрыв, а квадрат — размазывает.
- [11] Vogel C. R., Oman M. E. Iterative methods for total variation denoising // SIAM Journal on Scientific Computing. — 1996. — V. 17, № 1. — P. 227–238. Метод запаздывающей диффузии: сведение невыпуклой задачи к последовательности квадратичных — то, как TV решается здесь.
- [12] Craven P., Wahba G. Smoothing noisy data with spline functions: estimating the correct degree of smoothing by the method of generalized cross-validation // Numerische Mathematik. — 1979. — V. 31. — P. 377–403. Обобщённая перекрёстная проверка — правило, по которому программа подбирает $\lambda$ у способа TK.
- [13] Hutchinson M. F. A stochastic estimator of the trace of the influence matrix for Laplacian smoothing splines // Communications in Statistics — Simulation and Computation. — 1989. — V. 18, № 3. — P. 1059–1076. Оценка следа матрицы влияния случайными векторами; без неё перебор $\lambda$ по GCV был бы кубически дорог на каждом значении.
- [14] Hansen P. C. Analysis of discrete ill-posed problems by means of the L-curve // SIAM Review. — 1992. — V. 34, № 4. — P. 561–580. L-кривая как инструмент выбора параметра регуляризации — приём, реализованный на вкладке «Подбор», см. 8.4.3.
- [17] Hansen P. C., O'Leary D. P. The use of the L-curve in the regularization of discrete ill-posed problems // SIAM Journal on Scientific Computing. — 1993. — V. 14, № 6. — P. 1487–1503. Обоснование выбора по углу и разбор случаев, когда угла не существует.
- [18] Castellanos J. L., Gómez S., Guerra V. The triangle method for finding the corner of the L-curve // Applied Numerical Mathematics. — 2002. — V. 43, № 4. — P. 359–373. Поиск угла по тройкам соседних точек, без сглаживания и подгонки — то, чем угол находится здесь.
Разложение ошибки
- [19] Geman S., Bienenstock E., Doursat R. Neural networks and the bias/variance dilemma // Neural Computation. — 1992. — V. 4, № 1. — P. 1–58. Классическое изложение размена «смещение против разброса» — того самого, который измеряет самопроверка (8.4.6).
9.Интегрирование
Подпункт вычисляет определённый интеграл $\int_a^b y\,dx$ по экспериментальной таблице. За этой одной формулой в химическом опыте стоит почти всё, что измеряется накоплением: площадь пика (хроматография, вольтамперометрия, ДСК), заряд $Q=\int I\,dt$ в кулонометрии, тепловой эффект $\Delta H=\int C_p\,dT$, среднее значение величины по времени или по составу. Во всех этих случаях нужен не график, а одно число — и понимание, насколько ему можно верить.
Чем этот подпункт отличается от остальных
Все предыдущие подпункты выдавали колонку: значения в новых точках, сглаженную кривую, коэффициенты модели. Здесь результат — одно число, и это меняет всё устройство окна. Одно число само по себе не говорит ничего: у него нет ни формы, которую можно окинуть взглядом, ни невязок, по которым видно, что модель не та. Поэтому вместо таблицы значений здесь копится сводка — по строке на каждый посчитанный способ.
Два выбора, а не один
Во всех прежних подпунктах выбирался метод. Здесь выбирается ещё и источник подынтегральной функции — что именно интегрируется:
| Источник | Что интегрируется | Когда его брать |
|---|---|---|
| Таблица | сами измеренные значения, как есть | по умолчанию: ничего не додумано, результат зависит только от данных и правила |
| Интерполянт (§4) | кривая, проходящая через узлы | нужны значения между узлами; данные точные |
| Сплайн (§5) | кусочный многочлен через узлы | то же, но с контролем гладкости и краевых условий |
| Модель (§6) | кривая мимо точек, в том числе сглаживающая | данные зашумлены, нужен интеграл с погрешностью или за пределами таблицы |
Источник — не косметика: он решает, какие методы вообще применимы, и почему это так, разобрано в 9.2. Недоступный метод в окне не молчит: он гаснет, а рядом печатается причина словами.
Десять способов подпункта
| Код | Способ | Семейство | Порядок | Своя оценка погрешности |
|---|---|---|---|---|
| RC | Прямоугольники | по таблице | $h$ / $h^2$ | нет |
| TR | Трапеции | по таблице | $h^2$ | нет |
| SI | Симпсон (обобщённый) | по таблице | $h^4$ | нет |
| NC | Ньютон — Котес степени 1…6 | по таблице | до $h^{8}$ | нет |
| RB | Ромберг | по таблице | $h^{2m}$ | да |
| GL | Гаусс — Лежандр | по функции | точен до степени $2n-1$ | нет |
| GK | Гаусс — Кронрод G7K15 | по функции | точен до степени 29 | да |
| AS | Адаптивный Симпсон | по функции | по допуску | да |
| AK | Адаптивный Гаусс — Кронрод | по функции | по допуску | да |
| AN | Точный интеграл кривой | не квадратура | точно | не нужна |
Двухбуквенный код — общее правило раздела: им способ подписан в сводке, а расшифровка стоит первой строкой в списке методов окна.
9.1.Методы интегрирования— щёлкните заголовок, чтобы свернуть
9.1.1. Формула прямоугольников RC по таблице
Самое простое правило: на каждом участке функция заменяется постоянной, и интеграл равен сумме площадей прямоугольников. Значение берётся в левом, правом либо в среднем узле:
Левые и правые прямоугольники имеют порядок $O(h)$: ошибка убывает лишь пропорционально шагу, и вдвое более частая сетка уменьшает её всего вдвое. Это учебные формулы, и программа предупреждает об этом прямо при их выборе. Средние — совсем другое дело: их порядок $h^2$, а главный член ошибки
— вдвое меньше трапецеидального и обратного знака при равной ширине панели $H$. Из этой пары и получается Симпсон: $(2\,I_{\text{сред}} + I_{\text{трап}})/3$ — тождество, закреплённое в программе тестом.
Когда брать. Средние прямоугольники — единственная формула подпункта, не использующая концов отрезка. Это редкая, но настоящая нужда: первая точка титрования до подачи титранта, край хроматографического пика, первое показание прибора после включения — если крайние значения сомнительны, средние прямоугольники дадут ответ, вовсе на них не опираясь. Левые и правые — только для иллюстрации того, как формула сходится.
Как оценить результат. Посчитайте средние прямоугольники и трапеции по одной таблице. Разность между ними — прямая мера того, насколько существенна кривизна на вашем шаге: если она меньше напечатанной $\sigma$ от шума, брать формулы выше первого порядка бессмысленно, данные их не заметят. Если разность велика, переходите к Симпсону, а истинное значение уже заперто между двумя полученными.
9.1.2. Формула трапеций TR по таблице
Соседние точки соединяются хордой, и складываются площади трапеций:
Ошибка $-\frac{(b-a)H^2}{12}\overline{f''}$: удвоение числа точек уменьшает её вчетверо. Формула работает на любой сетке, не требует ни чётного числа интервалов, ни каких-либо предположений сверх существования второй производной[3].
Ещё одно свойство, важное для шумных данных. Веса трапеций все положительны и почти равны ($h$ внутри, $h/2$ по краям). Это делает их наилучшим по устойчивости к шуму правилом подпункта: сумма $\sum w_i^2$ у них минимальна среди всех правил того же шага, а именно она и определяет неопределённость результата (9.4).
Когда брать. Всегда — как первую строку сводки. Трапеции по сырой таблице есть опорное значение, с которым сравнивается всё остальное: они не опираются ни на выбор кривой, ни на предположение о гладкости. Если хитрый способ разошёлся с трапециями сильнее, чем на $\sigma$ от шума, объяснить это обязан хитрый способ, а не трапеции.
Как оценить результат. Посчитайте трапеции по всей таблице и по каждой второй точке (это делается сортировкой и правкой таблицы либо просто сравнением с Ромбергом, первый столбец которого — те же трапеции на вложенных сетках). Если значения различаются заметно, сетка недостаточно частая для вашей кривизны; если совпадают в пределах $\sigma$, дальнейшее сгущение ничего не даст.
9.1.3. Метод Симпсона SI по таблице
Через каждые три соседние точки проводится парабола, и складываются её точные интегралы. На равномерной сетке это даёт классические коэффициенты:
Порядок $h^4$: удвоение числа точек уменьшает ошибку в шестнадцать раз. Даром достаётся ещё один порядок — по симметрии парабола интегрирует точно и кубику, а не только квадратичную функцию[1].
Когда брать. Это рабочее умолчание для гладких данных с достаточно частой сеткой: пик правильной формы, плавная зависимость $C_p(T)$, кривая заряда. Симпсон даёт заметный выигрыш почти даром — считает те же измерения, только с другими весами.
Чего ждать. Веса Симпсона чередуются (1, 4, 2, 4, …), поэтому при равном числе точек его $\sum w_i^2$ немного больше трапецеидального, и напечатанная $\sigma$ от шума будет чуть выше. Это нормальная плата за порядок, и обе величины стоят в сводке рядом — сравните их сами.
Как оценить результат. Разность «Симпсон минус трапеции» есть мера того, сколько дала кривизна. Сопоставьте её с $\sigma$ от шума: если разность существенно больше $\sigma$, Симпсон действительно уточнил ответ; если она в пределах $\sigma$ — уточнять нечего, и оба числа одинаково хороши.
9.1.4. Ньютон — Котес заданной степени NC по таблице
Обобщение двух предыдущих правил: панель составляется из $k$ интервалов, через её $k+1$ узел проводится многочлен степени $k$, и берётся его точный интеграл. Степень 1 — это трапеции, 2 — Симпсон, 3 — классическое правило $3/8$[5]:
Когда брать. Степень 3 имеет смысл на гладких и точных данных — например, когда таблица получена расчётом, а не измерением. Степени 4–6 — почти исключительно учебный интерес: практического выигрыша над Симпсоном они не дают, а к шуму чувствительнее.
Как оценить результат. Посчитайте степени 1, 2, 3 и 4 подряд — четыре строки сводки. У гладких данных значения быстро стабилизируются: разности между соседними степенями падают на порядок. Если же с ростом степени числа начинают гулять, а $\sigma$ от шума растёт — вы уже вышли за пределы того, что содержат данные, и правильный ответ дают низкие степени.
9.1.5. Метод Ромберга RB по таблице оценка
Трапеции считаются на вложенных сетках — каждая вдвое гуще предыдущей, — а затем последовательность уточняется экстраполяцией Ричардсона[6][7]:
Каждый следующий столбец уничтожает очередной член разложения Эйлера — Маклорена, где идут одни чётные степени $h$, так что $T_{1,1}$ — это уже Симпсон, $T_{2,2}$ — правило порядка $h^6$ и так далее. Треугольник $T_{i,j}$ показывается в окне на отдельной вкладке: строка — сетка вдвое гуще предыдущей, столбец — очередная экстраполяция.
- Экстраполяция Ричардсона верна только для гладкой функции на замкнутом отрезке. Разложение Эйлера — Маклорена, на котором она стоит, при изломе или особенности на краю просто неверно, и результат может оказаться хуже голых трапеций. Программа проверить это не может — она может лишь показать треугольник.
- Ричардсон усиливает шум. Он берёт разности почти равных величин и умножает их на большие коэффициенты. На зашумлённых данных столбцы таблицы расходятся, а не сходятся.
Когда брать. Идеальный случай — источник-кривая: гладкий сплайн или модель §6, где значения можно взять где угодно и шума в них уже нет. Там Ромберг дёшев и даёт машинную точность за десяток удвоений. По сырой шумной таблице его брать не следует.
Как оценить результат. Читайте сам треугольник, а не только итог. Если по строке числа при движении вправо перестали меняться в значащих цифрах — экстраполяция сошлась, и значению можно верить; напечатанная «погрешность метода» (разность двух последних столбцов) это и измеряет. Если же столбцы гуляют или расходятся, доверять надо первому столбцу — обычным трапециям, — а вывод один: у вашей функции нет той гладкости, на которую рассчитан метод.
9.1.6. Квадратура Гаусса — Лежандра GL по функции
До сих пор узлы были даны, и подбирались только веса. Гаусс подбирает и то, и другое, и этим удваивает точность: формула с $n$ узлами точна для всех многочленов степени $2n-1$ — вдвое выше, чем у Ньютона — Котеса с тем же числом узлов, причём веса положительны при любом $n$, то есть болезни предыдущего метода здесь нет в принципе.
где $t_k$ — корни многочлена Лежандра $P_n$, а $w_k = 2/\big[(1-t_k^2)P_n'(t_k)^2\big]$. В программе они находятся итерациями Ньютона от классического начального приближения и кэшируются[4]; классическая альтернатива — алгоритм Голуба — Велша через собственные значения трёхдиагональной матрицы[10].
Особенность, которая делает GL проверочным инструментом. Если источник — полиномиальная модель §6 степени $m$, то Гаусс с $\lceil (m+1)/2\rceil$ узлами даёт точный ответ, а не приближённый. Поэтому совпадение GL и AN на одной кривой — не совпадение, а обязательное свойство: оно подтверждает разом и настройки источника, и правильность обоих расчётов.
Чего у метода нет. Оценки погрешности. Чтобы её получить, пришлось бы посчитать заново другим числом узлов, а узлы Гаусса разных порядков не вложены — работа делается дважды. Ровно это и лечит расширение Кронрода.
Когда брать. Гладкая кривая и желание получить ответ дёшево: восемь узлов на панель — это восемь обращений к функции против сотен у табличных правил. Панели (отрезок делится на равные части, формула применяется к каждой) полезны там, где кривая заметно меняет характер: узкий пик на широком фоне одной панелью не берётся.
Как оценить результат. Посчитайте с 4 и с 8 узлами. Совпали в значащих цифрах — квадратура сошлась, и дальше уточнять нечего. Не совпали — либо увеличьте число панелей, либо признайте, что кривая слишком сложна для одной формулы, и возьмите адаптивную схему.
9.1.7. Гаусс — Кронрод G7K15 GK по функции оценка
Кронрод[8] решил задачу, на которой спотыкается обычный Гаусс: он достроил семиузловую формулу Гаусса до пятнадцатиузловой так, что все семь исходных узлов вошли в новые пятнадцать. Тогда пятнадцать обращений к функции дают сразу два ответа — точный (по 15 узлам, порядок точности до степени 29) и грубый (по 7), — а их расхождение служит оценкой погрешности. Даром, без единого лишнего вычисления.
Когда брать. Это рабочая лошадка для интеграла по кривой. Если вы построили сплайн или модель и хотите одно надёжное число с оценкой — берите GK. Пятнадцать обращений на панель — умеренная цена даже для дорогого интерполянта. Несколько панелей задают там, где кривая меняет характер.
Как оценить результат. Сравните напечатанную погрешность метода с самим интегралом: отношение и есть достигнутая относительная точность квадратуры. Если она много лучше $\sigma$ от шума (а так обычно и бывает), дальше уточнять квадратуру бессмысленно — точность результата давно определяется не ею.
9.1.8. Адаптивный метод Симпсона AS по функции оценка
Отрезок делится пополам там и только там, где формула сама себе противоречит. На каждом участке считается Симпсон $S$ целиком и его же сумма $S_2$ по двум половинам; если они разошлись больше допустимого, участок делится дальше, иначе принимается ответ[11]:
Делитель 15 не подгонка: у Симпсона порядок 4, поэтому при делении шага пополам ошибка падает в 16 раз, и $(S_2-S)/15$ есть главный член ошибки $S_2$. Его же прибавляют к ответу (приём Лайнесса[12]), что бесплатно поднимает порядок.
Допуск задаётся относительный, а сама формула требует абсолютного: масштаб берётся предварительной оценкой Гаусса — Кронрода (пятнадцать обращений). Это сделано ради того, чтобы число в поле значило одно и то же у обеих адаптивных схем.
Когда брать. Когда кривая заведомо гладкая, но неоднородная: узкий пик на широком фоне, резкий подъём в начале и плато дальше. Равномерная формула вынуждена всюду держать шаг по худшему участку, адаптивная — тратит усилия там, где они нужны.
Как оценить результат. Смотрите колонку «Обращений». Разумное число — десятки и сотни. Если счёт пошёл на тысячи и упёрся в предел глубины, а ответ при изменении допуска заметно прыгает — метод не подходит вашим данным: он интегрирует шум. Повторите с допуском в сто раз мягче и сравните — если ответ не изменился, жёсткий допуск был лишним.
9.1.9. Адаптивный Гаусс — Кронрод AK по функции оценка
Устройство QUADPACK[9] и лучший из адаптивных способов подпункта. Отрезок хранится как список подынтервалов, у каждого — своё значение и своя оценка погрешности по G7K15; на каждом шаге пополам делится тот подынтервал, у которого оценка погрешности наибольшая. Работа прекращается, когда сумма оценок укладывается в допуск.
Когда брать. По умолчанию для всякой «трудной» гладкой кривой: острый пик, быстро меняющийся участок, широкий отрезок с локальной особенностью. Если не знаете, какую из четырёх формул по функции взять, — берите эту.
Чего ждать. Предупреждение про шум то же, что у адаптивного Симпсона, и по той же причине; оно печатается в тех же случаях.
Как оценить результат. Два числа: погрешность метода и число обращений. Если метод уложился в допуск, не исчерпав предела панелей, — ответ надёжен в пределах напечатанной погрешности. Если предел панелей исчерпан, ответ следует считать оценкой: допуск не достигнут, и программа сообщает об этом честно, а не выдаёт молчаливое число.
9.1.10. Точный интеграл кривой AN не квадратура
Когда кривая уже построена, интегрировать её приближённо незачем: у кусочного многочлена интеграл берётся в замкнутом виде, и погрешности квадратуры не остаётся вовсе. Поэтому «точно» стоит отдельной строкой в списке методов и доступно ровно там, где источником служит кривая.
Технически интеграл берётся не символьно, а квадратурой Гаусса по собственным звеньям кривой с $\lceil (k+1)/2\rceil$ узлами — она точна для степени $2m-1\ge k$, то есть для нашего многочлена точна, до ошибок округления. Выигрыш в том, что представление кривой (наклоны, вторые производные, контрольные точки — у разных форм оно разное) не приходится разбирать заново[14]. Единственное исключение — сплайн с натяжением: там звено не многочлен, а комбинация гиперболических синусов, и звено дробится так, чтобы восьми узлов Гаусса хватало до уровня округления.
Ковариация коэффициентов уже посчитана подгонкой, поэтому $\sigma(I)$ достаётся даром — а это ровно то число, которое нужно в опыте: площадь пика $\pm\sigma$, $\Delta H \pm \sigma$, заряд $Q \pm \sigma$. Формула та же самая, что у полуширины коридора ошибок, только вместо строки базиса в неё подставлен вектор интегралов базиса. Погрешность измерения здесь не спрашивается: она уже оценена подгонкой по разбросу точек вокруг кривой.
Для сглаживающего сплайна путь другой, но результат тот же: $\sigma(I)$ считается по матрице влияния при зафиксированном $\lambda$ — найденное значение больше не подбирается, иначе оператор перестал бы быть линейным и $\sigma$ потеряла бы смысл. Здесь погрешность измерения $\sigma$ нужно задать: у сглаживающего сплайна нет остаточной дисперсии в том смысле, в каком она есть у модели с фиксированным числом параметров.
- Замена переменных по $y$ (6.3): после неё $\hat y = \psi^{-1}(\sum a\varphi)$ уже не линейна по параметрам, и ни точный интеграл, ни $\mathbf{c}^{\mathsf T}\mathrm{Cov}\,\mathbf{c}$ силы не имеют. Замена по $x$ линейность сохраняет, но $\int\varphi(\psi(x))dx$ в элементарных функциях не берётся.
- Кривая Безье (6.1.5) параметрична: $x$ и $y$ — обе функции параметра, «интеграла по $x$» в замкнутом виде у неё нет. Её следует считать квадратурой по самой кривой.
- Рациональные интерполянты — Тиле (4.1.8) и Флотер — Хорманн (4.1.9): это отношения многочленов, а не многочлены, так что ни первообразной в элементарных функциях, ни точности у квадратуры Гаусса.
- Схема Эйткена с остановом по точности (4.1.3): число использованных узлов меняется от точки к точке, поэтому границы кусков лежат не в узлах таблицы. При точности останова 0 (все узлы) это обычный глобальный многочлен, и путь открыт.
Разрывность интерполянта на границах окна (у Лагранжа и Ньютона она есть) точному интегрированию не мешает: каждый интервал таблицы считается своим многочленом, а разрыв — это множество меры нуль.
Когда брать. Всегда, если кривая уже подобрана и путь открыт. Это единственный способ подпункта, у которого нет ошибки квадратуры вовсе, и единственный, дающий $\sigma(I)$ без отдельно заданной погрешности измерения.
Как оценить результат. Посчитайте по той же кривой ещё и GK. Числа обязаны совпасть в пределах напечатанной погрешности квадратуры — это тождество, а не удача. Расхождение означает, что источник настроен не так, как вы думаете (другие параметры, другие пределы), и искать причину надо в настройках, а не в физике.
9.2.Два семейства и почему источник решает
Все десять способов делятся на два семейства, и различие между ними определяет весь подпункт — включая то, какие строки списка методов у вас погашены.
| Семейство | Способы | Что ему нужно | К какому источнику применимо |
|---|---|---|---|
| По таблице | RC, TR, SI, NC, RB | только значения в данных узлах | к любому |
| По функции | GL, GK, AS, AK | значения в своих узлах — где потребует формула | только к кривой |
| Точно | AN | формулу кривой | только к кривой, и не ко всякой |
Из этого следует и обратное, менее очевидное: правила по таблице применимы и к кривой. Тогда они считаются по значениям кривой в узлах исходной таблицы — ровно то, что делают вручную: «сгладили и проинтегрировали». Программа помечает такой прогон замечанием, чтобы результат нельзя было спутать ни с интегралом сырых данных, ни с интегралом самой кривой. Интеграл именно кривой (а не её значений в узлах) дают AN и способы по функции.
Пределы, не совпадающие с узлами
Отдельная тонкость, на которой теряют проценты. Если предел интегрирования попал внутрь интервала, неполная крайняя панель интегрируется тем же локальным многочленом по своей части — без потери порядка и без молчаливого округления предела к ближайшему узлу. Последнее — распространённая ошибка чужих реализаций: на редкой сетке округление предела к соседнему узлу сдвигает ответ на целый интервал площади, и заметить это по числу невозможно.
Исключение — Ромберг по таблице: ему нужны вложенные сетки из имеющихся узлов, поэтому оба предела обязаны совпасть с узлами. Программа отказывается считать и говорит об этом прямо, а не подгоняет пределы втихую.
Экстраполяция
Пределы за границами таблицы подчиняются тому же правилу, что во всём разделе. У кривых через узлы (интерполянты §4, сплайны §5) экстраполяции нет: за крайним узлом базис тождественно равен нулю или многочлен уходит куда угодно, и «продолжение» было бы не предсказанием, а выдумкой, — программа отказывает. У моделей §6, где подобран закон с параметрами, продолжить его законно, и интеграл за пределами таблицы считается. По таблице пределы просто обрезаются по крайним узлам, о чём печатается замечание.
9.3.Интегрирование и шум: почему оно устойчиво
Причина проста. Интеграл — это сумма значений с положительными весами, и случайные отклонения входят в неё со своими знаками, частично гасясь. Пусть каждое измерение несёт независимую ошибку со стандартным отклонением $\sigma$. Для трапеций на равномерной сетке веса равны $h$ (и $h/2$ по краям), поэтому
Абсолютная неопределённость интеграла падает как $1/\sqrt{n}$, а относительная — тем более. Иными словами, чем больше точек, тем точнее интеграл, и никакой предварительной обработки для этого не требуется.
Сравните с производной, которой посвящён соседний подпункт:
Там уменьшение шага увеличивает шум ответа — и именно поэтому дифференцирование без сглаживания невозможно, а интегрирование прекрасно обходится без него.
Из этого правила есть три честных исключения, и все они названы:
- Грубый промах не гасится. Выброс входит в сумму с весом порядка $h$ и сдвигает интеграл систематически, а не случайно. С ним борются не «сглаживанием вообще», а прицельно: скользящей медианой (3.1.4) в §3 или устойчивой подгонкой (6.4) в §6.
- Ромберг и высокие степени шум усиливают — см. 9.1.5 и 9.1.4. Экстраполяция Ричардсона берёт разности почти равных чисел, а веса Ньютона — Котеса высокой степени велики и знакопеременны.
- Адаптивные схемы по кривой через шумные узлы дробят отрезок, гоняясь за изгибами, созданными шумом (9.1.8).
Численный пример. Пусть ток измеряется с точностью $\sigma = 0{,}5$ мкА, шаг по времени $h = 0{,}01$ с, всего $n = 201$ точка (интервал 2 с). Тогда $\sigma(Q) \approx 0{,}5\cdot0{,}01\cdot\sqrt{201} \approx 0{,}07$ мкА$\cdot$с — при заряде порядка десятков мкА$\cdot$с это доли процента, и никакой обработки данные не требуют. Производная же той же кривой имела бы шум $0{,}5\sqrt2/0{,}01 = 71$ мкА/с, то есть была бы неразличима без сглаживания.
9.4.Неопределённость результата
В сводке стоят два разных числа про точность, и они отвечают на разные вопросы. Смешивать их нельзя.
| Колонка | На какой вопрос отвечает | Откуда берётся |
|---|---|---|
| Погрешность метода | насколько точно квадратура взяла интеграл от той кривой, что ей дали | сама формула: Кронрод, адаптивные схемы, Ромберг |
| $\sigma$ от шума | насколько интеграл неопределён из-за погрешности измерений | закон переноса ошибок либо ковариация подгонки |
Где $\sigma(I)$ считается
- Табличные правила по самим данным. Всякое такое правило линейно по ординатам: $I = \sum_i w_i y_i$. Значит, при заданной погрешности измерения $\sigma(I) = \sigma\sqrt{\sum w_i^2}$ — обычный закон переноса ошибок[15]. Веса при этом не выписываются вручную, а добываются пробегом самого правила по единичным векторам: подаём $y=(0,\dots,1,\dots,0)$ и смотрим, что получилось. Так формула $\sigma(I)$ верна для любого правила, включая слитые хвостовые панели, — без единого предположения о его виде.
- Модели §6 (способ AN). $\sigma(I)=\sqrt{\mathbf{c}^{\mathsf T}\mathrm{Cov} (\mathbf{a})\mathbf{c}}$, см. 9.1.10. Погрешность измерения здесь не спрашивается: она уже оценена подгонкой по разбросу точек вокруг кривой.
- Сглаживающий сплайн (способ AN). Через матрицу влияния при зафиксированном $\lambda$; погрешность измерения задать нужно.
Где стоит прочерк — и почему это честнее числа
- Нелинейные по данным источники: интерполянты Акимы и PCHIP (наклоны в узлах выбираются по самим данным — из-за чего оператор перестаёт быть линейным), устойчивая подгонка IRLS. Формулы переноса ошибок для них попросту не существует.
- Правила по значениям кривой в узлах. Там ординаты — уже не измерения, а значения кривой, у которых своя, чужая ковариация; подставлять в формулу $\sigma$ измерения было бы подлогом.
- Не задана $\sigma$. Пока поле «Погрешность измерения» равно нулю, программа печатает только сам интеграл: угадывать за экспериментатора точность его прибора она не вправе.
- Слишком много точек (больше 400): веса добываются пробегом, работа квадратична по числу узлов, а точность $\sigma(I)$ от этого не выиграет.
Оговорка того же рода, что в 6.8: $\sigma(I)$ не учитывает, что $\lambda$, степень модели или набор членов выбраны по тем же самым данным. Честная полная неопределённость чуть больше напечатанной.
9.5.Как выбирать способ
| Данные и задача | Источник | Способ |
|---|---|---|
| Гладкая кривая, шум мал, пределы в узлах | таблица | SI, для контроля TR |
| Данные точные (расчёт, справочник), нужна высокая точность | сплайн §5 | AN, контроль GK |
| Заметный шум, нужен интеграл с погрешностью | сглаживающая модель §6 | AN |
| Излом внутри отрезка (скачок, фазовый переход) | таблица | TR; высокого порядка не брать |
| Узкий пик на широком отрезке | сплайн или модель | AK |
| Пределы не совпадают с узлами | любая кривая | AN или GK; по таблице годятся TR, SI, NC |
| Крайние точки сомнительны | таблица | RC (средние) |
| Нужен интеграл за пределами таблицы | модель §6 | AN |
Разбор примера: энтропия по третьему началу и проверка её электрохимией
Всё сказанное выше собирается в задаче, которая для этого подпункта почти
образцовая: абсолютная энтропия вещества есть интеграл, и ничего кроме
интеграла. Ценность примера в том, что у ответа есть независимый
свидетель совсем другой природы — электрохимическое измерение, — и по
расхождению двух путей видно, чего на самом деле стоит каждая часть работы.
Пример поставляется с программой: docs\examples\silver-cp.txt —
таблица теплоёмкости серебра для вставки (Ctrl+V),
silver-entropy.itg.xml и silver-enthalpy.itg.xml —
готовые файлы подпункта, mercury-cp.txt и
mercury-fusion.itg.xml — случай с фазовым переходом внутри отрезка.
Суть термодинамической проверки
Третье начало термодинамики утверждает, что энтропия правильно построенного кристалла обращается в нуль при $T \to 0$. Если это так, то абсолютная энтропия вещества при 298,15 K вычисляется — интегрированием измеренной теплоёмкости:
$$ S^{\circ}(298{,}15) \;=\; \int_{0}^{298{,}15} \frac{C_p(T)}{T}\,dT $$Утверждение это не проверить изнутри самой калориметрии: интеграл посчитан — и сравнивать не с чем. Нужен второй путь к той же величине, ничего общего с теплоёмкостями не имеющий. Такой путь даёт гальванический элемент. Для реакции, идущей в элементе, справедливо $\Delta G = -nFE$, а отсюда
$$ \Delta S \;=\; -\left(\frac{\partial \Delta G}{\partial T}\right)_p \;=\; nF\left(\frac{\partial E}{\partial T}\right)_p $$то есть энтропия реакции измеряется наклоном ЭДС по температуре — термометром и потенциометром, без единого калориметра. Сложив четыре табличные энтропии в энтропию той же реакции, мы получаем два числа, добытые несопоставимыми способами. Их совпадение и есть проверка третьего начала; их расхождение указывает, какое из двух измерений слабее.
Что именно интегрируется
Подынтегральная функция здесь — не теплоёмкость, а $C_p/T$, и это первое, что решает всё дальнейшее. Основной пример построен на серебре: критически разобранная таблица теплоёмкости от 1 до 300 K [17], 78 узлов, шаг 1 K до 20 K и 5 K дальше. Таблица самопроверяемая: рядом с $C_p$ источник печатает и собственные $S(T)$ и $H(T)-H(0)$, то есть эталон существует в каждом узле, а не только в конце. Именно поэтому на ней и стоит мерить способы: обычно у настоящей задачи такого эталона нет вовсе.
Тот же файл даёт два разных интеграла по одной таблице: $\int C_p\,dT$ — приращение энтальпии, $\int (C_p/T)\,dT$ — энтропия. Данные одни, вес разный, и задачи получаются разной трудности — об этом ниже.
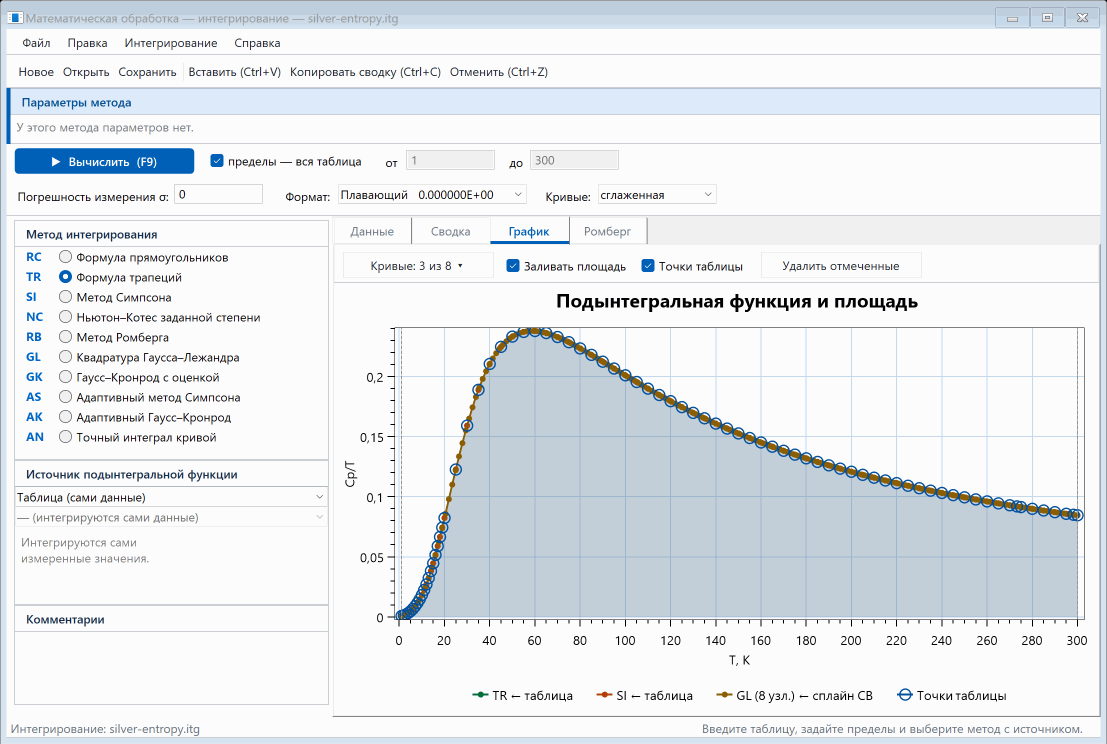
silver-entropy.itg.xml, вкладка «График». Заштрихована площадь, которая и есть искомая величина; кружки — узлы таблицы. Картинка объясняет всё дальнейшее: $C_p/T$ круто поднимается от нуля, проходит вершину около 55 K и дальше медленно спадает, то есть вся структура подынтегральной функции умещается в первой пятой части отрезка, а отрезок тянется до 300 K. Видно и то, как расставлены узлы: ниже 20 K они идут через 1 K и сливаются в сплошную полосу, выше — через 5 K.Как ведут себя способы на настоящей таблице
Энтропия серебра, пределы 1…300 K, эталон — собственная колонка источника
$\Delta S = 42{,}7183$ Дж/(моль·К). Все прогоны лежат в поставляемом файле
silver-entropy.itg.xml:
| Способ | Источник | Значение | Отклонение |
|---|---|---|---|
| RB Ромберг | сплайн | 42,7169 | −0,003 % |
| AK адаптивный Кронрод / AN точно | сплайн | 42,7162 | −0,005 % |
| GL Гаусс, 8 узлов × 4 панели | сплайн | 42,7162 | −0,005 % |
| SI Симпсон | таблица | 42,7154 | −0,007 % |
| GK Гаусс — Кронрод | сплайн | 42,7217 | +0,008 % |
| TR трапеции | таблица | 42,6996 | −0,044 % |
| RC прямоугольники | таблица | 42,6503 | −0,159 % |
| GL Гаусс, 8 узлов, 1 панель | сплайн | 42,7990 | +0,189 % |
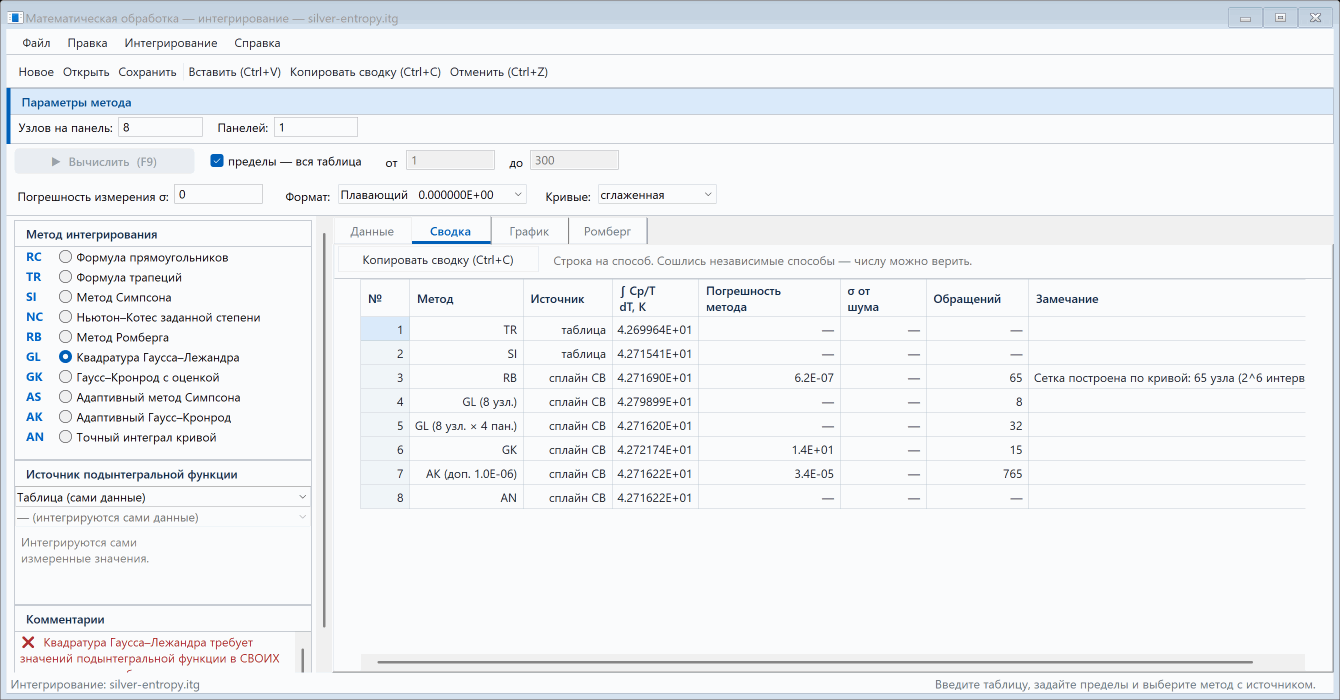
Тот же метод на гладкой модели — противоположный приговор
Чтобы отделить ошибку способа от всего остального, нужен случай с точно известным ответом. Он получается сам собой: подгоним теплоёмкость типовым уравнением §6 (форма Майера — Келли, 50…300 K), и тогда AN даёт аналитический интеграл этой модели, а остальные способы работают по её же значениям. Ошибка каждого становится настоящей, а не разностью с чужой арифметикой:
| Способ | Обращений | Ошибка от точного |
|---|---|---|
| GK Гаусс — Кронрод | 15 | −0,000000 % |
| GL Гаусс — Лежандр | 8 | +0,00014 % |
| SI Симпсон | 53 | −0,00011 % |
| TR трапеции | 53 | −0,015 % |
| RC прямоугольники | 53 | +0,031 % |
Картина учебная и прямо противоположная предыдущей: Гаусс на восьми обращениях в сто раз точнее трапеции на пятидесяти трёх. Один и тот же метод оказывается лучшим и худшим — в зависимости не от метода, а от того, насколько строение панелей отвечает строению подынтегральной функции. Это и есть главный практический вывод подпункта, и добыт он измерением, а не рассуждением.
Где кончается ошибка метода и начинается ошибка данных
Тот же интеграл, разбитый по участкам, показывает, до каких пор вообще имеет смысл выбирать способ:
| Участок | Трапеции | Симпсон | Кто правит |
|---|---|---|---|
| 1…10 K | +0,45 % | −0,02 % | метод |
| 20…30 K | −0,26 % | +0,005 % | метод |
| 30…50 K | −0,27 % | +0,016 % | метод |
| 100…200 K | +0,047 % | +0,041 % | данные |
| 200…300 K | −0,041 % | −0,048 % | данные |
Внизу шкалы, где кривизна велика, а узлов мало, Симпсон точнее трапеции в двадцать раз. Наверху оба дают одно и то же и оба одинаково расходятся с эталоном: значит, там мы уже меряем не квадратуру, а разницу между своей кривой и сглаживанием самого источника. Признак этого простой и годится в любой задаче: как только независимые способы сошлись между собой, а с эталоном не сошлись, — улучшать метод бессмысленно.
Шум против метода
Второй файл примера, silver-enthalpy.itg.xml, считает по той же таблице
$\int C_p\,dT$ и несёт заданную погрешность измерения $\sigma = 0{,}1$ % от
$C_p$ при 300 K. Программа считает $\sigma(I)$ пробегом по единичным ортам
(9.4) и даёт 8,755 Дж/кг; прямой опыт — четыреста реализаций с
подмешанным нормальным шумом — даёт разброс интеграла 8,902. Две совершенно
независимые машинерии сошлись в пределах 1,7 %, и это лучшее подтверждение
того, что колонка $\sigma$ в сводке означает именно то, что обещает.
Но соотношение здесь не такое, как обычно. Шум даёт 0,017 %, а ошибка метода на тех же данных — от 0,009 % (Симпсон) до 0,017 % (трапеции), то есть они одного порядка. Правило «шум всегда перекрывает квадратуру» (9.3) верно для обычного опыта с десятками точек и процентным разбросом; на справочной таблице из 78 тщательно сглаженных узлов оно перестаёт работать, и две колонки сводки надо сравнивать, а не полагаться на одну.
Ртуть: разрыв, которого не видно в подынтегральной функции
Файл mercury-fusion.itg.xml добавляет к примеру случай, ради которого в
таблице 9.5 стоит отдельная строка. Ртуть плавится при 234,29 K, то есть
внутри промежутка интегрирования, и энтропия набирается тремя слагаемыми
[18]:
| Слагаемое | Посчитано | Печатает источник |
|---|---|---|
| твёрдая, 15…234,29 K | 12,972 | 12,966 |
| плавление, $548{,}6/234{,}29$ | 2,342 | 2,342 |
| жидкая, 234,29…298,15 K | 1,628 | 1,628 |
| итого | 16,941 | 16,936 |
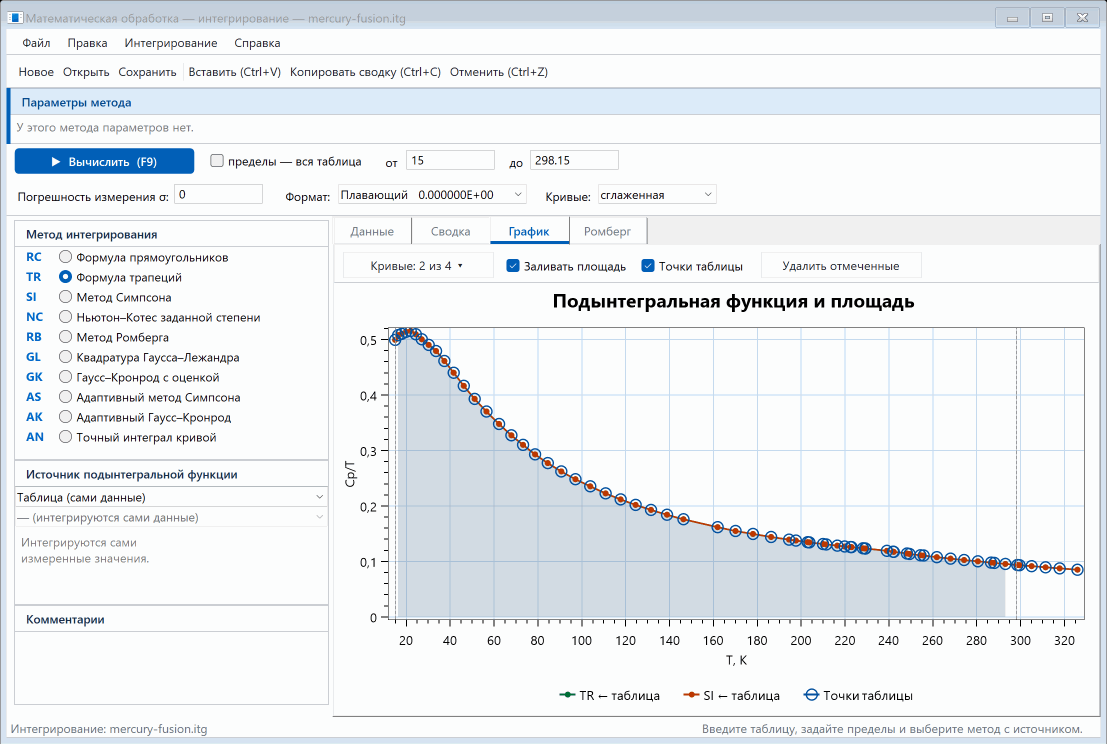
mercury-fusion.itg.xml: $C_p/T$ ртути от 14,90 до 325,89 K, вертикальные черты — заданные пределы 15 и 298,15 K. Точка плавления 234,29 K лежит посреди отрезка, и на кривой её не найти — она идёт гладко, без излома и без ступени. Это и есть предупреждение рисунка: глазами такой переход не обнаруживается, а стоит он 13,8 % ответа. Искать его надо не на графике, а в описании вещества, и дробить отрезок по нему руками.Итог проверки — и что в нём принадлежит интегрированию
Сложив четыре энтропии, получаем энтропию реакции и сравниваем её с элементом. Значения приведены в энтропийных единицах, кал/(моль·К), — в них печатают первоисточники; множитель перевода 4,184 Дж/кал:
| Вещество | $S^{\circ}_{298}$ | $C_p$ измерена от | Доля экстраполяции |
|---|---|---|---|
| Ag | 10,20 ± 0,05 | 1 K | 0,001 % |
| AgCl [19] | 23,00 ± 0,10 | 10 K | 0,6 % |
| Hg [18] | 18,17 ± 0,10 | 1 K | 0,006 % |
| Hg2Cl2 (на ½) [20] | 23,0 ± 0,5 | 22,4 K | 5,9 % |
Сводка энтропий и разбивка каждой на измеренную и экстраполированную части взяты у Келли и Кинга [21]. Отсюда
$$ \Delta S_{\text{калор.}} = 23{,}00 + 18{,}17 - 10{,}20 - 23{,}0 = 7{,}97 \pm 0{,}52 \qquad\text{против}\qquad \Delta S_{\text{ЭДС}} = 7{,}80 \pm 0{,}10 $$Два пути сошлись — третье начало подтверждено. Но интереснее асимметрия погрешностей: электрохимический путь оказался впятеро точнее калориметрического, и вся разница сидит в одном веществе. Именно так и рассудили составители справочника, прямо записав, что лучшие значения для каломели получаются из измерений ЭДС Герке, а не из её теплоёмкости.
Теперь — то, ради чего пример стоит в этом подпункте. Спросим, чем именно калориметрический путь проиграл, и переведём ответ на язык интегрирования. Всё сводится к трём вещам, и ни одна из них не есть выбор квадратурной формулы:
Соотношение величин говорит само за себя. Выбор среди десяти способов двигает ответ на 0,016 Дж/(моль·К); принятая неопределённость $S^{\circ}(\mathrm{Ag})$ — ±0,20, то есть в двенадцать раз больше; а две независимые оценки одного и того же интеграла, сделанные с разницей в семь лет, расходятся на 0,118 — всемеро больше разброса всех десяти способов вместе. На фоне же экстраполированного хвоста каломели любая арифметика теряется вовсе.
Замкнуть круг можно и в обратную сторону, и так поступили составители справочника. Три энтропии, для которых данные полны, считаются интегрированием, а четвёртая выражается из элемента: $S^{\circ}(\mathrm{HgCl}) = 23{,}00 + 18{,}19 - 10{,}17 - 7{,}80 = 23{,}22$, что при калориметрических $23{,}0 \pm 0{,}5$ сходится с запасом. Электрохимия здесь не проверяет интеграл, а заменяет его там, где интегрировать нечего.
9.6.Работа с программой
Окно устроено как остальные окна раздела: слева — выбор, справа — вкладки с результатом. Отличий два, и оба разобраны выше: слева две рамки выбора (источник и метод), а справа вместо таблицы значений копится сводка.
*.itg.xml и хранит рецепт: данные, пределы,
погрешность, а также способ, источник и их параметры для каждой строки сводки. Интегралы
пересчитываются при загрузке, поэтому файл не может разойтись с текущей версией
алгоритмов.
Формат показа чисел (пять вариантов) и вид кривых на графике — общие для раздела и описаны в 1. Формат не трогает данные: переключение обратимо.
9.7.Литература
Общие руководства по квадратурам
- [1] Крылов В. И. Приближённое вычисление интегралов. — 2-е изд. — М.: Наука, 1967. — 500 с. Классическая отечественная монография: вывод формул Ньютона — Котеса, их остаточные члены и разбор потери устойчивости при росте степени.
- [2] Davis P. J., Rabinowitz P. Methods of Numerical Integration. — 2nd ed. — Orlando: Academic Press, 1984. — 612 p. Наиболее полный современный свод: формула Эйлера — Маклорена, знаки весов замкнутых формул, теория гауссовых квадратур.
- [3] Бахвалов Н. С., Жидков Н. П., Кобельков Г. М. Численные методы. — 8-е изд. (эл.). — М.: БИНОМ. Лаборатория знаний, 2015. — 639 с. Остаточные члены трапеций и Симпсона в том виде, в каком они приведены здесь.
- [4] Press W. H., Teukolsky S. A., Vetterling W. T., Flannery B. P. Numerical Recipes: The Art of Scientific Computing. — 3rd ed. — Cambridge: Cambridge University Press, 2007, ch. 4. Отсюда взята схема вычисления узлов Лежандра итерациями Ньютона от начального приближения $\cos\pi(i-\tfrac14)/(n+\tfrac12)$.
- [5] Abramowitz M., Stegun I. A. Handbook of Mathematical Functions. — Washington, D. C.: U. S. Government Printing Office, 1964. — 1046 p. — (NBS Applied Mathematics Series 55). — §25.4. Табличные коэффициенты замкнутых формул Ньютона — Котеса, с которыми сверены результаты общей машины панелей. Постранично доступна: archive.org.
Ромберг и экстраполяция
- [6] Romberg W. Vereinfachte numerische Integration. — Det Kongelige Norske Videnskabers Selskab Forhandlinger, 1955, Bd. 28, Nr. 7, S. 30–36. Оригинальная работа: трапеции на вложенных сетках плюс экстраполяция.
- [7] Richardson L. F. The approximate arithmetical solution by finite differences of physical problems. — Philosophical Transactions of the Royal Society A, 1911, vol. 210, p. 307–357. Сама идея экстраполяции по шагу, на которой стоит весь треугольник. Постранично доступна: archive.org.
Гаусс, Кронрод, адаптивные схемы
- [8] Кронрод А. С. Узлы и веса квадратурных формул. Шестнадцатизначные таблицы. — М.: Наука, 1964. — 143 с. Достраивание формулы Гаусса до вложенной формулы вдвое большего порядка — основа пары G7K15.
- [9] Piessens R., de Doncker-Kapenga E., Überhuber C. W., Kahaner D. K. QUADPACK: A Subroutine Package for Automatic Integration. — Berlin: Springer, 1983. — 301 p. Отсюда взяты и масштабирование оценки погрешности, и устройство глобальной адаптивной схемы с делением худшего подынтервала.
- [10] Golub G. H., Welsch J. H. Calculation of Gauss quadrature rules. — Mathematics of Computation, 1969, vol. 23, no. 106, p. 221–230. Классический способ получения узлов и весов через собственные значения; приведён как альтернатива применённому здесь.
- [11] McKeeman W. M. Algorithm 145: Adaptive numerical integration by Simpson's rule. — Communications of the ACM, 1962, vol. 5, no. 12, p. 604. Первая публикация адаптивного деления пополам по критерию самосогласованности.
- [12] Lyness J. N. Notes on the adaptive Simpson quadrature routine. — Journal of the ACM, 1969, vol. 16, no. 3, p. 483–495. Разбор критерия $1/15$ и приём добавления главного члена ошибки к ответу.
- [13] Gander W., Gautschi W. Adaptive quadrature — revisited. — BIT Numerical Mathematics, 2000, vol. 40, no. 1, p. 84–101. Современный разбор того, как адаптивные схемы обманываются, и почему допуск нельзя задавать машинным нулём.
Точный интеграл и перенос ошибок
- [14] de Boor C. A Practical Guide to Splines. — Revised ed. — New York: Springer, 2001. — 346 p. Интегрирование кусочно-полиномиальных представлений; отсюда же соображение, что разбирать форму сплайна ради интеграла не требуется.
- [15] Bevington P. R., Robinson D. K. Data Reduction and Error Analysis for the Physical Sciences. — 3rd ed. — Boston: McGraw-Hill, 2003. — 320 p. Закон переноса ошибок для линейной комбинации измерений — формула $\sigma(I)=\sigma\sqrt{\sum w_i^2}$.
Данные примера
- [16] Gerke R. H. Temperature coefficient of electromotive force of galvanic cells and the entropy of reactions // J. Am. Chem. Soc. — 1922. — Vol. 44, no. 8. — P. 1684–1704. Элементы без жидкостного соединения, у которых суммарная реакция идёт между чистыми конденсированными фазами. Отсюда $\Delta S = 7{,}80$ для $\mathrm{Ag} + \tfrac12\mathrm{Hg_2Cl_2} = \mathrm{AgCl} + \mathrm{Hg}$, доказательство независимости ЭДС от электролита и сама постановка проверки третьего начала.
- [17] Furukawa G. T., Saba W. G., Reilly M. L. Critical analysis of heat-capacity data and evaluated thermodynamic properties of copper, silver, and gold from 0 to 300 K. — Washington: NSRDS-NBS 18, 1968. — 49 p. Таблица воспроизведена целиком в: Smith D. R., Fickett F. R. Low-temperature properties of silver // J. Res. Natl. Inst. Stand. Technol. — 1995. — Vol. 100, no. 2. — P. 119–171. Теплоёмкость серебра от 1 до 300 K вместе с собственными $S(T)$ и $H(T)-H(0)$: источник поставляемого примера и эталон в каждом узле.
- [18] Busey R. H., Giauque W. F. The heat capacity of mercury from 15 to 330 K. Thermodynamic properties of solid, liquid and gas. Heat of fusion and vaporization // J. Am. Chem. Soc. — 1953. — Vol. 75, no. 4. — P. 806–809. Теплоёмкость ртути, теплота плавления 548,6 кал/моль и таблица термодинамических функций — источник примера с фазовым переходом внутри отрезка.
- [19] Eastman E. D., Milner R. T. The entropy of a crystalline solution of silver bromide and silver chloride in relation to the third law of thermodynamics // J. Chem. Phys. — 1933. — Vol. 1, no. 7. — P. 444–456. Теплоёмкость хлорида серебра от 15 до 292 K, 39 точек.
- [20] Pollitzer F. Bestimmung spezifischer Wärmen bei tiefen Temperaturen und ihre Verwertung zur Berechnung elektromotorischer Kräfte // Z. Elektrochem. — 1911. — Bd. 17, Nr. 1. — S. 5–14. Теплоёмкость каломели — самое слабое звено разбора: девять точек от 75 K и выше. Там же первая попытка посчитать ЭДС того же элемента из теплоёмкостей, разошедшаяся с опытом на 60 мВ, — то есть задача этого разбора поставлена в 1911 году и тогда же не решилась.
- [21] Kelley K. K., King E. G. Contributions to the data on theoretical metallurgy. XIV. Entropies of the elements and inorganic compounds. — Washington: U.S. Bureau of Mines, Bulletin 592, 1961. — 149 p. Сводка $S^{\circ}_{298{,}15}$ с разбивкой каждой величины на измеренную и экстраполированную части — отсюда взяты доли экстраполяции в таблице разбора и признание, что для каломели лучшие значения даёт ЭДС.
Выходные данные книжных изданий приведены по общепринятому цитированию; при подготовке публикации их стоит сверить по имеющемуся экземпляру.